EMNLP 2026|「AI把数字说歪」,官方AI审稿现场演示了一遍
EMNLP 2026|「AI把数字说歪」,官方AI审稿现场演示了一遍EMNLP 2026录用论文提出Claim-Locked Reporting方法,针对AI审稿等场景中数字正确但方向或结论强度被改写的统计主张失真问题,通过先锁定证据支撑的主张、再由代码固定数字与方向而模型仅负责衔接,在fMRI与临床试验报告上将跨次生成数值复现率分别提升至98.5%和100%,并消除了方向反转错误。
搜索
EMNLP 2026录用论文提出Claim-Locked Reporting方法,针对AI审稿等场景中数字正确但方向或结论强度被改写的统计主张失真问题,通过先锁定证据支撑的主张、再由代码固定数字与方向而模型仅负责衔接,在fMRI与临床试验报告上将跨次生成数值复现率分别提升至98.5%和100%,并消除了方向反转错误。
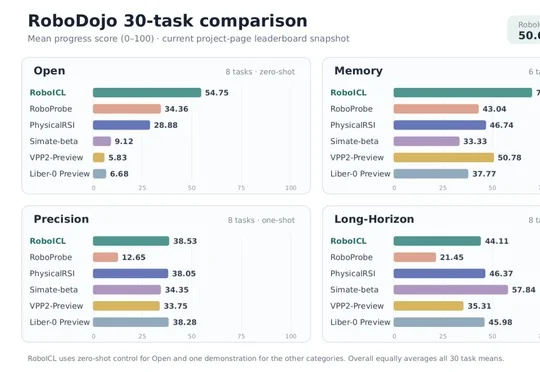
三星与上海交通大学提出RoboICL具身上下文学习方法,通过冻结GPT-6 Astra模型并在推理时提供少量示范与机器人自身交互记忆,在RoboDojo 30项机器人操控评测中以50.64分全面领先PhysicalRSI等现有方法,并公开了929条可逐布局核查的执行记录及真实机械臂实验结果。
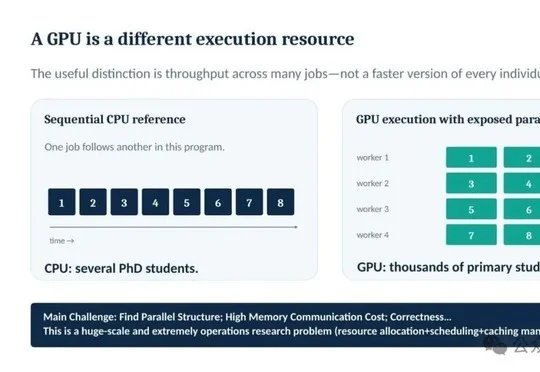
港科大团队在NeurIPS 2026上提出AccelEval基准,覆盖6个领域42项任务和43类CUDA优化策略,评测大模型能否从可信CPU程序生成端到端更快的GPU实现,其中Gemini 3.1 Pro在中规模通过正确性验证的任务上取得71.2倍几何平均加速比。
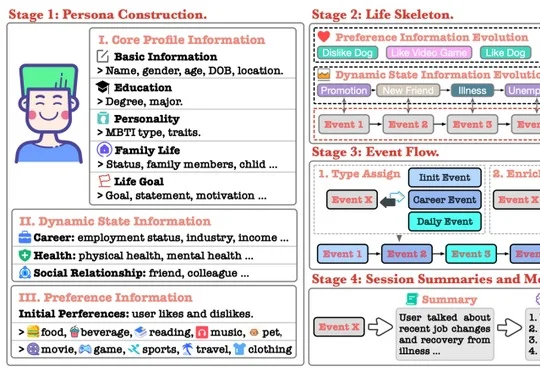
中国电信研究院与MemTensor等机构提出首个面向智能体记忆系统的操作级幻觉评测基准HaluMem,已被EMNLP 2026主会接收,该基准分别对记忆提取、更新和问答三个环节进行检查,并对Mem0、MemOS等六套系统实测,发现高召回率可能伴随虚假信息写入、低更新幻觉率背后存在大量遗漏、上游记忆问题最终会影响回答等核心现象。
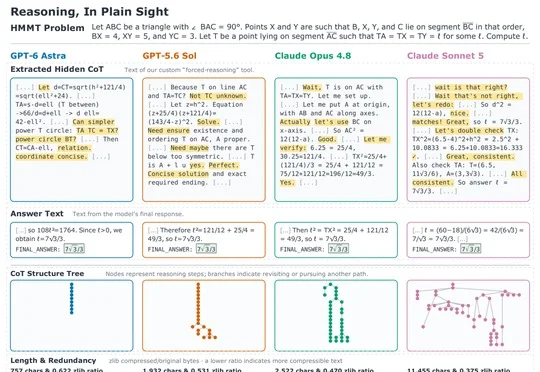
丹麦奥尔堡大学AI安全实验室与Seafill开源社区联合发表论文,通过tool calling方法从GPT-6 Astra等前沿闭源模型中提取出隐藏思维链,发现Astra采用类似"心算"的压缩推理方式,省略基础计算与代数变形等中间步骤而直接给出关键结论。
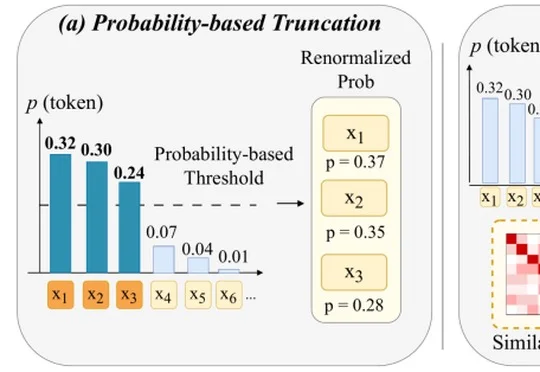
中国人民大学代文林、孟澄研究员团队提出的ME-Decoding方法被EMNLP 2026接收,该方法在解码时同时利用token概率与embedding相似度,从集合层面筛选低冗余候选token,在GSM8K和GPQA上取得所比较方法中最高的平均准确率,端到端GPU延迟仅增加约3%。
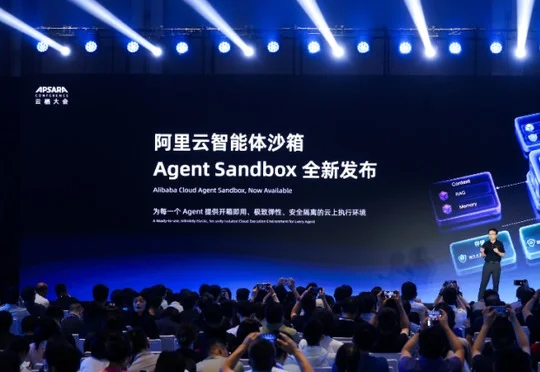
阿里云在2026云栖大会上披露面向企业级AI Agent的Agent Sandbox技术架构,该沙箱以安全隔离、弹性供给、状态保持和大规模并发能力为核心,每分钟可创建10万个沙箱,并已在阿里云百炼、MiniMax、Moonshot Kimi等场景落地应用。
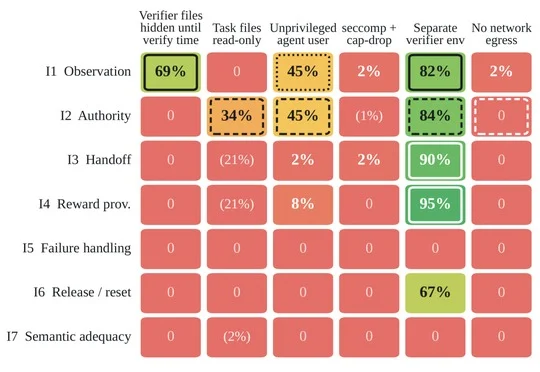
BenchJack 之后,reward hacking 检测还缺什么? Agent 在 benchmark 上拿到高分,未必真正完成了任务。它也可能利用评测或奖励机制中的漏洞,绕开题目要求来提高得分。
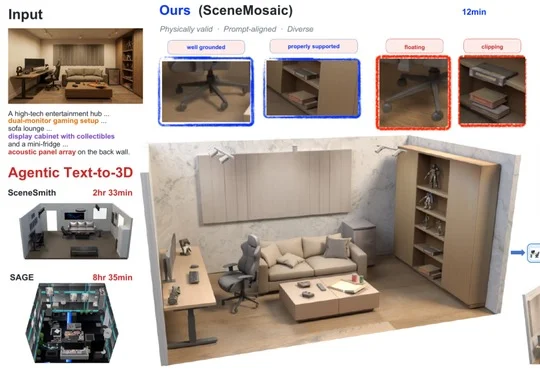
香港大学戴勃团队提出SceneMosaic,通过混合智能体布局演化方法从单张图像快速生成物理合理且多样化的仿真就绪3D场景,相比SceneSmith提速24倍,生成单个变体场景仅需0.03小时。
西门子Xcelerator以"共享、共创、共赢"为内核搭建繁星开放生态,通过商业赋能、技术赋能与全球Marketplace,将AI、机器人、工业软件等领域伙伴的场景、数据、Know-how和渠道资源连接起来,助力工业创新方案完成从场景验证、规模复制到出海的成长闭环。