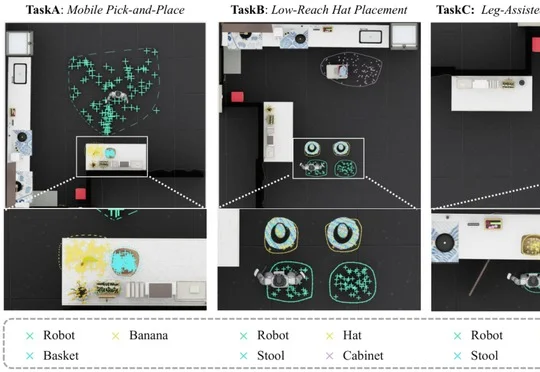
Real2Sim2Real走向人形机器人:仿真训练还缺哪两块拼图?
Real2Sim2Real走向人形机器人:仿真训练还缺哪两块拼图?Real2Sim2Real 为此提供了一条路径:将真实场景重建为仿真环境,在其中生成示范、训练策略,再将技能迁移回真实机器人。但要让这条路径支撑人形机器人的全身操作,仍需跨过两道门槛。
来自主题: AI技术研报
8327 点击 2026-11-13 17:07

 搜索
Real2Sim2Real 为此提供了一条路径:将真实场景重建为仿真环境,在其中生成示范、训练策略,再将技能迁移回真实机器人。但要让这条路径支撑人形机器人的全身操作,仍需跨过两道门槛。
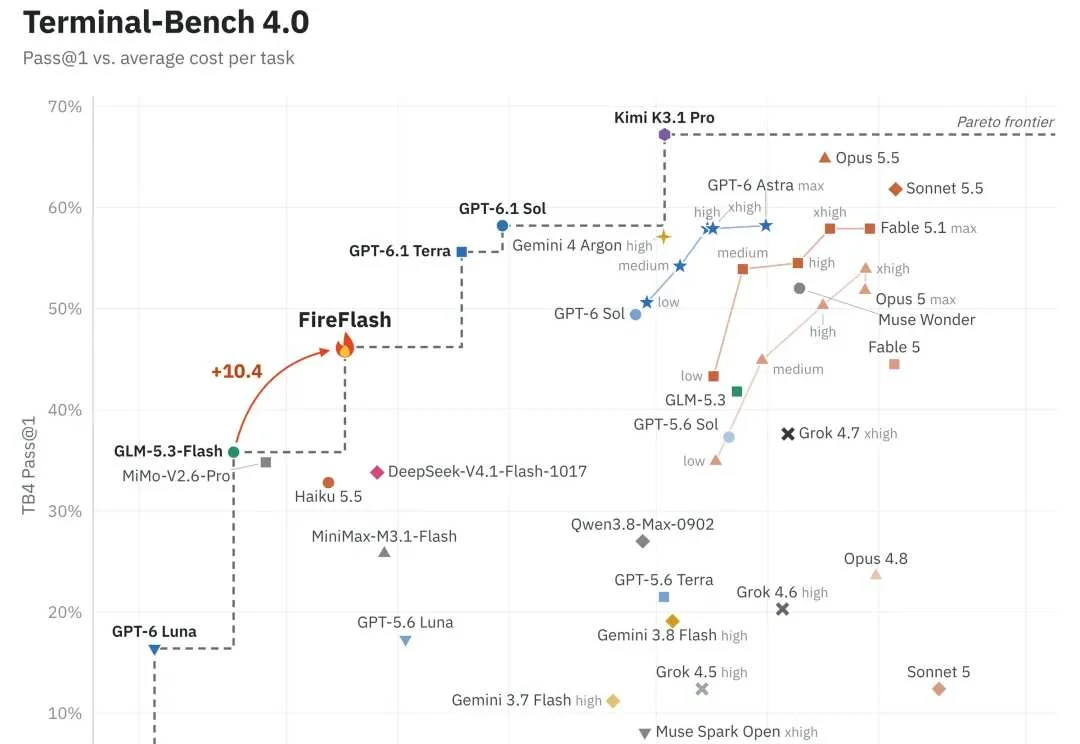
长程智能体(long-horizon agents)正从「修一个 bug」走向连续数小时的终端与编程工作,但它的强化学习训练也格外昂贵:前沿实验室可以在数千张 GPU 上扩展 RL,而对多数团队来说,一条训练样本往往就是一次长达 3 小时、上百轮工具调用的完整尝试,任何一个环节出错,浪费的都是成小时的 GPU 时间。
「刚才是谁说,打算种花?」
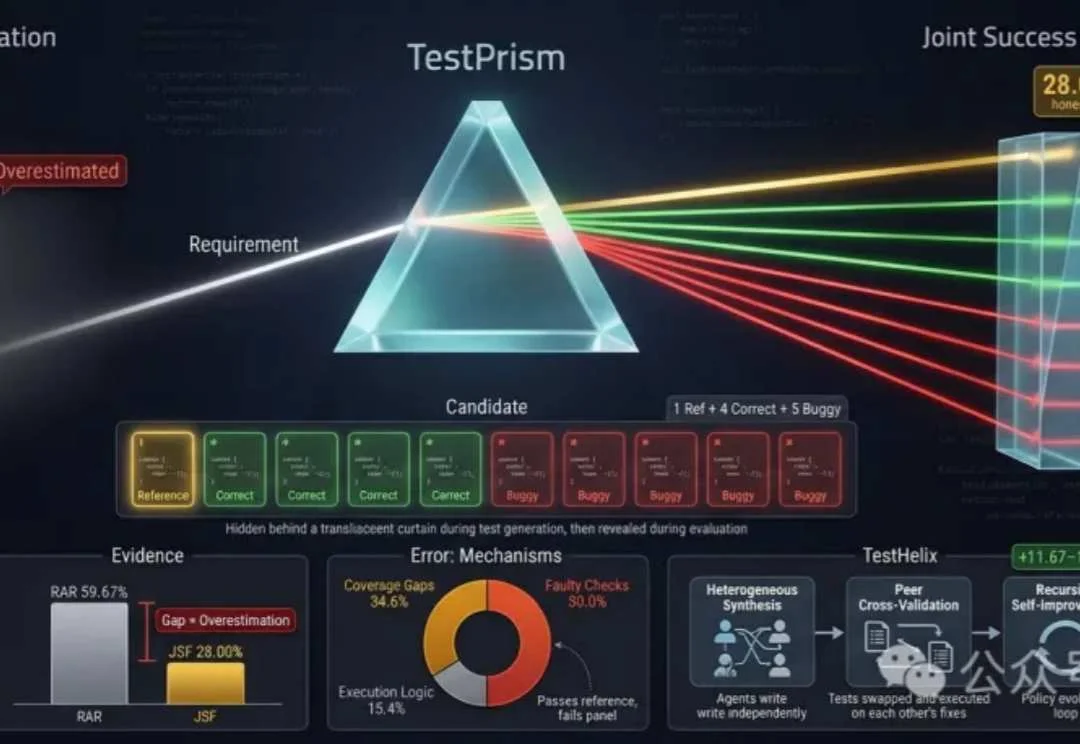
Coding Agent写代码的能力越来越强,写测试的能力也在同步提升。从为函数补单元测试、为GitHub Issue编写复现用例,到为整个代码仓库构建回归测试,Codex、Claude Code等前沿Coding Agent已经能够浏览仓库、修改实现,并借助执行反馈不断修正测试。
在机器人操作研究中,视觉语言动作模型(Vision-Language-Action,VLA)与世界动作模型(World Action Model,WAM)为机器人提供了不同的动作生成路径。但当任务从一次抓放延伸到连续搭建与双臂协同,决定成败的就不只是眼前这个动作能否完成,还包括此前建立的条件能否一直支撑后续执行。
设想一个客服系统,每秒涌进成百上千条用户请求。
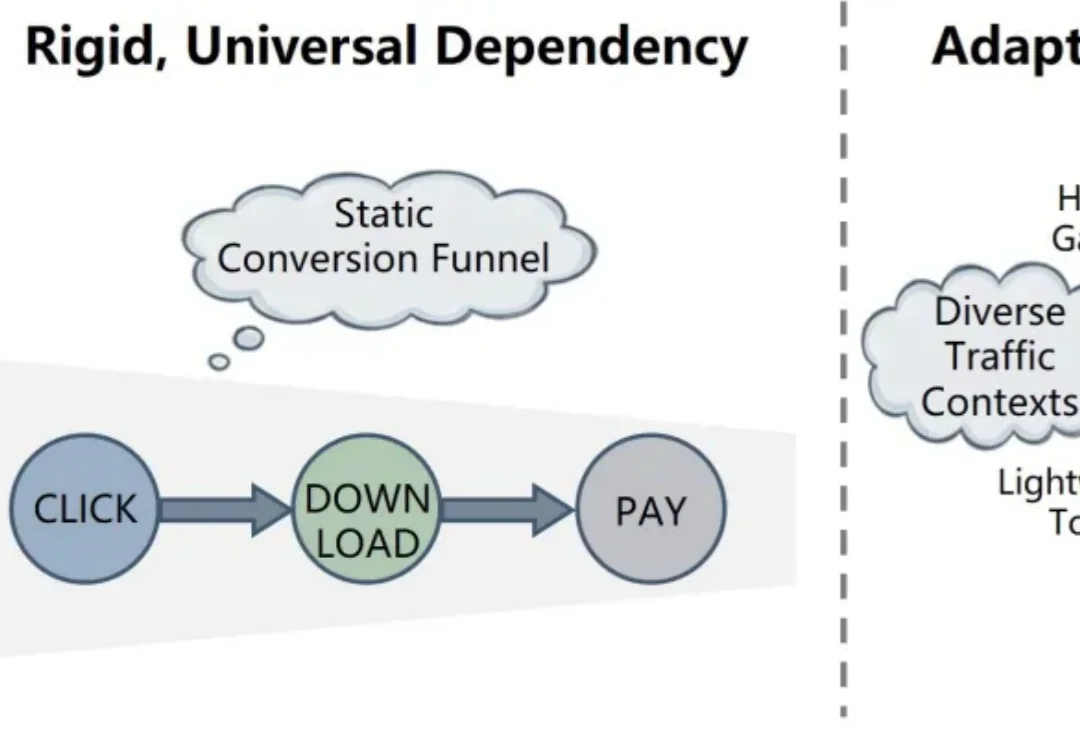
工业推荐的优化重心,已经从单一交互指标转向整体eCPM(每千次曝光收益)。
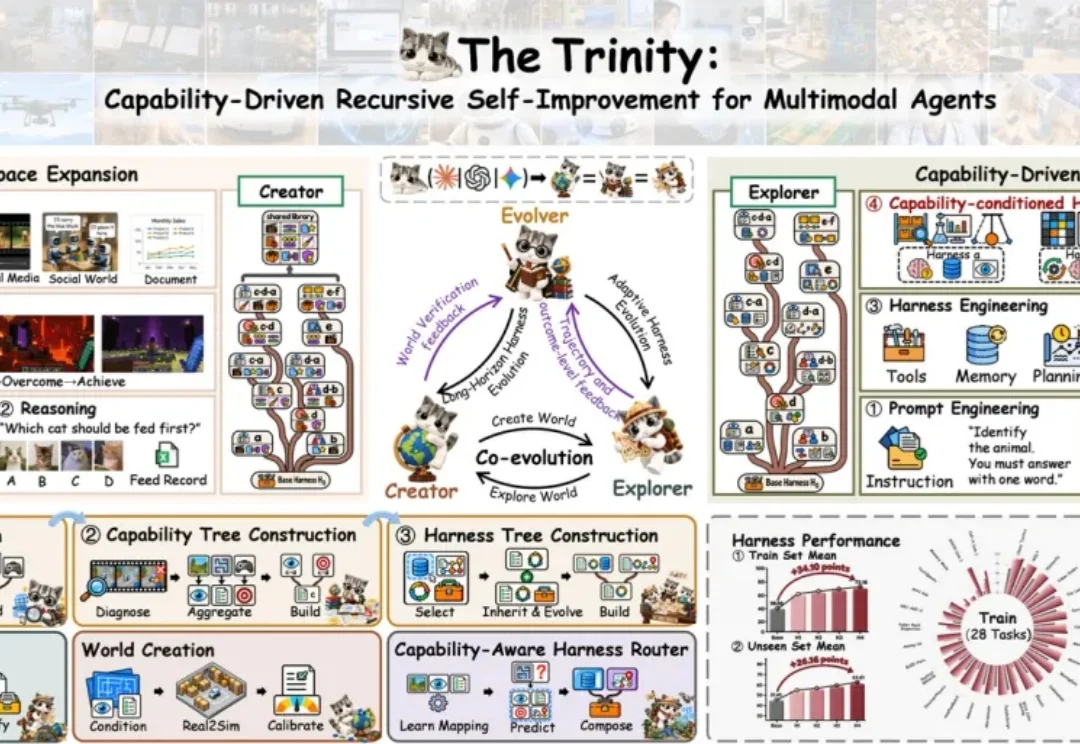
改变 RSI 的基本演化单位,从任务转变为能力,有望从针对具体任务的局部优化,走向跨任务、跨模态的持续演化。
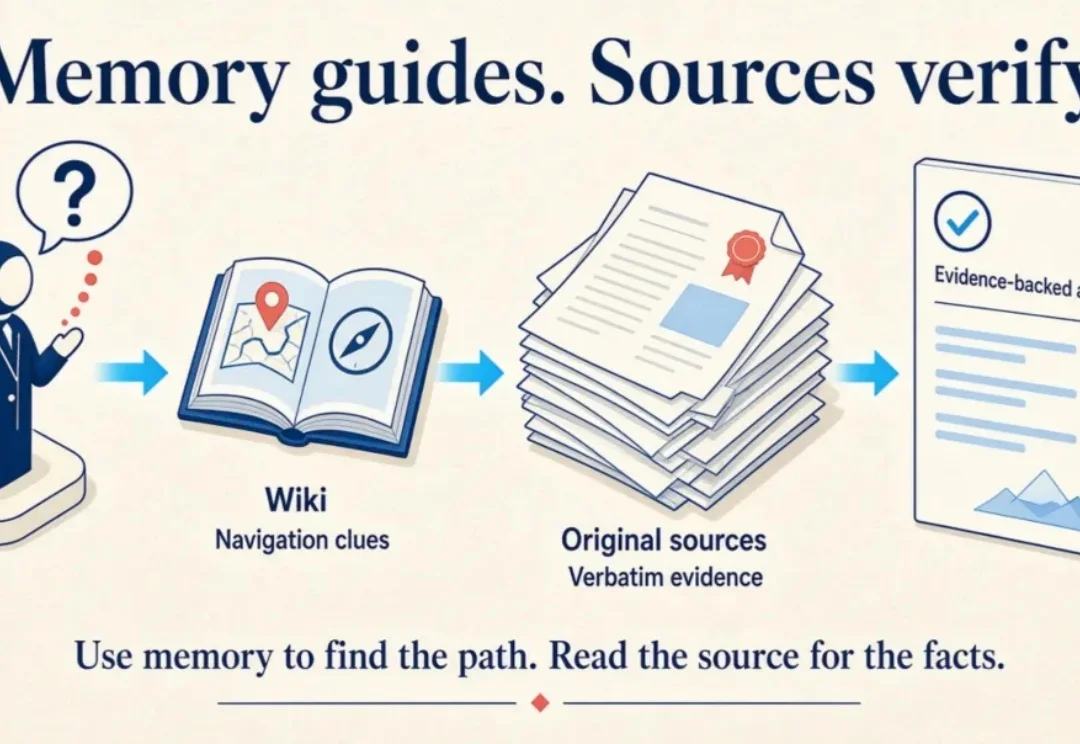
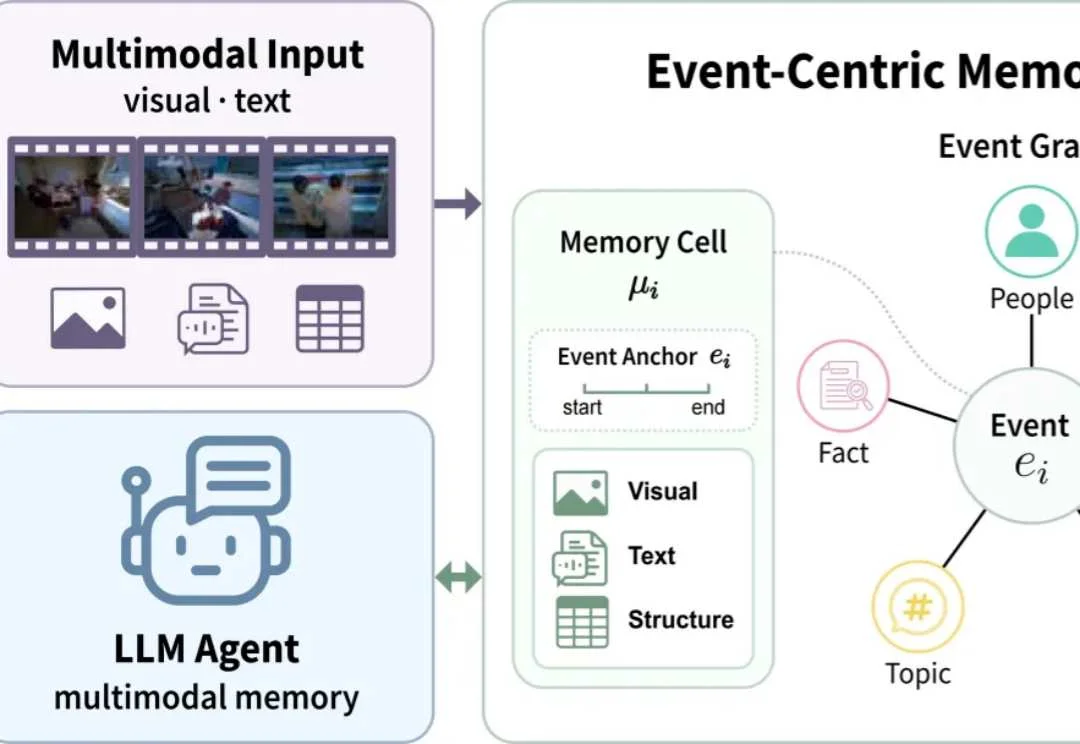
前不久,Anthropic 的工程团队在 11 月 6 日发了一篇文章《The components of agent memory》。里面有一个非常有意思的观察:很多被精心设计过的知识wiki或者Agent Memory准确率有时候还不如直接搜索原始文档高。但换个场景,过多的原始信息塞给模型,有时候也同样会让检索的准确率暴跌。
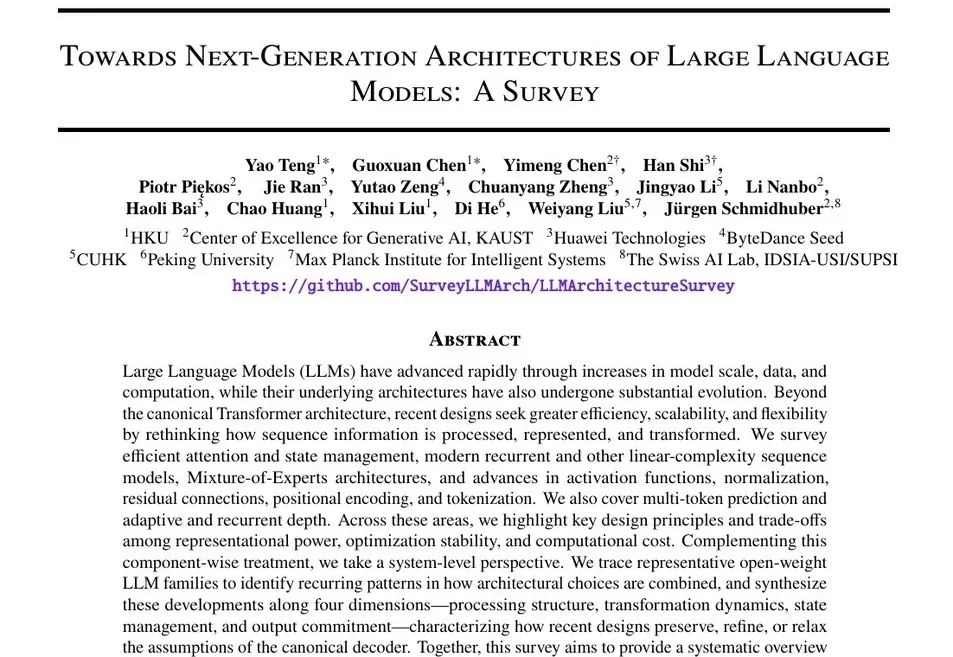
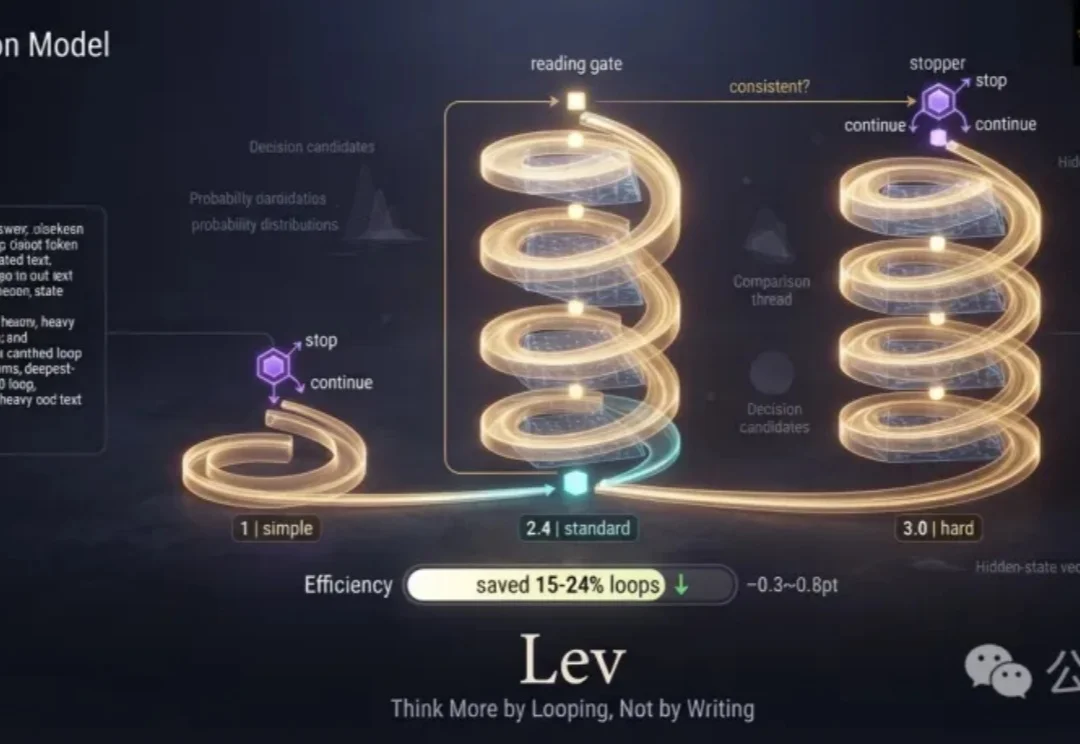
Scaling up 是大模型的标志,也引领了近几年语言模型技术的飞跃。然而实际上,大语言模型架构,作为其最本质的计算基础,也在近年来持续发展。