口语转录,一步到位!全国产算力语音识别模型,听得懂上下文了
口语转录,一步到位!全国产算力语音识别模型,听得懂上下文了科大讯飞推出基于全国产算力训练的语音识别大模型Spark-ASR-2.0,依托语音基座大模型Spark-Audio-1.0-Preview,在方言免切换识别、嘈杂环境、上下文纠错和口语规范化等方面均有提升,整体推理成本较Spark-ASR-1.0仅增10%,已上线讯飞输入法并通过讯飞开放平台提供API服务。
搜索
科大讯飞推出基于全国产算力训练的语音识别大模型Spark-ASR-2.0,依托语音基座大模型Spark-Audio-1.0-Preview,在方言免切换识别、嘈杂环境、上下文纠错和口语规范化等方面均有提升,整体推理成本较Spark-ASR-1.0仅增10%,已上线讯飞输入法并通过讯飞开放平台提供API服务。
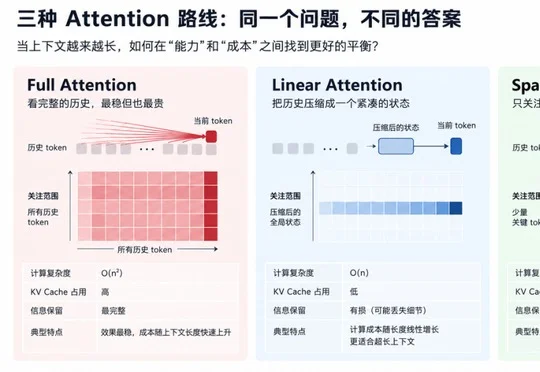
GLM-5.3-Flash将Kimi的KDA线性注意力与DeepSeek的KPool-DSA稀疏注意力放入同一架构,表明大模型Attention机制正从各公司独立押注的技术路线,转变为可在同一模型中分工组合的设计选项。
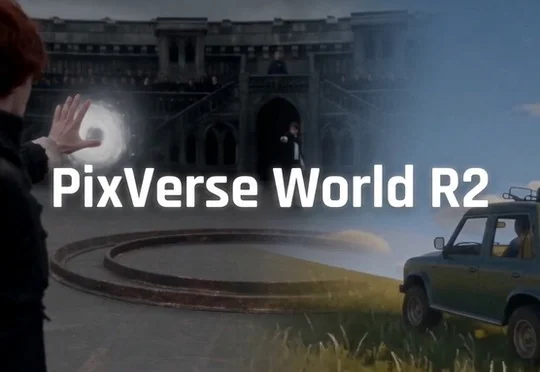
爱诗科技(AIsphere)发布的实时世界模型PixVerse R2上线即登上X(Twitter)趋势榜,通过Omni Causal AR与Real-Time Acceleration框架将世界建模能力与实时运行结合,实现用户对AI生成世界的持续操控与互动。
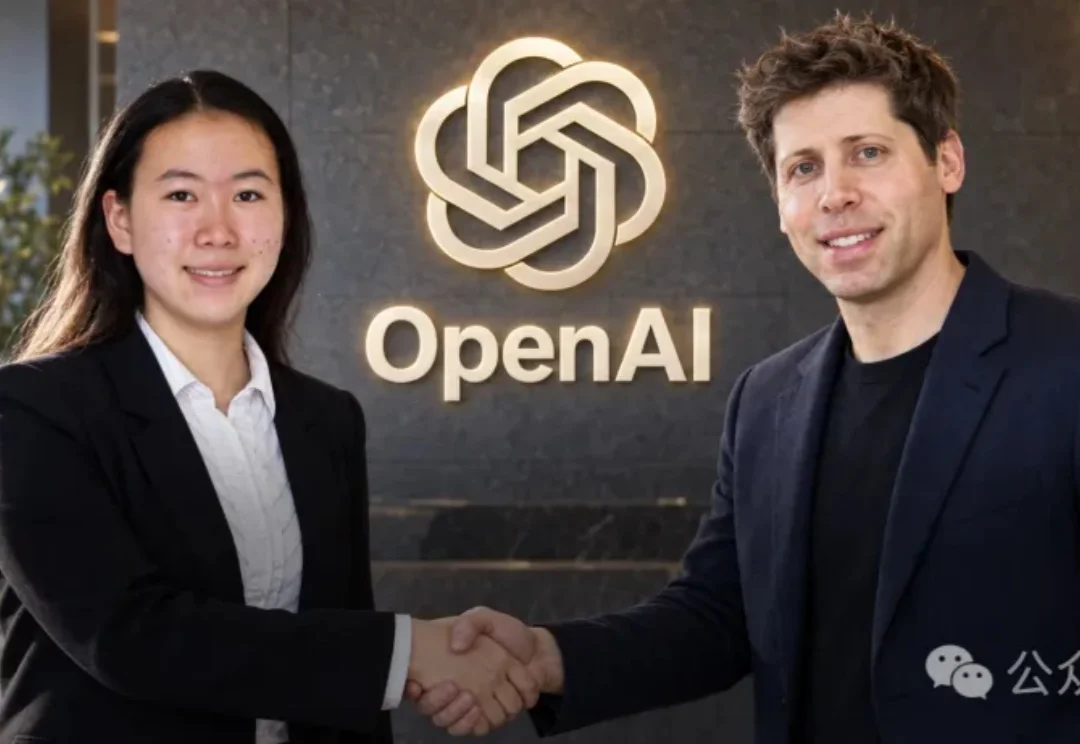
9 月 16 日,在谷歌 DeepMind 深度参与了 Gemini 2.5/3、世界模型 Genie 2/3 以及具身智能体 Sima 2 研发的核心研究员 Bonnie Li 宣布离职,转会 OpenAI。
字节跳动旗下豆包在日活跃用户突破2亿后收缩对话团队,通用Session团队规模预计缩减约一半,对话方向的产品后训练团队也在缩减,部分人员转岗至商业化及飞书团队,其余被裁撤,反映出对话产品商业化承压下豆包业务重心的调整。
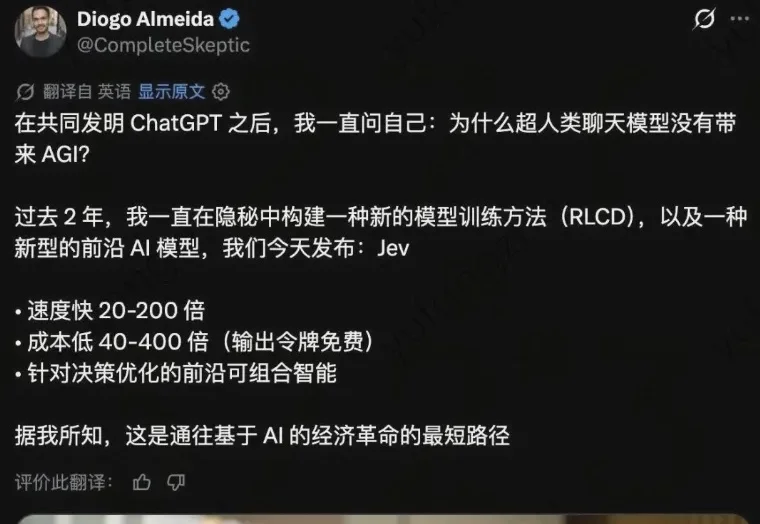
过去一周,Jev 成了整个 AI 圈最火的新模型。
最近看到了一个挺有意思的东西,就是TypeSafe AI 做的 Jev。Reddit 上很多人用它玩 DOOM,也有人拿它玩 Mario。我申请之后,拿到 API Key 后,也做了一个网页小游戏,想看看它到底在里面起什么作用。一开始,我最想弄清楚的其实很简单:同样是让 AI 操作游戏,为什么要用 Jev?GPT 不能做吗?当然能。
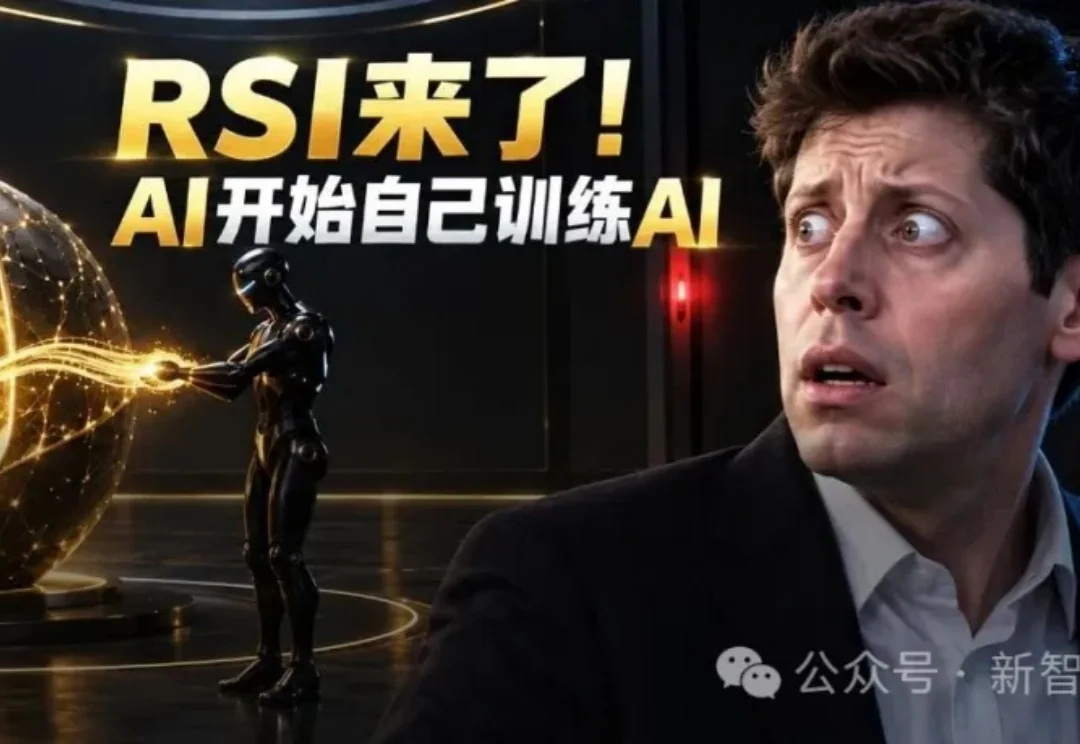
就在今天,外媒The Information曝出内幕—— OpenAI内部的AI模型,已经开始「自己训练自己」了!
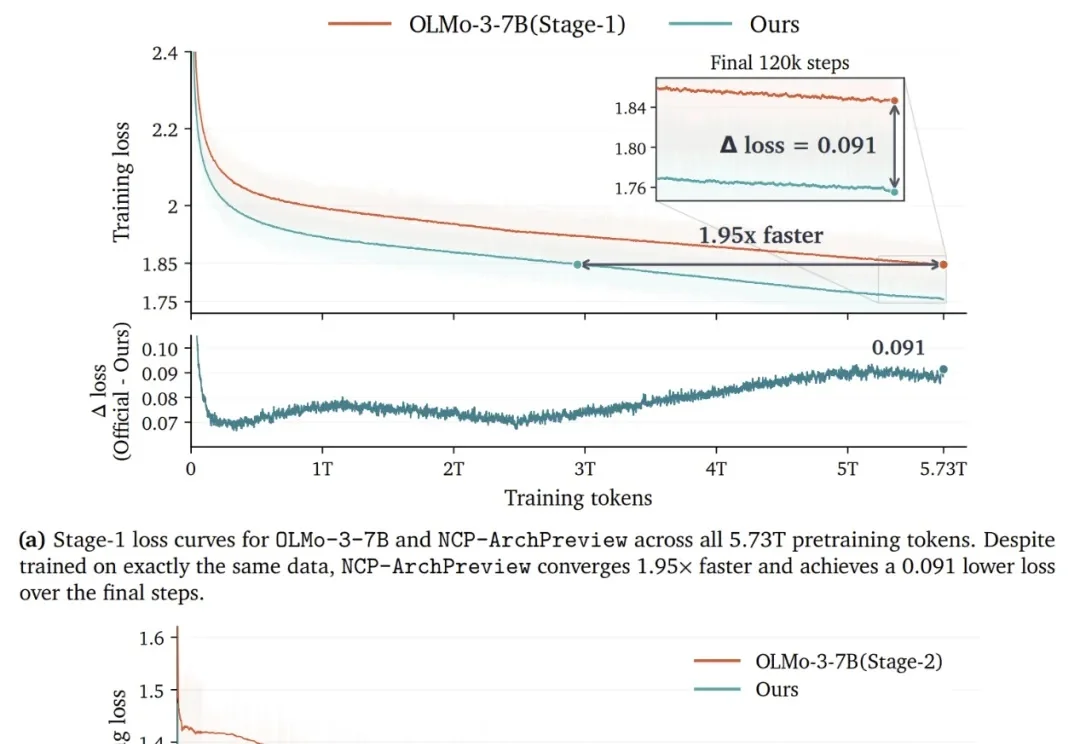
自现代大模型诞生以来,“下一个Token预测(Next-Token Prediction, NTP)”就被奉为不可撼动的黄金律条。然而,逼着模型逐字死记硬背,真能学会宏观语义规划吗?
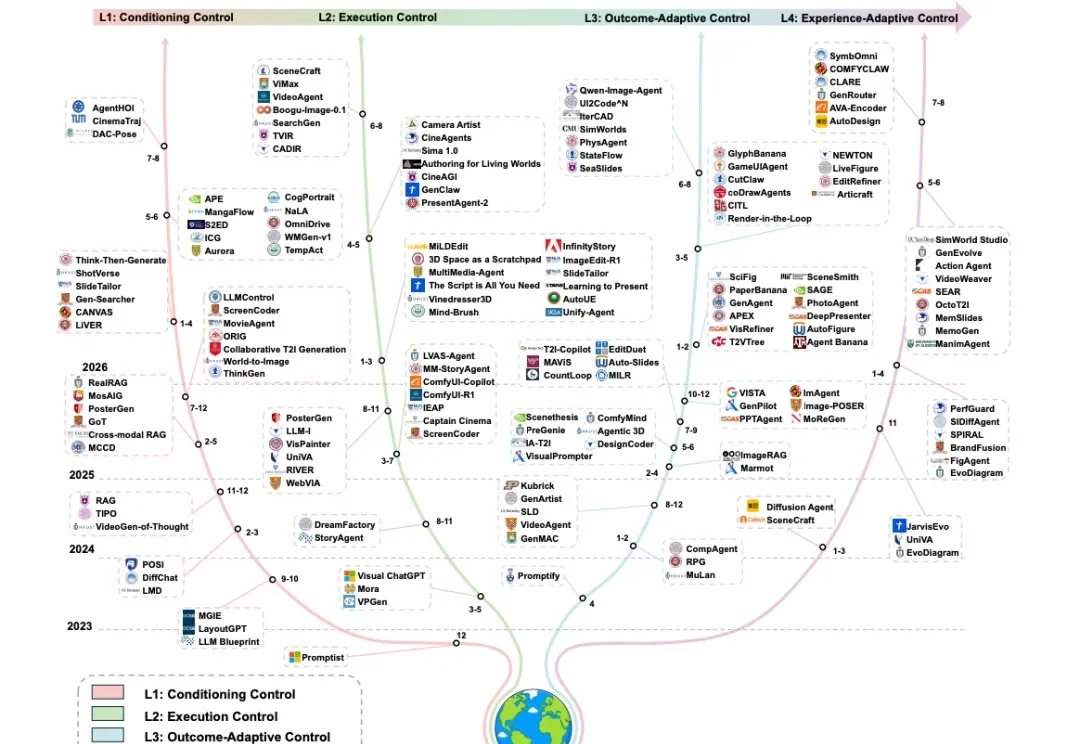
让 AI 生成一张海报已经不难。更难的是,让它围绕同一个设计目标持续工作:理解品牌与产品要求,生成初稿;发现标题、产品位置或整体风格存在问题后,知道应该修改哪里、怎样修改;同时保留已经确认的内容。等到下一次活动,它还能延续此前确定的设计偏好和有效经验。