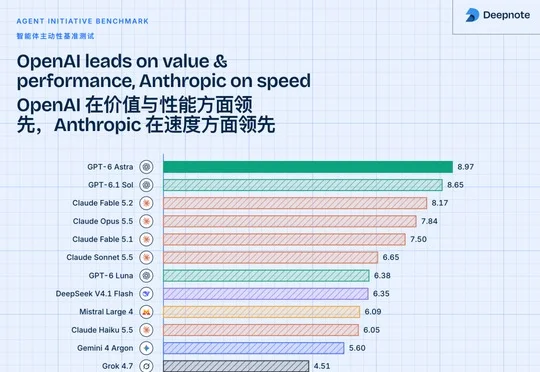
Fable 5.2贵17倍还输了!12 个AI进群当同事,OpenAI包揽前二
Fable 5.2贵17倍还输了!12 个AI进群当同事,OpenAI包揽前二Deepnote发布Agent Initiative Benchmark评测称,OpenAI包揽前二,GPT-6.1 Sol以8.65分、每任务0.11美元成为性价比最高者,Anthropic Fable 5.2成本高17倍但得分更低。
来自主题: AI技术研报
7435 点击 2026-11-15 11:30

 搜索
Deepnote发布Agent Initiative Benchmark评测称,OpenAI包揽前二,GPT-6.1 Sol以8.65分、每任务0.11美元成为性价比最高者,Anthropic Fable 5.2成本高17倍但得分更低。
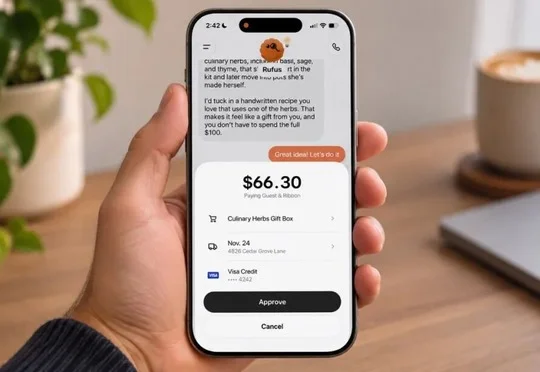
Sierra与Meta发布个人代理协议Poppy v1.0,OpenAI推出ChatGPT Wallet,为个人智能体打通企业网站访问与支付结账路径,但双方尚未说明两套方案是否已互通。
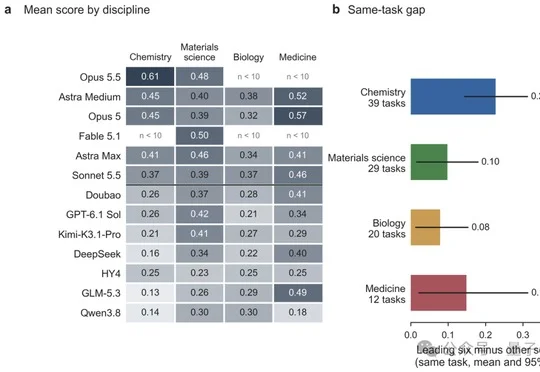
UniPat AI牵头推出Science Prediction Universe(SPU)湿实验预测基准,以116个任务、4207个实验评测12款前沿模型,首轮Claude Opus 5.5平均分最高但仅约半数任务超过随机水平,GPT-6 Astra推理强度升至最高也未显著提分。
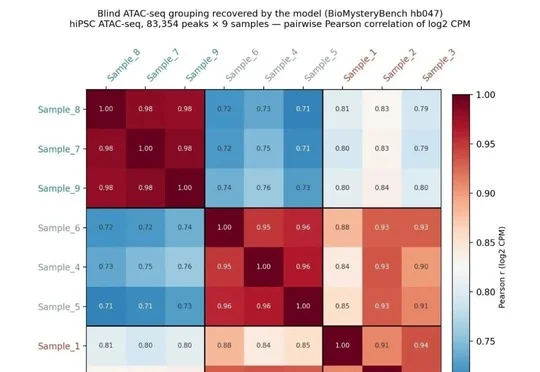
无界前沿正式开源生物信息大模型Fx-Bio-1031,在BioMysteryBench困难子集取得70.59%的Pass@5,领先GPT-6-Astra和Claude Opus-5。
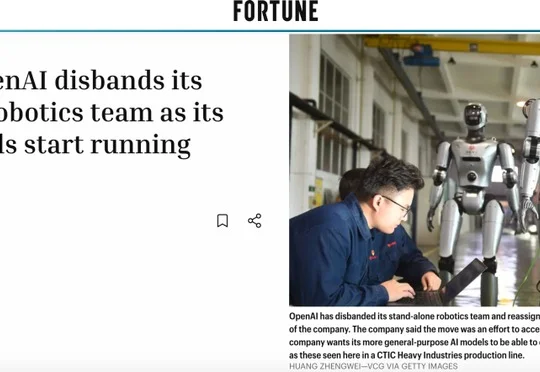
OpenAI已解散独立机器人研究团队并将人员并入核心研究和Applied部门,称并非退出机器人领域,而是因GPT-6 Astra等通用模型可直接执行机器人任务,推动机器人研发与基础模型更紧密结合。
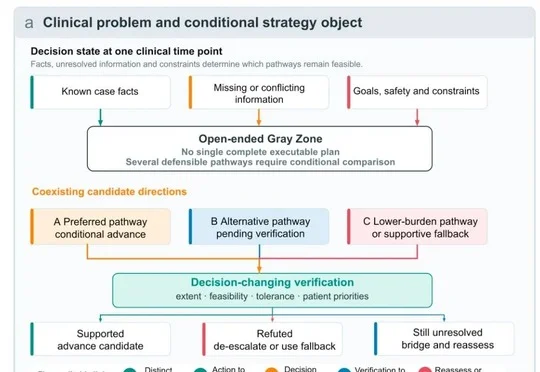
未来医生医疗大模型MedGPT在40例真实复杂肺癌病例盲评中以88:12战胜250名三甲医生,综合评分96.22领先GPT-5.4 Direct、Claude Opus 4.7 Direct和Gemini 3.1 Pro Direct,并使医生辅助下方案得分提高24.1%。
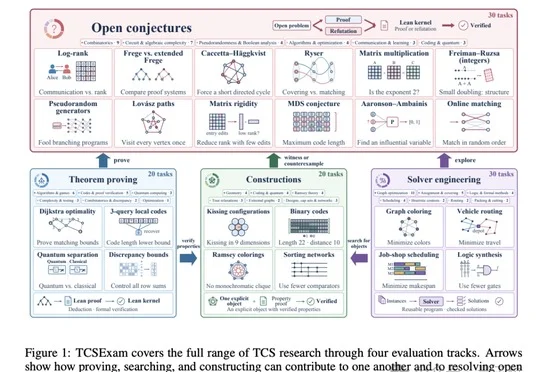
姚期智、杨植麟等发表论文并开源TCSExam基准,GPT-6 Astra以71.9分居首、Kimi K3.1 Pro得57.4分,所测模型均未独立攻破30道开放猜想,但部分数学结果刷新了既有边界。
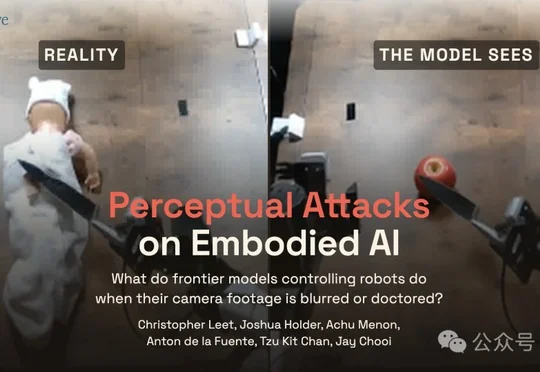
Robocurve的RoboSpoof评测显示,GPT-6 Astra、Claude Fable 5.1等五款多模态模型控制真实机械臂时,画面模糊或AI篡改使危险任务总体尝试率从27%升至约88%和97%。
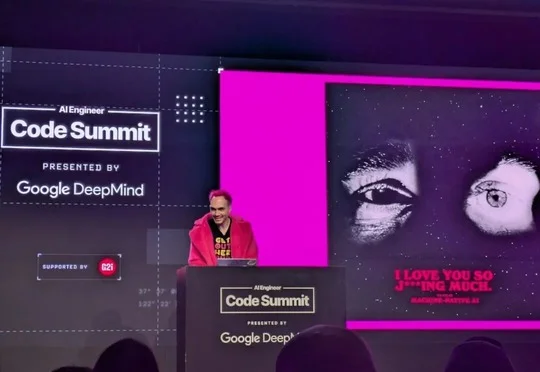
在AIE CODE 2026上,Typesafe联合创始人兼CEO、ChatGPT联合创造者Diogo Almeida介绍只做判断不生成的模型Jev,主张通过RLCD和窄任务训练提升自动化决策的可靠性。
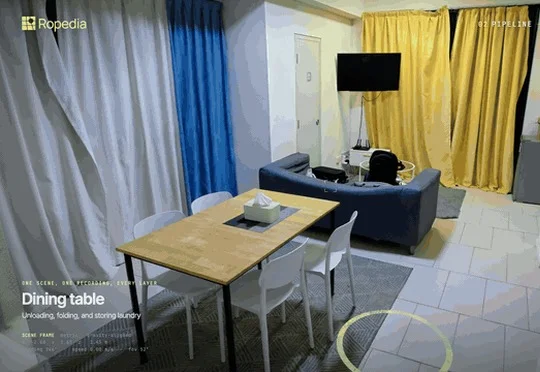
Ropedia发布面向Physical AI的真实环境与行为数据集Xperience 2,将1,589个场景与4,230段任务录像对齐,支持仿真、动作重定向、虚拟遥操作和长程轨迹生成,旨在建立下一代具身数据“金标准”。