图灵奖得主与月之暗面创始人联手,给AI大模型出了一套“科研能力考卷”,谁在真干活?
图灵奖得主与月之暗面创始人联手,给AI大模型出了一套“科研能力考卷”,谁在真干活?月之暗面(Moonshot AI)创始人杨植麟联合清华大学及图灵奖得主姚期智团队推出TCSExam,以机器核验的科研交付物评测大模型,GPT‑6 Astra居Full榜首,开放猜想有效解答仍依赖联网检索改编。
来自主题: AI技术研报
8787 点击 2026-11-13 17:09

 搜索
月之暗面(Moonshot AI)创始人杨植麟联合清华大学及图灵奖得主姚期智团队推出TCSExam,以机器核验的科研交付物评测大模型,GPT‑6 Astra居Full榜首,开放猜想有效解答仍依赖联网检索改编。
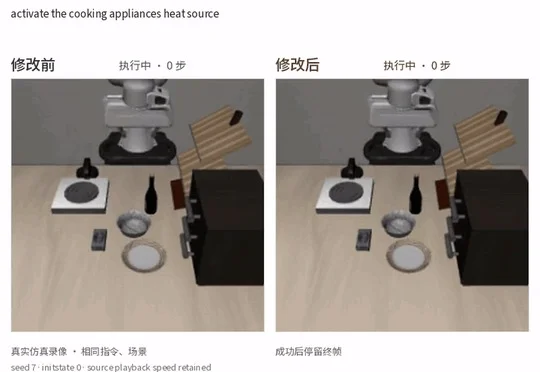
斯坦福研究团队让GPT-6 Astra直接修改π₀.₅机器人策略的65行词嵌入,将765条留出指令的整体成功率从86.3%提升至92.0%,但仍有4个回合退化且结果仅限仿真。
上海交通大学赵海教授团队在arXiv发布BriLLM-MetaPred,首次将AGI数学理论推导的MetaPred原语落地为可运行语言模型,其在约13.2M参数规模下的预测性能与同规模GPT基线相当。
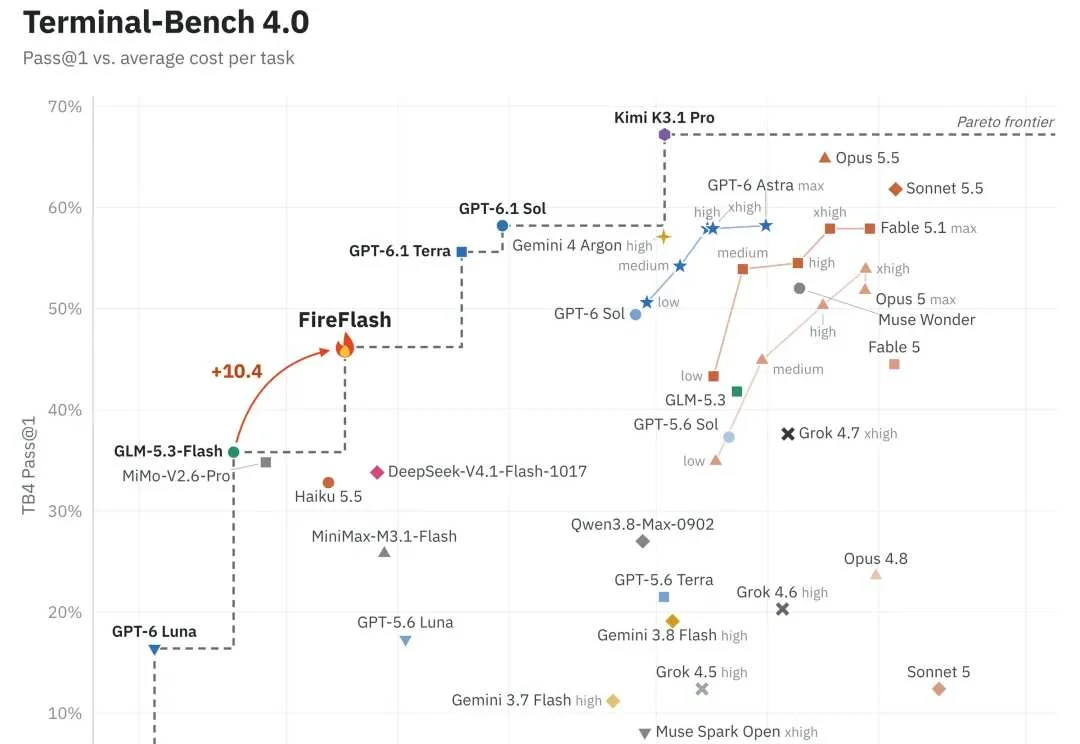
长程智能体(long-horizon agents)正从「修一个 bug」走向连续数小时的终端与编程工作,但它的强化学习训练也格外昂贵:前沿实验室可以在数千张 GPU 上扩展 RL,而对多数团队来说,一条训练样本往往就是一次长达 3 小时、上百轮工具调用的完整尝试,任何一个环节出错,浪费的都是成小时的 GPU 时间。
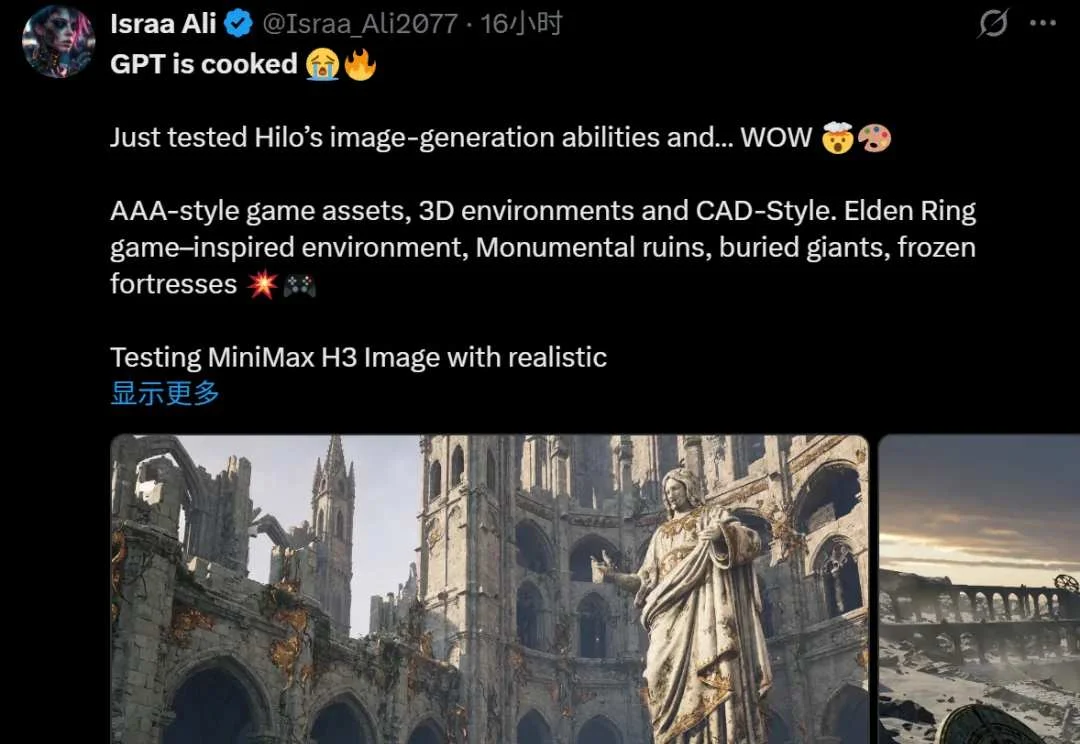
「GPT is cooked.」
上个月,微软在《科学》杂志上甩出一篇论文:自家AI诊断系统诊断正确率83%,对照组的全科医生只有36%。
继 Apex-35B-V1.0 凭借领先 Flint 的表现引发关注之后,开源 RSI 模型又迎来一份亮眼成绩单:REMORY 仅凭一个 1.9B 的记忆模块,用两张 H800 实现完全自监督训练,在多项关键评测中领跑;驱动小模型持续数日递归改进,产出接近 GPT-6.1-Terra。
小时候想拥有一台 Game Boy,长大后想自己做一款 Game Boy 游戏,没想到 OpenAI 准备同时实现你这两个愿望。
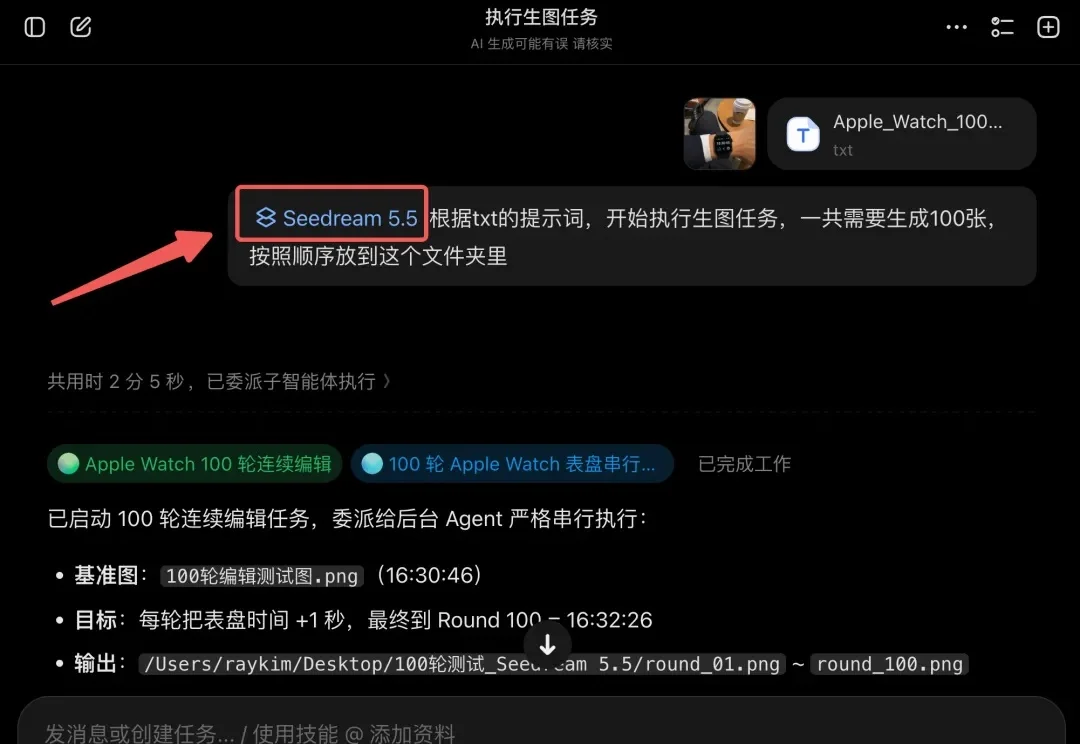
说真的,即便强如新出的GPT-Image 2.6,遇到连续编辑100轮图像这种高压任务,也得大喊那句“名人名言”: 我画地为牢啊,厉娜!
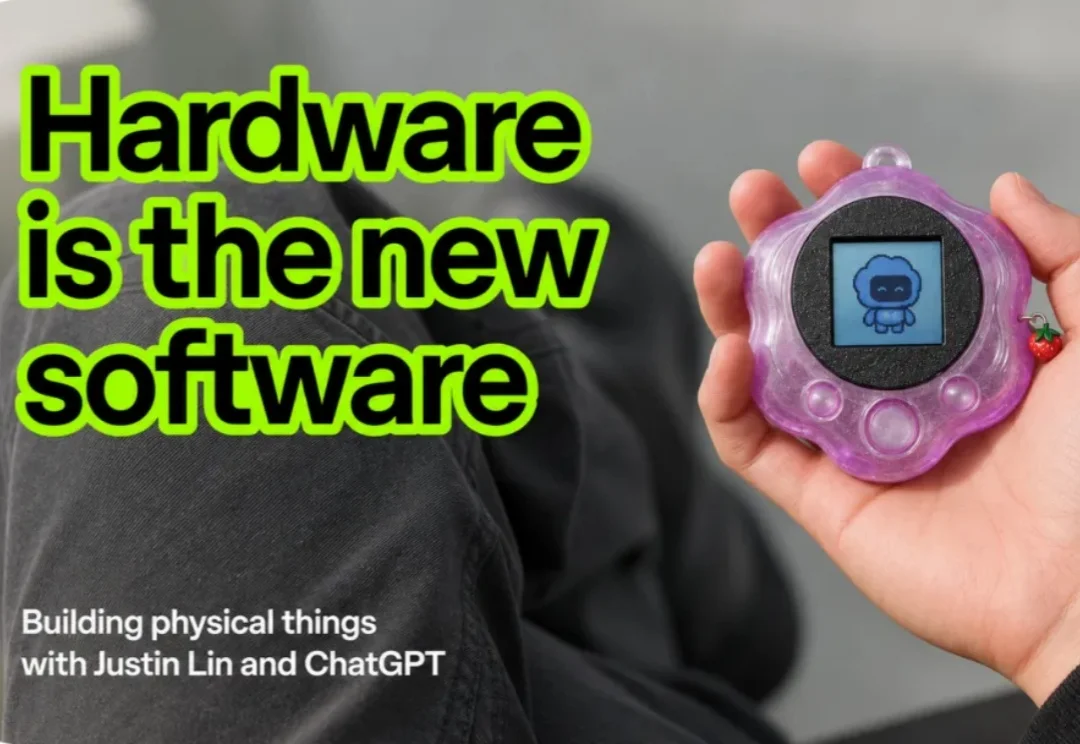
这是一台看起来像电子宠物的紫色设备,有屏幕、有实体按键,旁边还挂着一颗小草莓。用户可以拿起它,直接用语音和 Codex 对话。