NeurIPS 2026|扩散模型和自回归模型谁的隐私泄露更多? 奥尔堡大学揭示扩散语言模型的记忆行为
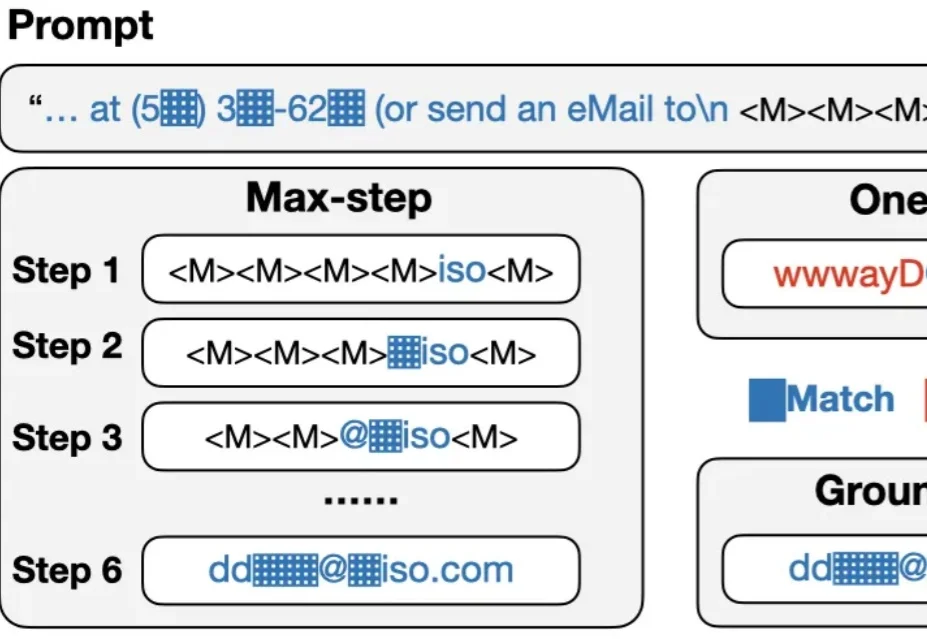
NeurIPS 2026|扩散模型和自回归模型谁的隐私泄露更多? 奥尔堡大学揭示扩散语言模型的记忆行为大语言模型有时会把训练时见过的内容原样「背出来」,其中可能包含邮箱、电话号码等个人信息。随着扩散语言模型走向更大规模,一个问题也随之出现:当模型不再从左到右逐词生成,它还会以同样的方式泄露训练数据吗?
来自主题: AI技术研报
7039 点击 2026-11-16 15:12

 搜索
大语言模型有时会把训练时见过的内容原样「背出来」,其中可能包含邮箱、电话号码等个人信息。随着扩散语言模型走向更大规模,一个问题也随之出现:当模型不再从左到右逐词生成,它还会以同样的方式泄露训练数据吗?
中国具身智能公司维他动力(Vbot)发布跨视角生成模型Exo2EgoPolicy,并推出全面开放的Vbot Echo与Echo App,将第三人称视频转换为第一人称、手部骨骼及机器人训练数据。
OpenAI、Anthropic背后的“数据工厂”。
Firefly 在 NeurIPS 2026 提出“先探索、后出题”的训练数据合成流程,利用真实 MCP Server 和可离线复现的检索增强模拟器生成5,144个可验证任务,使 Qwen3-4B-Thinking-2507 的 pass@1 从28.1%升至41.5%。
Thinking Machines Lab发布Inkling 2 Small,并正以400亿美元投前估值筹集50亿美元;其训练数据部分采样自月之暗面Kimi K3,AA称权重放出后将成为中国以外得分最高的开放权重模型。
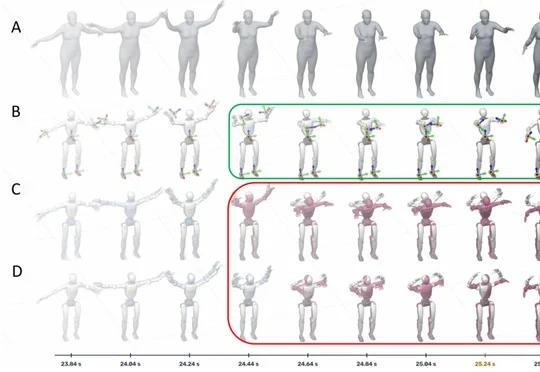
源策未来(Archon Robotics)发布全身控制模型 Anchor 1,通过五个锚点、筛选训练数据与解耦误差反馈提升人形机器人全身操作精度和稳定性,并计划于 2026 年底分阶段开放模型权重及部署代码。
具身智能不缺钱,也不缺演示,真正稀缺的是一条能复现的 Scaling 曲线。去年 11月,北美的 Generalist 发布 GEN-0,称首次在机器人身上观察到了这条曲线:预训练数据和算力越多,模型在下游任务上的表现就越稳定、可预测地提升。支撑这条曲线的,是超过 27 万小时的真实世界操作数据,和每周新增上万小时的采集速度。对绝大多数公司来说,曲线已经有人跑出来了,燃料却还没有。
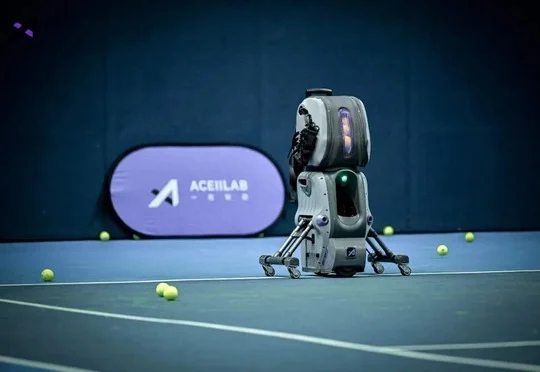
一思科技旗下 AceiiLab A1 通过沿底线移动喂球、球童模式、AI 动作分析和训练数据服务提供互动陪练,首批量产机今年 7 月开始交付。
《The Verge》报道,Mercor、Scale AI 和 Surge AI 招募律师、编剧、教师等专业人士生产 AI 训练数据,使劳动者在教 AI 取代原有工作的同时,面临项目骤停、严密监控、降薪和技能被模型掌握后需求消失的困境。
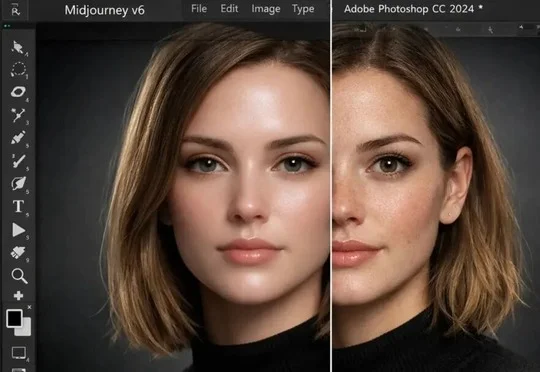
文章指出,AI常生成美女,是因为模型倾向生成接近数据分布中心的平均脸,而人类更偏爱平均脸,训练数据偏置、用户点击、奖励模型与商业激励进一步强化了这一反馈循环。