NeurIPS 2026 | 港大提出RaPO:强化微调破解MLLM灾难性遗忘,代码已开源
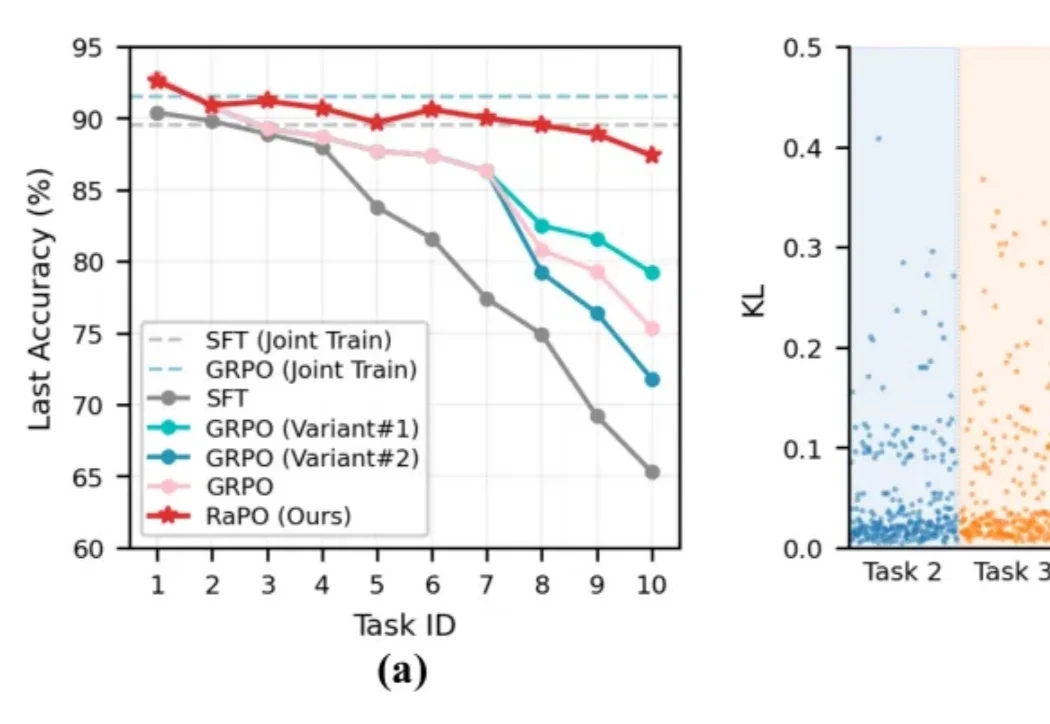
NeurIPS 2026 | 港大提出RaPO:强化微调破解MLLM灾难性遗忘,代码已开源在 LLM/MLLM 领域,基于 verifier 奖励的强化微调(Reinforcement Fine-Tuning, RFT,如 GRPO)在激发复杂推理能力方面展现出显著优势。由于 On-policy 优化的特性,很多研究指出 RFT 相比传统的监督微调(SFT)天然具备更强的抗遗忘能力。
搜索
在 LLM/MLLM 领域,基于 verifier 奖励的强化微调(Reinforcement Fine-Tuning, RFT,如 GRPO)在激发复杂推理能力方面展现出显著优势。由于 On-policy 优化的特性,很多研究指出 RFT 相比传统的监督微调(SFT)天然具备更强的抗遗忘能力。
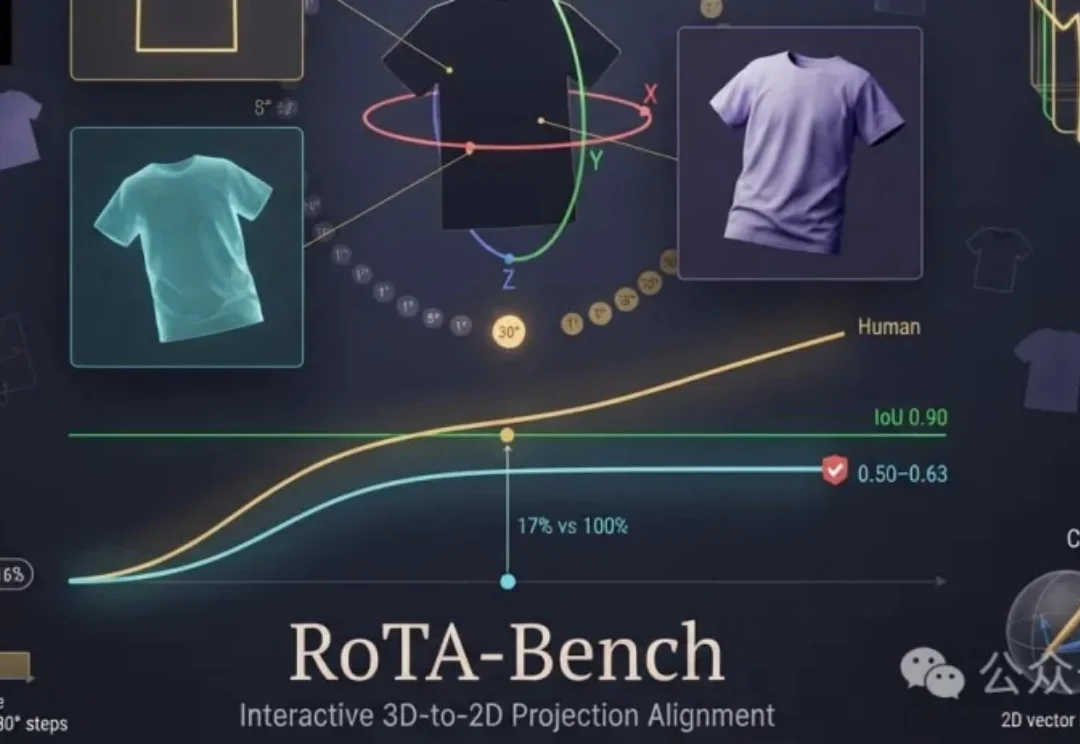
认出一个物体之后,换个角度还能认出来,进一步想象它转动后的样子,这些都涉及空间感知。人类需要在头脑中表示物体的形状与方向,理解不同视角之间的关系,并从二维投影中推断三维几何。
Sören Mindermann与Alan Chan牵头、包括Geoffrey Hinton在内的22位学者共同署名的RSI论文提出,在AI研发完全自动化等假设下,研发速度可能在约一年半内提高十倍,但这并非现实时间预测。
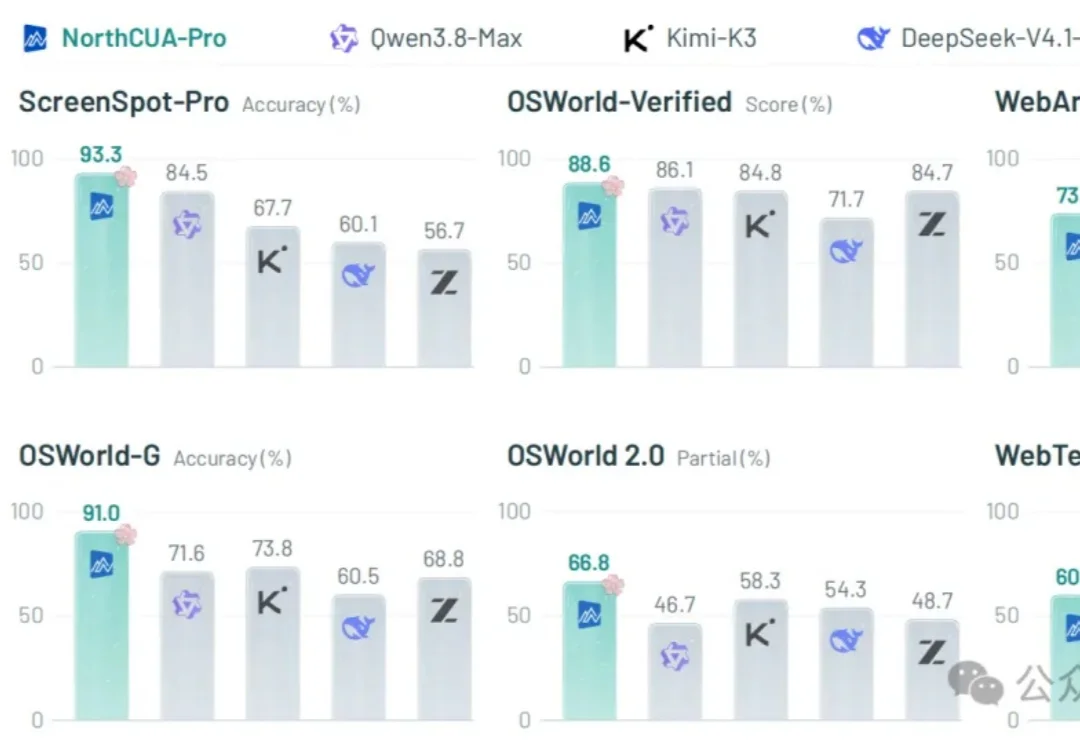
周二,北坡的 NorthCUA 团队,突然带来了一套相当完整的电脑智能体开源成果。
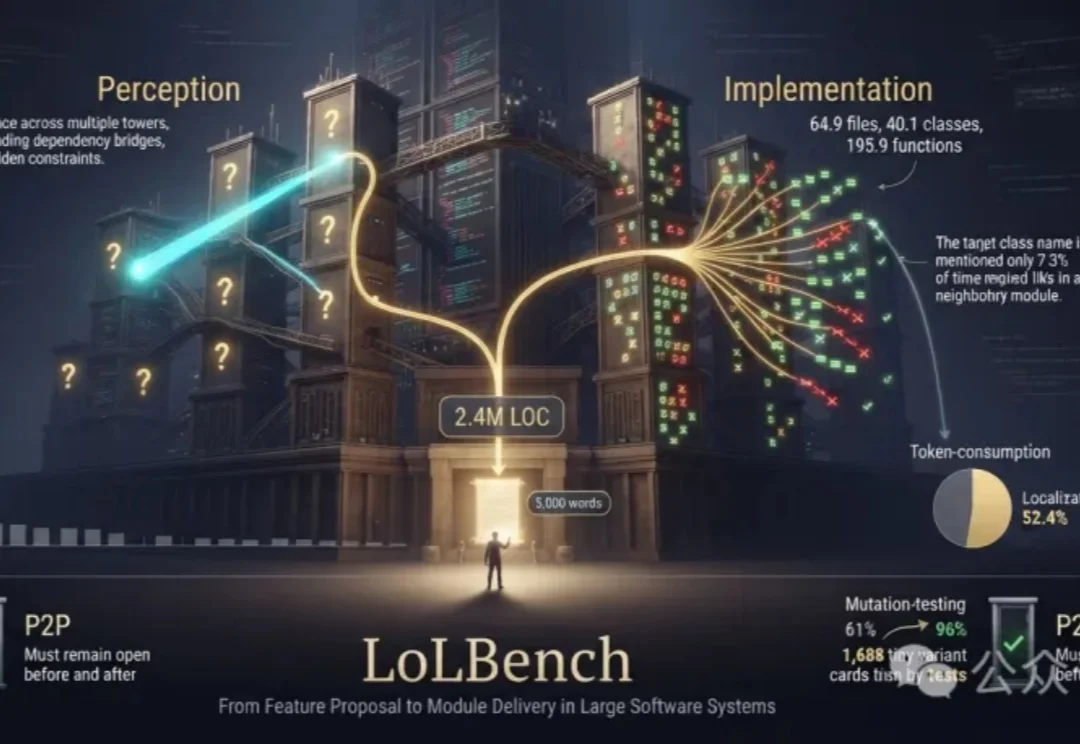
如今Agent已经能熟练调用工具、修改文件、运行测试,但面对一个长期演进的大型软件系统,它能否从一份新需求出发,交付完整功能?
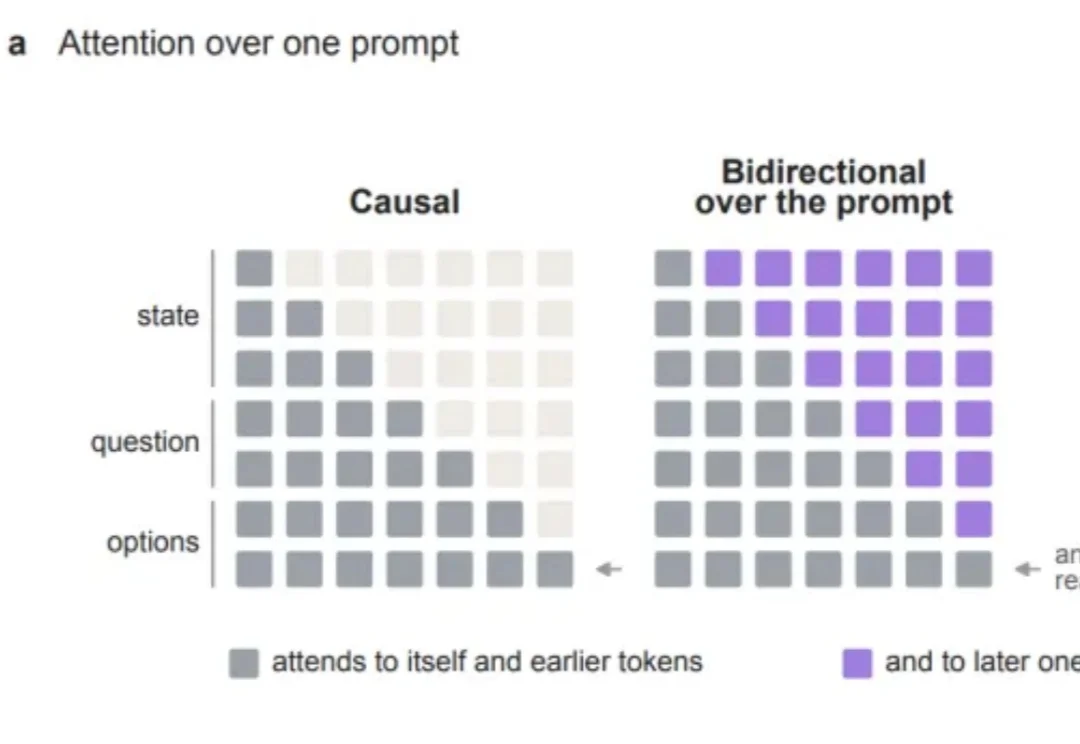
经过决策训练的语言模型,重新打开生成开关后,未必还能稳定地推理。在研究者的实验中,4B 模型在约 40% 的问题上几乎不生成推理;9B 模型则走向另一端,在约 70% 的问题上持续生成,直到触及长度上限。
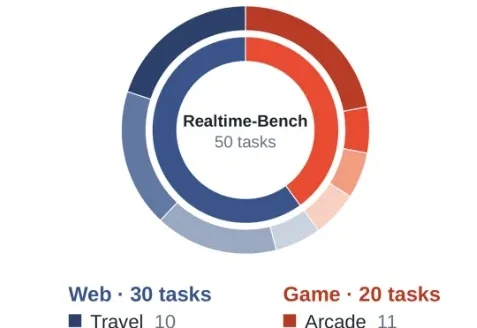
大模型能看懂复杂的网页结构,也能理解各种游戏的通关规则。
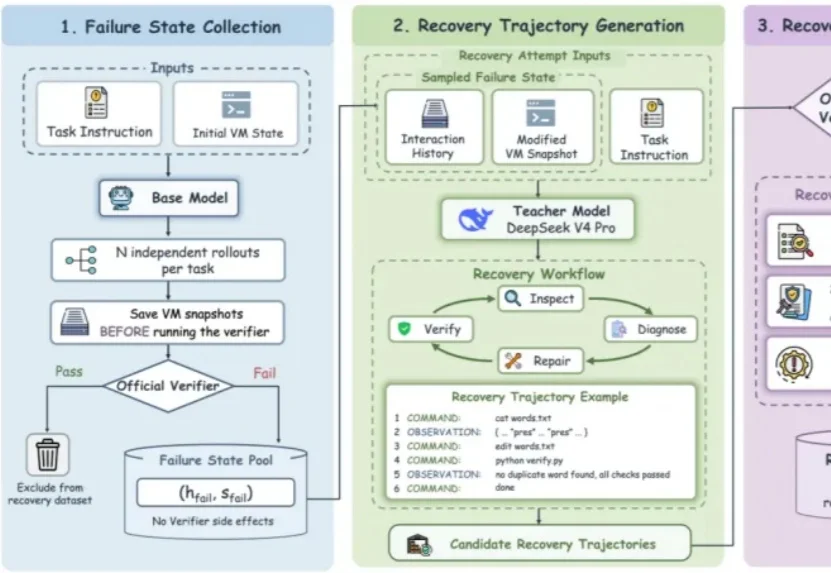
代码写错了、命令报错了、环境配坏了,Code Agent 接下来会做什么?
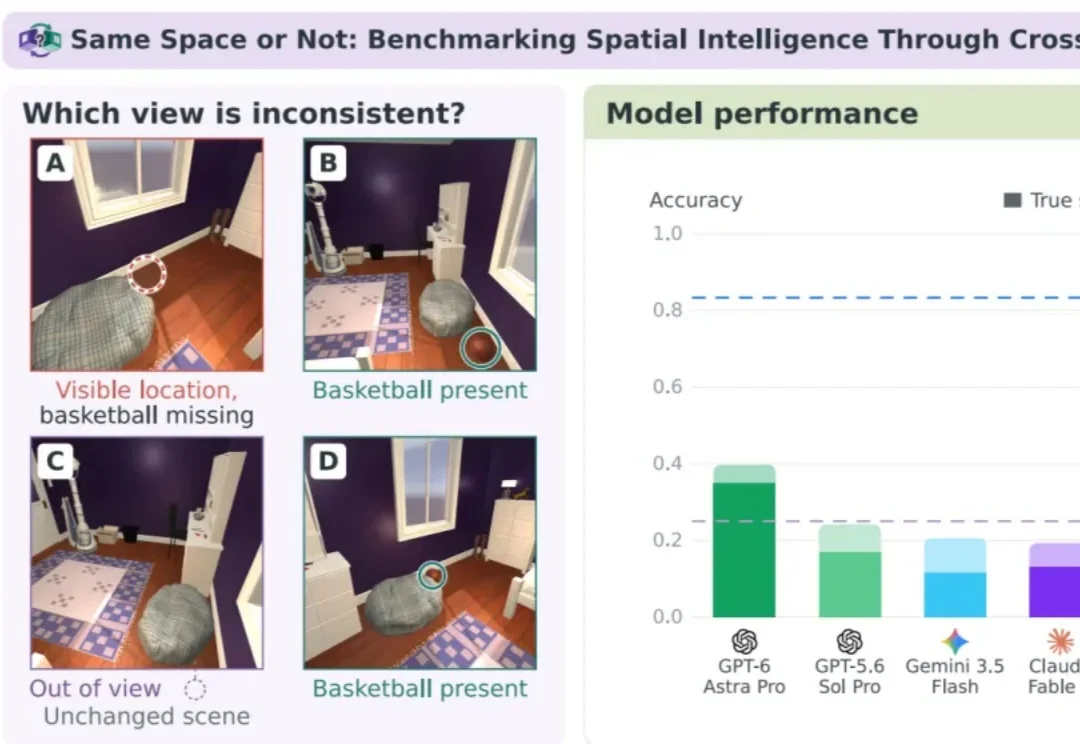
AI 真的能理解三维世界吗?
爱心为什么会让 AI 爱上递归?