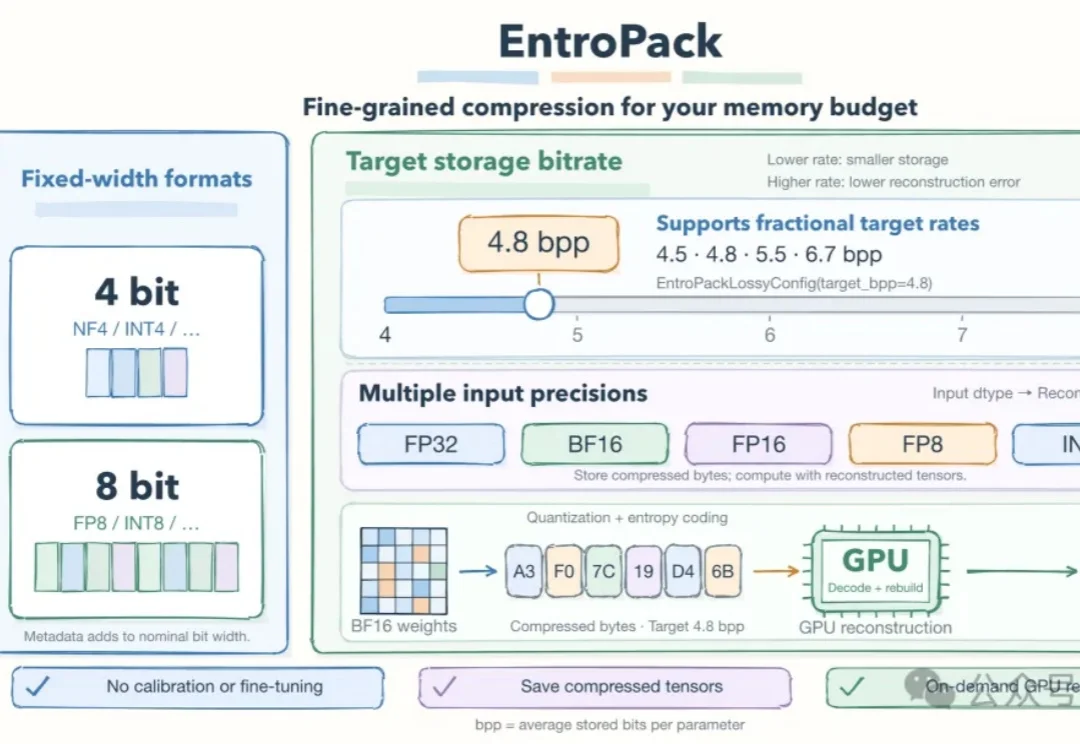
10GB显存跑图像模型,误差从9.4%降到4.26%:魔搭开源码率可调的权重压缩方案
10GB显存跑图像模型,误差从9.4%降到4.26%:魔搭开源码率可调的权重压缩方案模型的量化,是降低大模型实际运行和部署门槛的重要手段。
来自主题: AI技术研报
7658 点击 2026-11-20 10:01

 搜索
模型的量化,是降低大模型实际运行和部署门槛的重要手段。
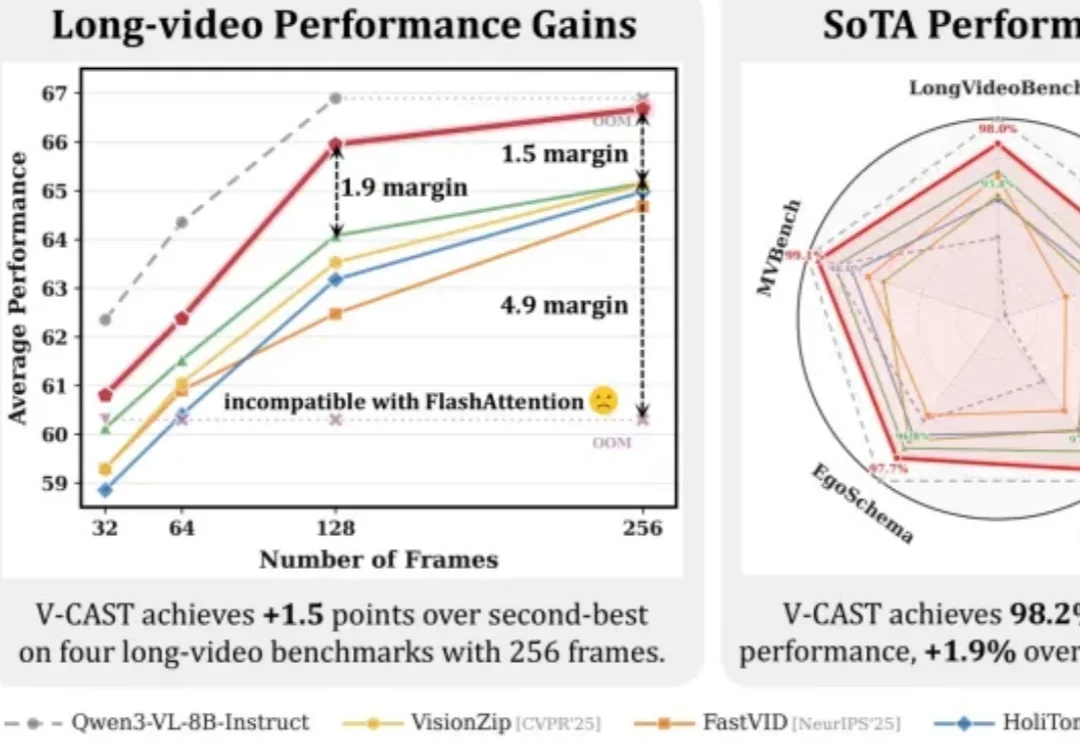
AI看长视频,模型需要逐帧把画面编码成视觉Token,再送进语言模型理解。
最近,Anthropic的CEO Dario Amodei 说了一句话: AI将在10年内,把人类在生物学上50到100年的进展压缩完成——癌症、阿尔茨海默症、心脏病,统统有望攻克。
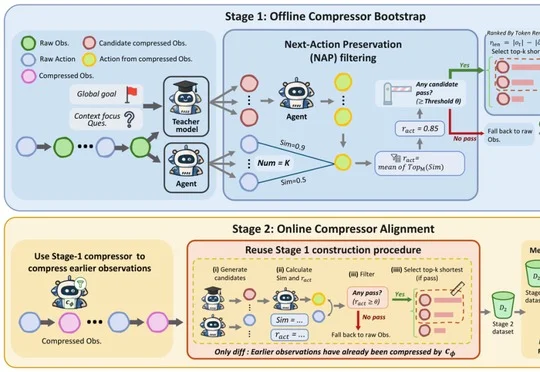
清华大学人工智能学院提出面向 Coding Agent 的 observation 压缩方法 CoACT,在 SWE-bench Verified 的三个 Agent 模型上平均减少 33.0% 总 token 消耗且 PASS@1 与未压缩时相近,该工作获 ICSE 2027 直接接收(Top 5%)。
继 Apex-35B-V1.0 凭借领先 Flint 的表现引发关注之后,开源 RSI 模型又迎来一份亮眼成绩单:REMORY 仅凭一个 1.9B 的记忆模块,用两张 H800 实现完全自监督训练,在多项关键评测中领跑;驱动小模型持续数日递归改进,产出接近 GPT-6.1-Terra。
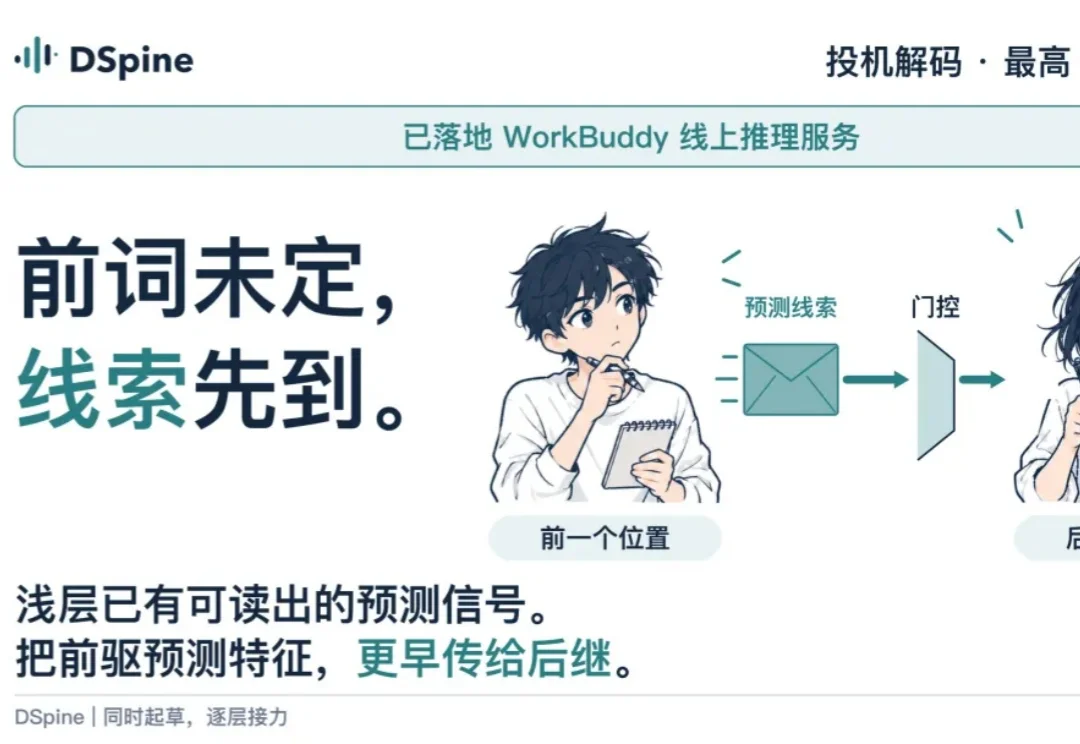
在大型语言模型(LLM)的无损推理加速中,推测解码(Speculative Decoding)已成为工业界标配。以 EAGLE-3 为代表的自回归草稿模型虽然预测准,但每多猜一个 token 就要多跑一步串行前向;而受扩散语言模型启发的 DFlash 将草稿生成彻底并行化 —— 一次骨干网络前向即可同时吐出整块候选 token,大幅压缩了起草耗时。
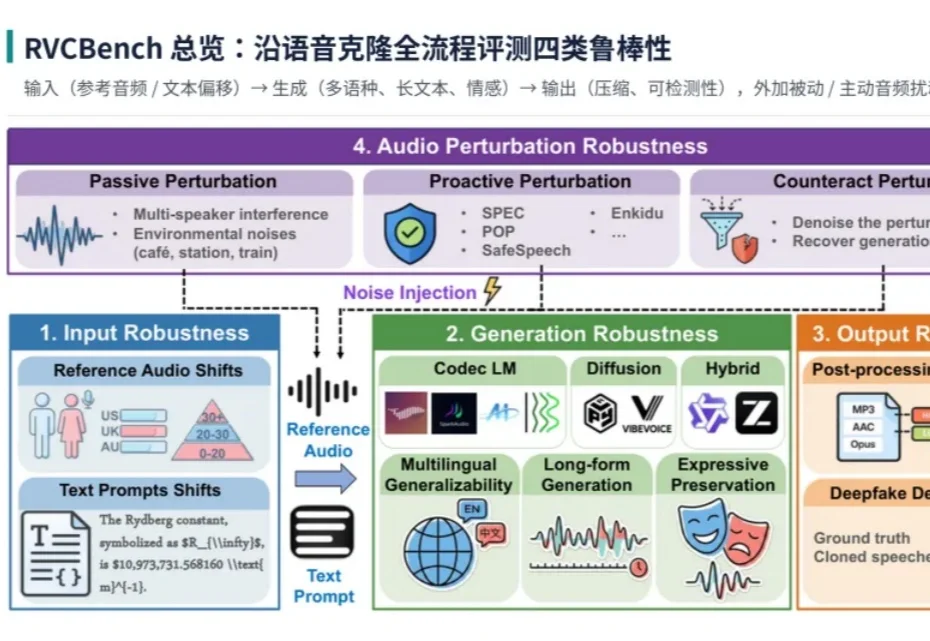
导读:只需几秒参考音频,现代语音克隆模型就能合成与目标说话人高度相似的语音。但真实部署中的参考录音往往带有噪声,文本可能异常、超长或跨语言,生成的语音还要经过压缩和电话传输,有人甚至会给自己的声音加上「防克隆」保护。
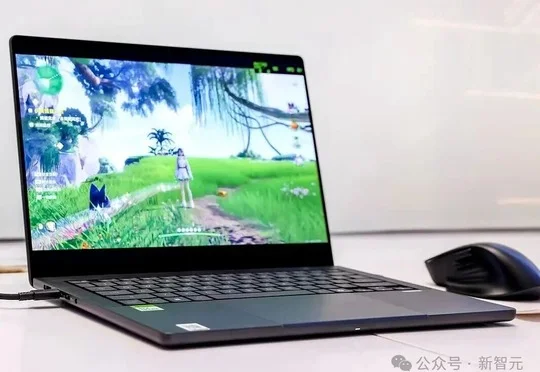
英伟达开放Nemotron 3.5 Bolt模型权重,将740亿参数版本从约148GB压缩至22.1GB以支持笔记本本地Agent任务,搭载RTX Spark的联想、微软等笔记本也于10月16日全球发售。
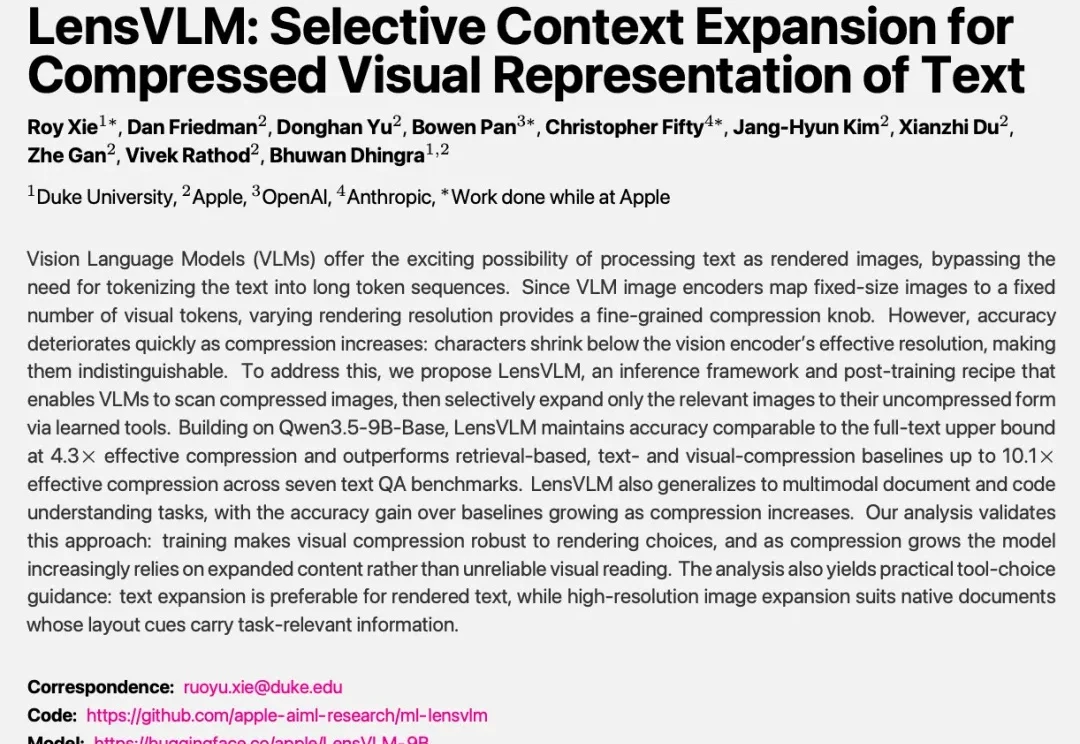
Agent 执行长程任务时,代码、工具输出和交互记录不断累积,上下文也跟着变长。
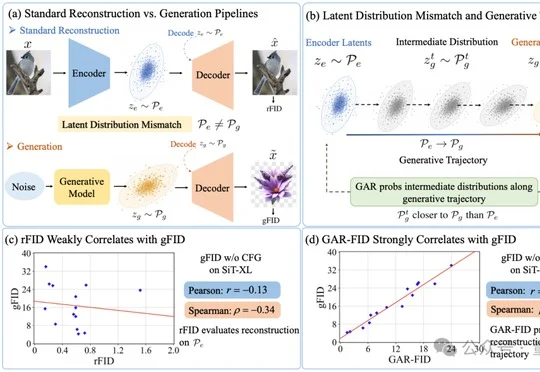
让图像生成模型先把图片压缩到潜空间,再由生成器在潜空间中作画,已成为常见路线。为了挑选图像编码器和解码器,研究者往往先看“重建”——把原图编码后再解码,所得图片是否逼真。