NeurIPS 2026 | 如何让LLM在推理中不断进化
NeurIPS 2026 | 如何让LLM在推理中不断进化隆德大学与Google DeepMind提出仅前向搜索方法,利用LLM前向传播中激活值的角度集中度筛选SVD秩并实施降秩,在无需反向传播的情况下实现下游任务自适应,较LASER-Grad降低峰值内存并提高加速比。
来自主题: AI技术研报
6237 点击 2026-11-21 11:34

 搜索
隆德大学与Google DeepMind提出仅前向搜索方法,利用LLM前向传播中激活值的角度集中度筛选SVD秩并实施降秩,在无需反向传播的情况下实现下游任务自适应,较LASER-Grad降低峰值内存并提高加速比。
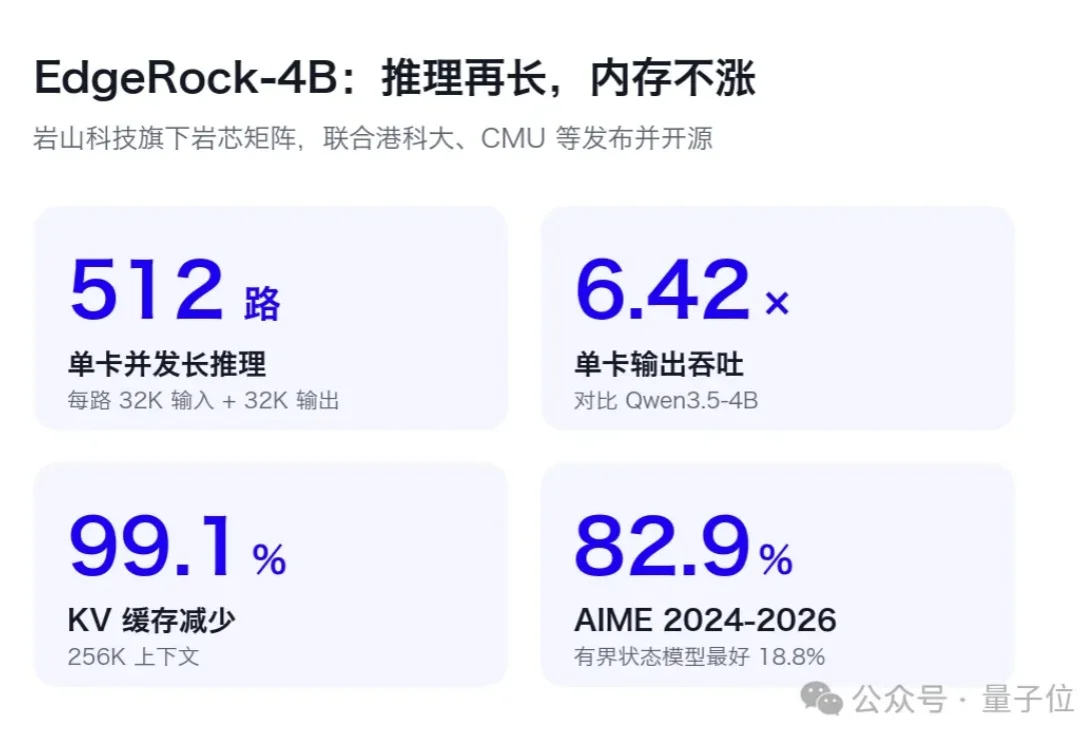
无界方舟先后开源Edge0-35B与千亿参数端侧模型Edge0-145B及统一推理引擎,后者可在29GB内存的个人笔记本本地运行,并在多项评测中比肩主流云端模型。
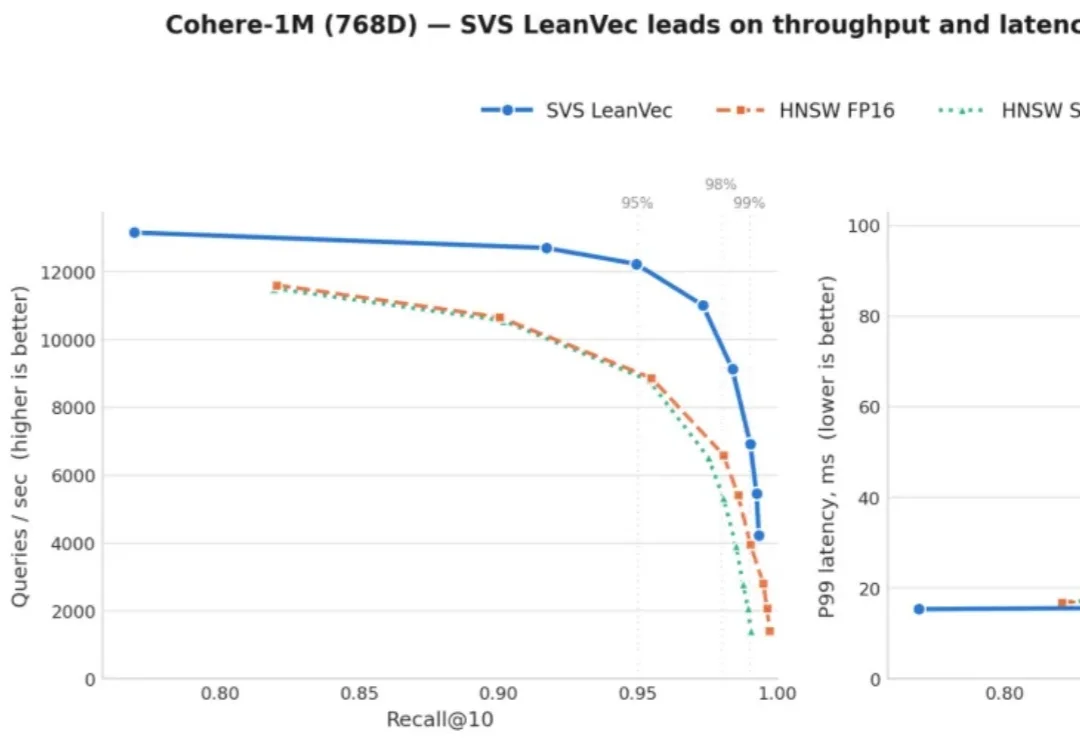
近日,Milvus 3.0 正式接入英特尔 SVS Vamana 内存图索引。
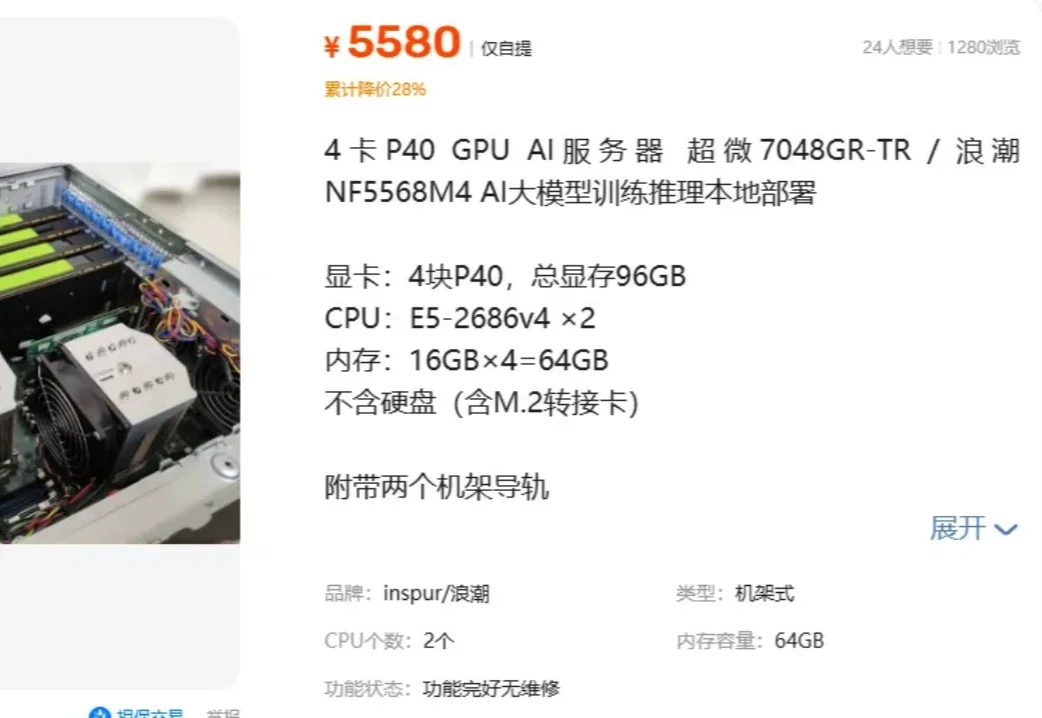
5580元,四张24GB P40,合计96GB显存。老计算卡就这么水灵灵地又上岗了。 这条闲鱼商品,卖家标称双路E5-2686 v4、64GB内存,不含硬盘,附M.2转接卡和导轨,仅限南京自提。
在 Cheeky Pint 采访中,OpenAI CEO 山姆・奥特曼称PC闲置内存用于本地AI利用率低且浪费全球DRAM,应将紧缺内存集中到云端AI数据中心,并认为内存厂商扩产保守已使“看不见的手”失灵。
XHEART新芯航途发布由大模型反向定义的智驾芯片X7 Ultra,面向十亿参数级模型、算力达700 TOPS,较行业旗舰芯片降低80%内存带宽消耗并提升100%推理能效。
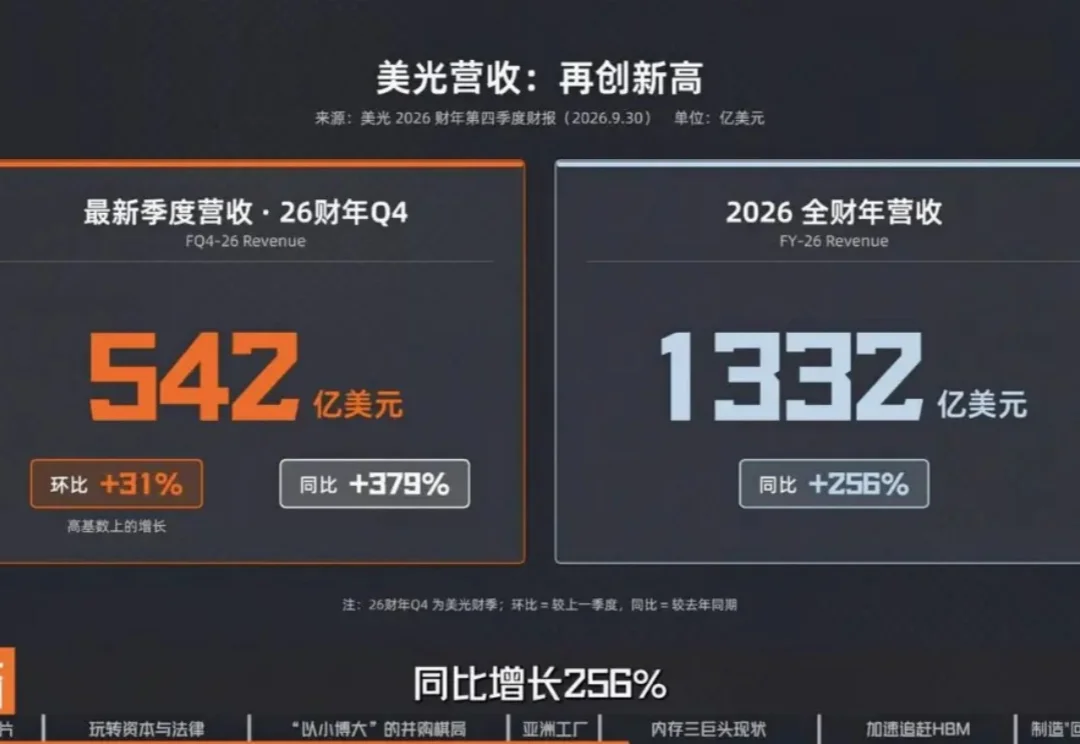
9月30日,美光再次交出了一份创纪录的财报。
无量火科技与高通联合发布移动端解决方案,Ember推理引擎让未经额外改动的30B大模型在手机运行且质量无损,并将MoE与Dense模型内存占用分别降低80%和50%。
谷歌今年的一篇论文,愣是把存储芯片巨头的股价都给整出动静了。
一张96GB显存的专业卡卖13.8万元,一套128GB的DDR5内存逼近2.5万元。