
牛来和野生狗奶一样,是羞辱人类和AI 的双重BUG
牛来和野生狗奶一样,是羞辱人类和AI 的双重BUG我是作为坚持媒体老师需要实践的操守,真的看了这部电影的,不然我就不写了
来自主题: AI资讯
7814 点击 2026-08-19 15:05

 搜索
我是作为坚持媒体老师需要实践的操守,真的看了这部电影的,不然我就不写了

随着视频扩散模型能力不断提升,从单张图像出发、按照用户指定的相机轨迹生成新视角视频,正在成为 World Modeling 的重要技术路线。

科研的链条很长。文献读不完,方向想不清,实验一轮接一轮,论文改到深夜。过去两年,大模型已经能读论文、写代码、改文章,但它们大多以问答工具的形态散落在各个环节,替研究者节省的只是零碎时间。

27B正在成为本地AI的新选择。

大模型机制可解释性研究中,一直存在一个颇具反差的现实: 为了理解一个已经训练好的模型,研究者往往需要先训练一套新的稀疏表示。
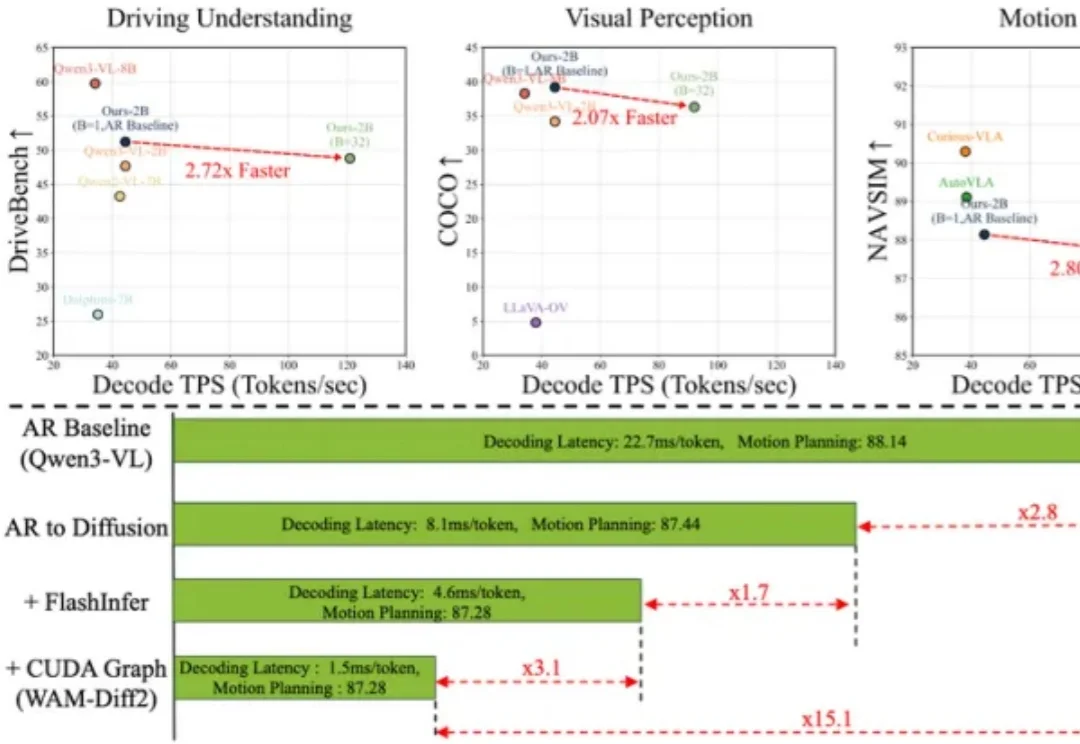
视觉 - 语言 - 动作(VLA)模型已成为端到端自动驾驶的主流技术路线,但基于自回归(AR)解码的现有架构面临双重结构性瓶颈:其一,逐 Token 串行生成导致推理延迟随序列长度线性增长,严重制约实时部署;其二,训练阶段依赖真实前缀的 teacher forcing 机制,使模型在推理时暴露于自身生成的误差之上,引发长时序累积的曝光偏差(exposure bias)。

当下,几乎所有人都在押注更大、更聪明的 AI 模型。但 AI 的下一个核心护城河到底是什么?最近,a16z 发布了一篇深度文章——《下一个 AI 护城河并非更优的模型》(The Next AI Moat Isn’t a Better Model)。

不会写代码,能不能做出一款自己的游戏?

不太妙。

玩 AI 视频有一段时间了,经验说不上多,但有一件事我算是想明白了:提示词这条路,走到头也就那样。