AI资讯新闻榜单内容搜索-上下文

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: 上下文
33 天年收入从 100 万美金涨到 200 万美金,AI浏览器Aside 做对了什么

33 天年收入从 100 万美金涨到 200 万美金,AI浏览器Aside 做对了什么

33 天年收入从 100 万美金涨到 200 万美金,AI浏览器Aside 做对了什么

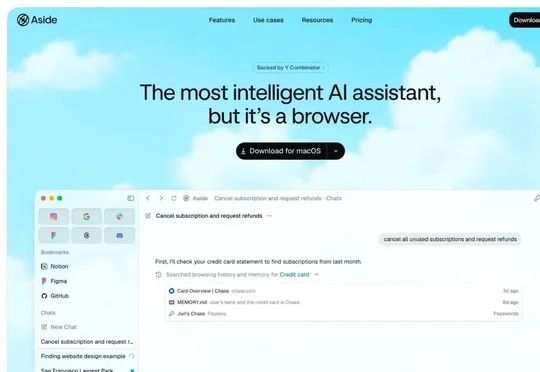
Aside 从销售会议助手转型为 AI 浏览器后,利用用户已登录的网站上下文跨站办事,上线四个月年入超过 200 万美元、月活 15 万,33 天内从 100 万美元增至 200 万美元。

来自主题: AI资讯
9400 点击    2026-11-15 12:15
Qwen Code 1.0 正式发布:Qoder 与 Qwen Code Harness 融合开源

Qwen Code 1.0 正式发布:Qoder 与 Qwen Code Harness 融合开源

Qwen Code 1.0 正式发布:Qoder 与 Qwen Code Harness 融合开源

智能正在走向更持续的理解与行动。围绕一个目标,Agent 理解上下文、制定计划,在执行中验证判断;面对新的信息,它重新评估已有结论,调整行动路径,继续推进任务。未来,更多智能将融入我们日常使用的应用。
来自主题: AI资讯
7006 点击    2026-11-11 15:27
越过上下文压缩,上智院开源REMORY,一个1.9B的记忆模块就能让小模型独立工作3天,产出不输GPT-6.1-Terra

越过上下文压缩,上智院开源REMORY,一个1.9B的记忆模块就能让小模型独立工作3天,产出不输GPT-6.1-Terra

越过上下文压缩,上智院开源REMORY,一个1.9B的记忆模块就能让小模型独立工作3天,产出不输GPT-6.1-Terra

继 Apex-35B-V1.0 凭借领先 Flint 的表现引发关注之后,开源 RSI 模型又迎来一份亮眼成绩单:REMORY 仅凭一个 1.9B 的记忆模块,用两张 H800 实现完全自监督训练,在多项关键评测中领跑;驱动小模型持续数日递归改进,产出接近 GPT-6.1-Terra。
来自主题: AI技术研报
7383 点击    2026-11-11 14:45
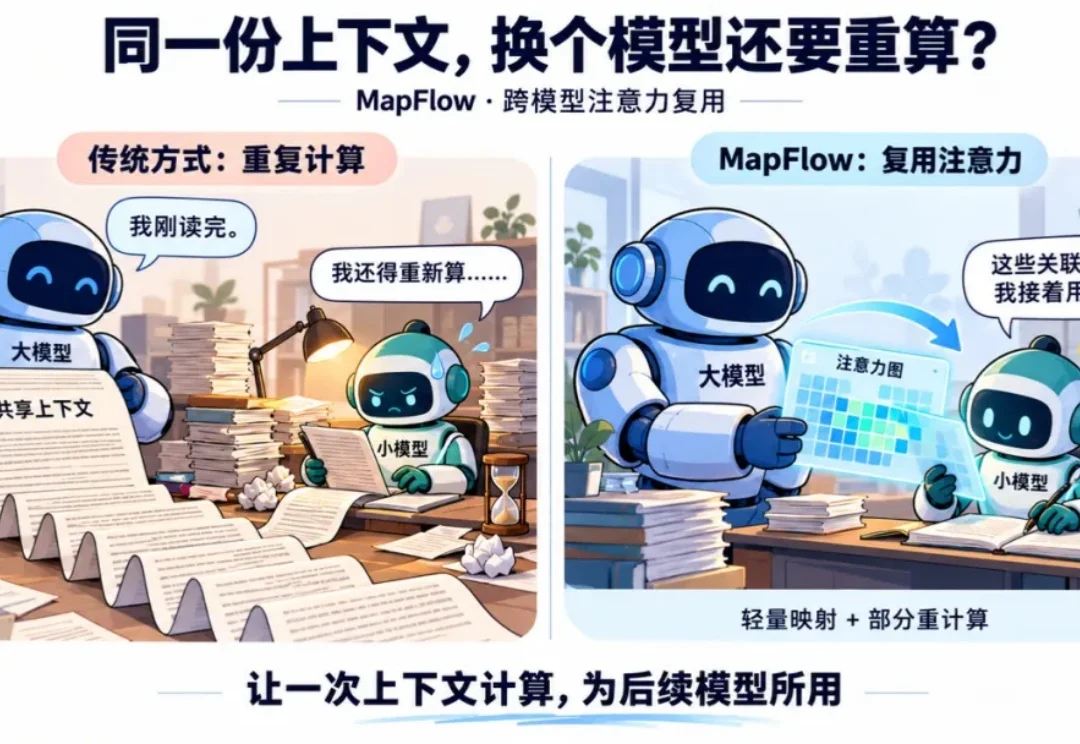
跨模型上下文交接还要重算KV?北大提出MapFlow,让注意力跨模型复用

跨模型上下文交接还要重算KV?北大提出MapFlow,让注意力跨模型复用

跨模型上下文交接还要重算KV?北大提出MapFlow,让注意力跨模型复用

模型 A 负责规划,模型 B 负责细化和总结;复杂问题交给强模型,简单问题交给轻量模型——多模型协作,为 AI Agent 应用提供了兼顾效果与成本的路径。
来自主题: AI技术研报
7547 点击    2026-11-09 10:47
为什么「陪伴」,注定是 Personal AI 的核心

为什么「陪伴」,注定是 Personal AI 的核心

为什么「陪伴」,注定是 Personal AI 的核心

Muse 的实时语音与拟人化形象降低了个人 AI 的交互门槛,并通过承接琐碎需求积累上下文,但研究显示过度使用语音 AI 可能加剧孤独感与情感依赖。
来自主题: AI资讯
9494 点击    2026-11-08 14:47
Harness 已经很准了,为什么还需要一个 Agent Native Database

Harness 已经很准了,为什么还需要一个 Agent Native Database

Harness 已经很准了,为什么还需要一个 Agent Native Database

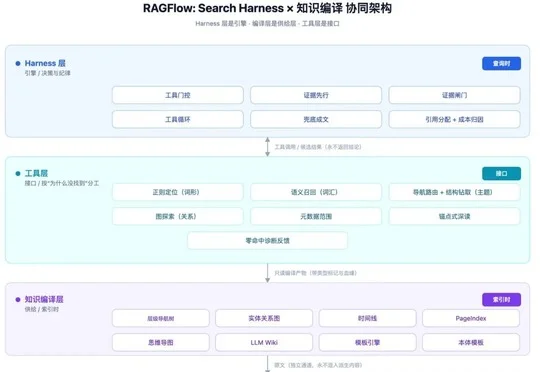
RAGFlow 1.0 以 Go 重写并公开知识编译层与 Retrieval Harness,将产品定位升级为 Agent Native 数据库,通过证据链等编译产物降低 Token 消耗并提升上下文可追溯性。
来自主题: AI技术研报
7881 点击    2026-11-06 15:50
DeepSeek Super-Agent 没回答的问题:管得了 Agent,管得好上下文吗?

DeepSeek Super-Agent 没回答的问题:管得了 Agent,管得好上下文吗?

DeepSeek Super-Agent 没回答的问题:管得了 Agent,管得好上下文吗?

DeepSeek Harness 团队前几天发了篇关于 Super-agent 设计探索的长文,想用 Router + Worker 双层架构,把一个人管理多个 Agent 的负担交给系统。文章出来后讨论不少,大多关注这套调度机制是怎么设计的。
来自主题: AI资讯
6223 点击    2026-11-06 10:30
刚刚,百度开源全新预训练基模,还是主打效率的Flash

刚刚,百度开源全新预训练基模,还是主打效率的Flash

刚刚,百度开源全新预训练基模,还是主打效率的Flash

百度开源文心 5.5 Flash Base(ERNIE 5.5 Flash Base)权重,该模型总参数280B、每token激活14B,采用稀疏MoE与混合稀疏注意力,微调和推理上下文外扩至1M tokens。
来自主题: AI资讯
9728 点击    2026-11-05 18:02
前 Manus 成员创业:Personal Agent 要从 Context 走向 Performance

前 Manus 成员创业:Personal Agent 要从 Context 走向 Performance

前 Manus 成员创业:Personal Agent 要从 Context 走向 Performance

由前 Manus 成员 Cecilia 与 Tianyi 创立的 Persom 推出本地优先的 Personal Agent,在用户授权下将电脑中的工作与生活上下文沉淀为可由其他 Agent 调用的 Personal Database,并持续沉淀工作流与个人判断。

来自主题: AI资讯
9195 点击    2026-11-04 21:40