看一遍就会,三星&上交提出RoboICL新方法,GPT-6 Astra多项机器人操控评测全面领先
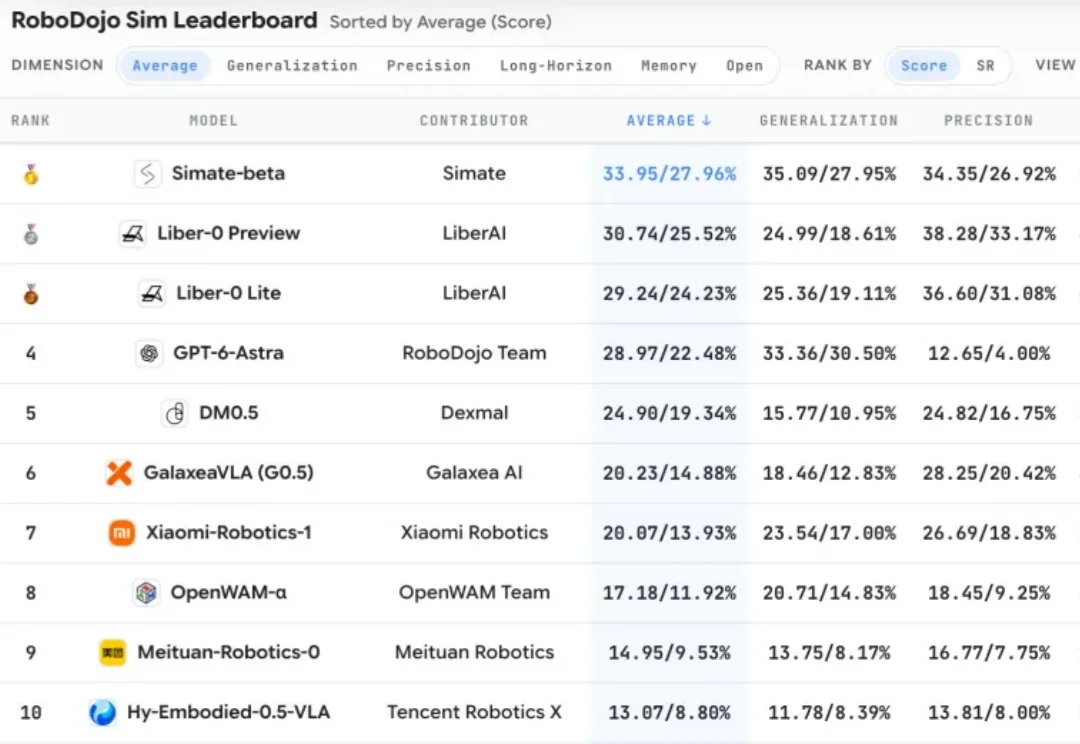
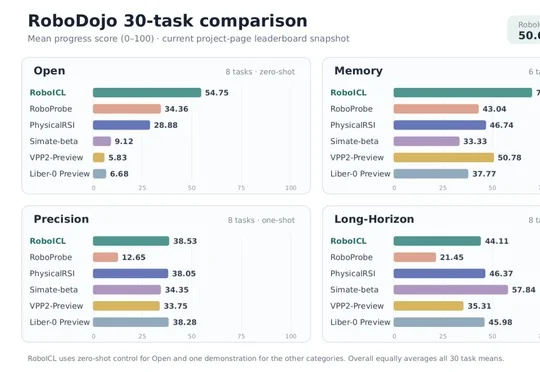
看一遍就会,三星&上交提出RoboICL新方法,GPT-6 Astra多项机器人操控评测全面领先三星与上海交通大学提出RoboICL具身上下文学习方法,通过冻结GPT-6 Astra模型并在推理时提供少量示范与机器人自身交互记忆,在RoboDojo 30项机器人操控评测中以50.64分全面领先PhysicalRSI等现有方法,并公开了929条可逐布局核查的执行记录及真实机械臂实验结果。
搜索
三星与上海交通大学提出RoboICL具身上下文学习方法,通过冻结GPT-6 Astra模型并在推理时提供少量示范与机器人自身交互记忆,在RoboDojo 30项机器人操控评测中以50.64分全面领先PhysicalRSI等现有方法,并公开了929条可逐布局核查的执行记录及真实机械臂实验结果。
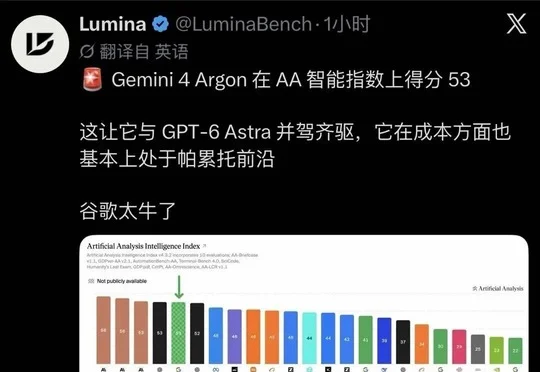
谷歌正式发布前沿AI模型Gemini 4 Argon,其在Text Arena排名第一、Vals RSI指数超越GPT-6 Astra达30%,单任务成本仅1.99美元,单次输出上限升至100万Token,并在谷歌内部以Rust安全语言重写了80万行系统内核代码。
诺因(Knowin)发布生成式学习框架GLOW,在RoboDojo、LIBERO-Pro、Embodied Arena三大具身智能榜单斩获第一,性能显著超越GPT-6,其原生自回归架构、Harness闭环反馈系统与RSI递归自我改进机制共同推动机器人实现"一教就会"的个性化家庭服务能力。
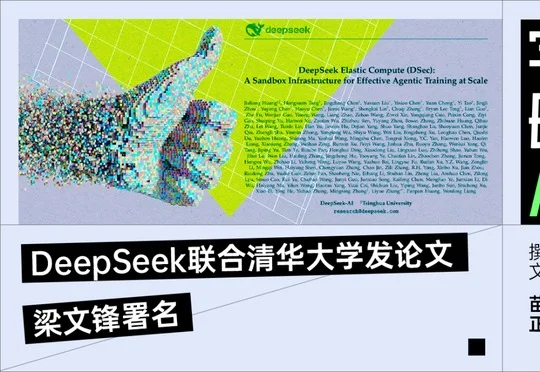
DeepSeek联合清华大学发布论文公开Agent训练沙盒基础设施DSec,梁文锋署名,论文第6节揭示DeepSeek已部分实现RSI(递归自我改进)闭环,Agent可在沙盒中自主构建训练环境,标志着Agent沙盒成为下一代云基础设施的新战场。
近日,IQuest Research 同北京航空航天大学、曼彻斯特大学等合作伙伴发布 ModularRSI,尝试让 Agent 根据自身执行经验,持续修改模型外围的运行机制——Harness。
Mind Lab(马卡龙)正式发布面向企业的模型后训练与推理平台 Mint Recursive,将其从 Macaron V1.1 训练实践中沉淀的 MinT 底层系统、自动化训练与迭代管线以托管服务形式开放给企业,支持 GLM、Qwen、DeepSeek、Kimi、MiniMax 等开源基座及监督微调、强化学习、全参数训练和 LoRA。
今年以来,RSI(Recursive Self-Improvement,递归自我改进)逐渐从硅谷前沿话题,演变为全球共识。
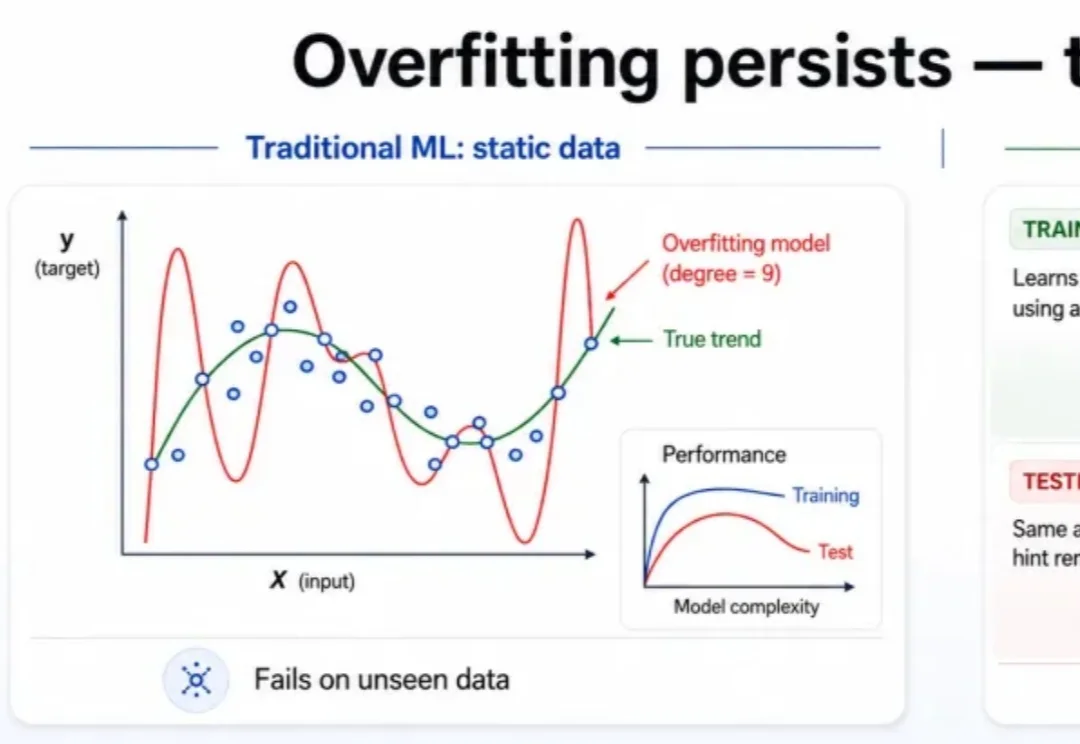
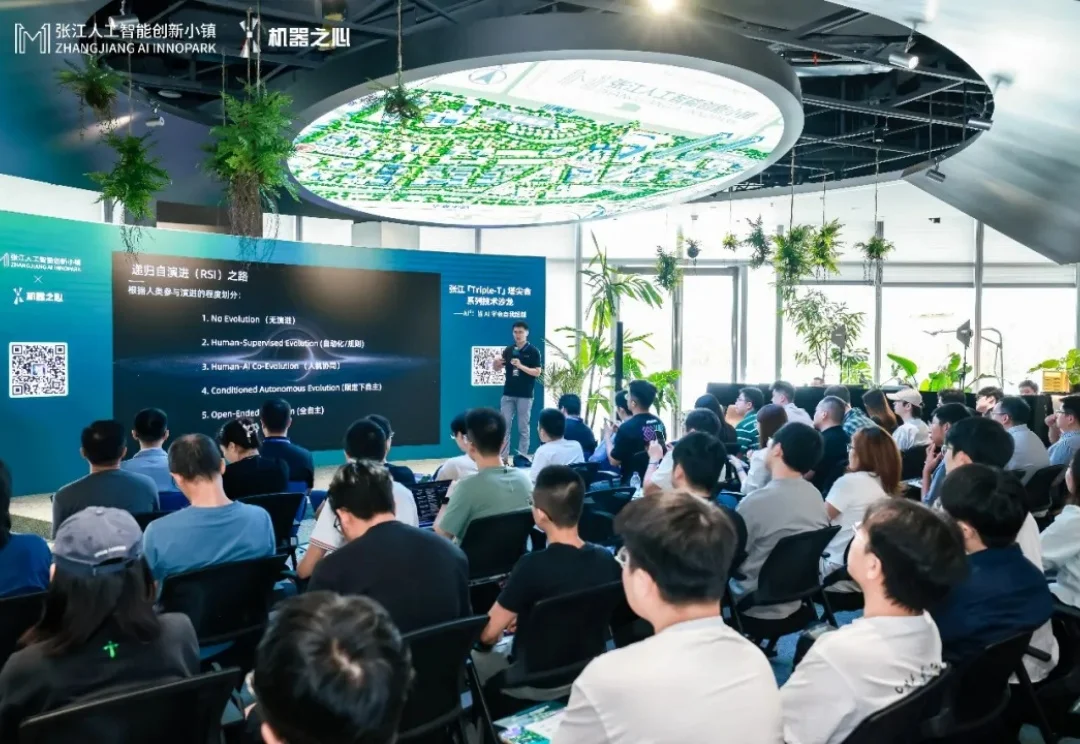
AI 距离真正的递归自我改进(RSI)还有多远?当前,AI 已开始参与数据生成、训练优化、工具迭代与结果验证,但参与研发,并不意味着已经具备持续改进自身的能力。它能够自主完成哪些环节,又如何将局部优化连接成持续、可靠的改进闭环?回答这些问题,需要回到具体的研究与实践,审视已有进展与尚待突破的瓶颈。
RSI(递归自我改进)已经热了一段时间。从 OpenAI、Anthropic 到谷歌,头部实验室都在探索如何让 AI 参与下一代 AI 的研发,创业公司也开始围绕它做产品、搭环境、建评测。
Memories.ai创始人沈俊潇在对话中阐述,记忆只是基础,公司真正聚焦于通过自建视频数据湖驱动物理AI实现"递归自我进化"(Physical RSI),其LVMM大型视觉记忆模型已与高通、英伟达达成合作,种子轮融资追加至1600万美元。