VLM记忆机制最新综述,从When, Where, What, How四个维度看懂记忆
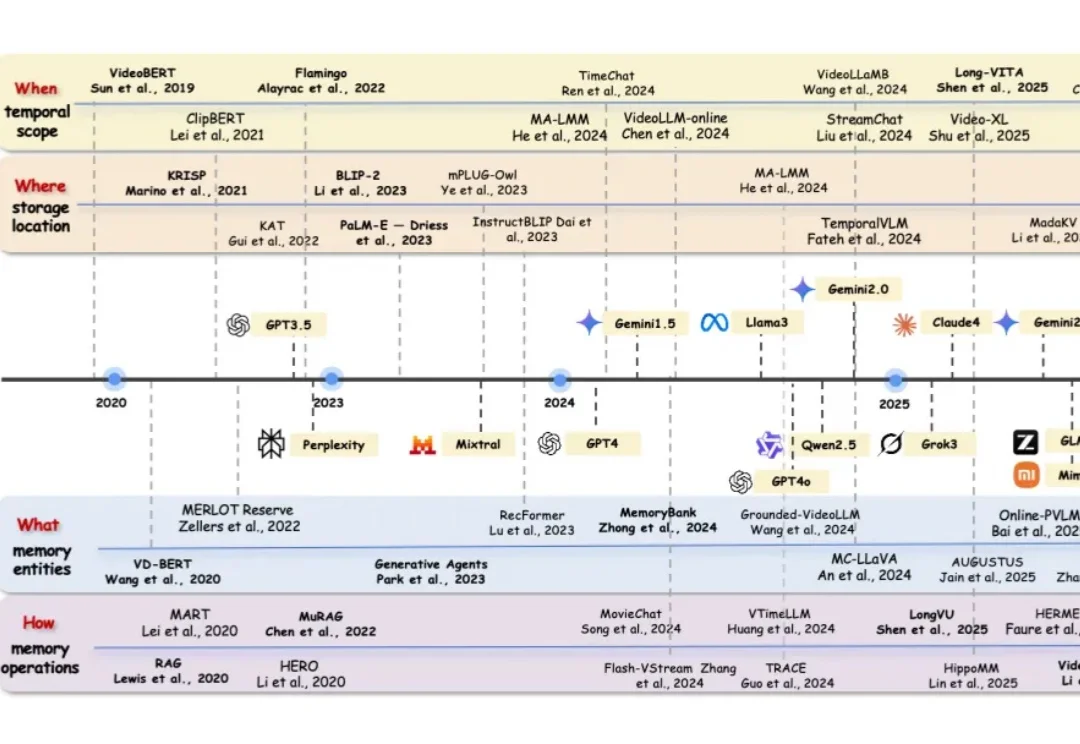
VLM记忆机制最新综述,从When, Where, What, How四个维度看懂记忆来自 Duke、Google、USC、UPenn、UNC 等八家机构的研究者联合发布最新视觉语言模型(VLM)记忆机制的系统性综述。基于全新的 4D 分类框架,系统梳理了 300 余篇相关工作和近 70 个评测基准,覆盖长视频理解与生成、多模态 RAG、具身导航与行动、个性化助手等八个热点应用场景。
搜索
来自 Duke、Google、USC、UPenn、UNC 等八家机构的研究者联合发布最新视觉语言模型(VLM)记忆机制的系统性综述。基于全新的 4D 分类框架,系统梳理了 300 余篇相关工作和近 70 个评测基准,覆盖长视频理解与生成、多模态 RAG、具身导航与行动、个性化助手等八个热点应用场景。
在机器人操作研究中,视觉语言动作模型(Vision-Language-Action,VLA)与世界动作模型(World Action Model,WAM)为机器人提供了不同的动作生成路径。但当任务从一次抓放延伸到连续搭建与双臂协同,决定成败的就不只是眼前这个动作能否完成,还包括此前建立的条件能否一直支撑后续执行。
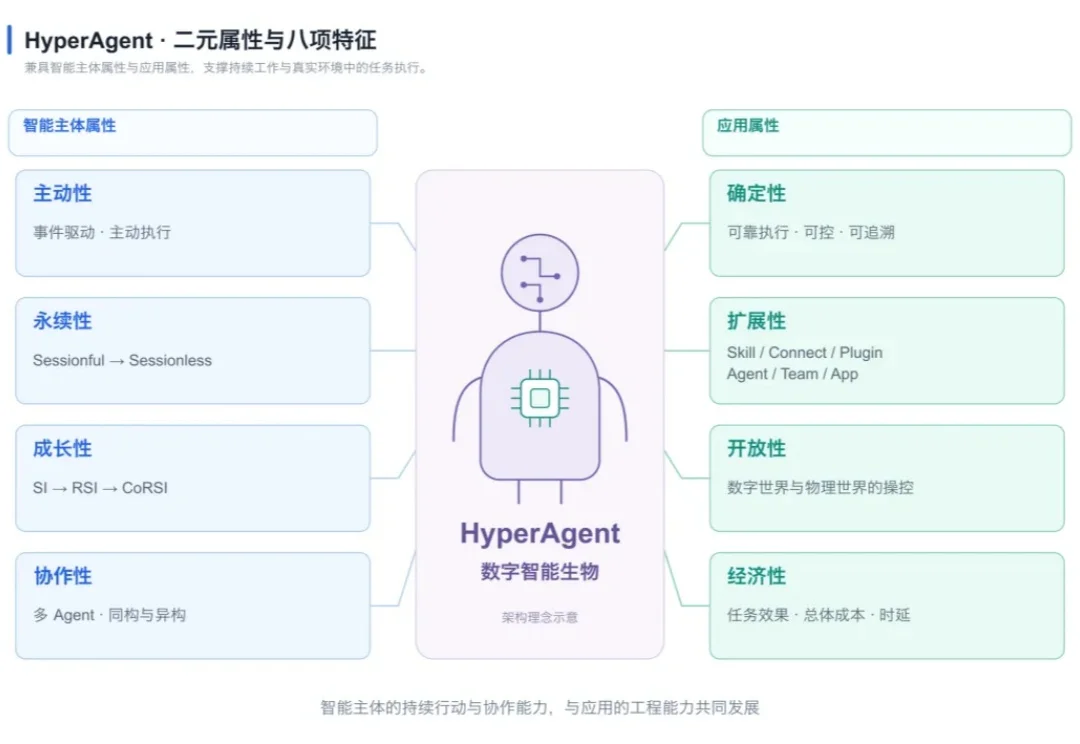
Agent 正在从「回答一个问题」走向「承担一份工作」。近日,开源 AI Agent 社区 openJiuwen 针对 HyperAgent 架构详细解读,系统阐述了它对下一代 Agent 形态的判断 ——HyperAgent 应具备的八项特征,以及支撑这一形态的开源 AgentOS 分层设计。
过去两年,几乎每家企业都在用 RAG 解决大模型落地的问题。把文档切块,做 Embedding,算相似度,塞进 Prompt。简单、直接、听起来无懈可击。但真正把它搬进生产环境的人都知道:RAG 远不够好。
广州智跃深空(Zleap)开源了自研的SAG2及桌面端SAG Wiki,利用BM25与JEV直接索引和检索本地文件,无需大模型预处理、Embedding或向量数据库,以极快建库、精准多跳检索和低Token消耗提供轻量本地知识库方案。
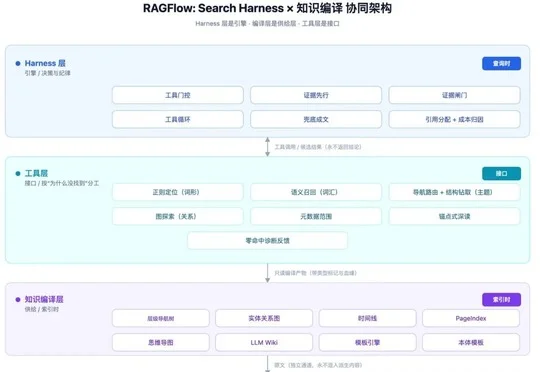
RAGFlow 1.0 以 Go 重写并公开知识编译层与 Retrieval Harness,将产品定位升级为 Agent Native 数据库,通过证据链等编译产物降低 Token 消耗并提升上下文可追溯性。
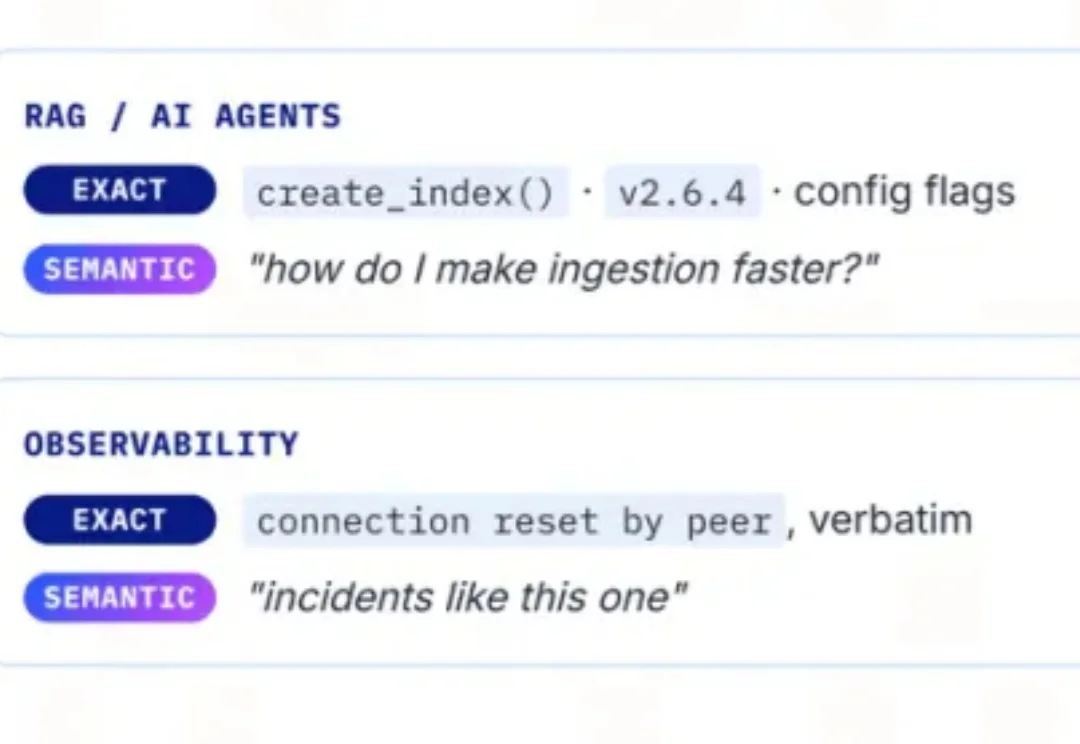
在RAG与Agent、法律以及电商等场景中,语义+关键词的混合检索已经成为越来越多搜索应用的常规配置。
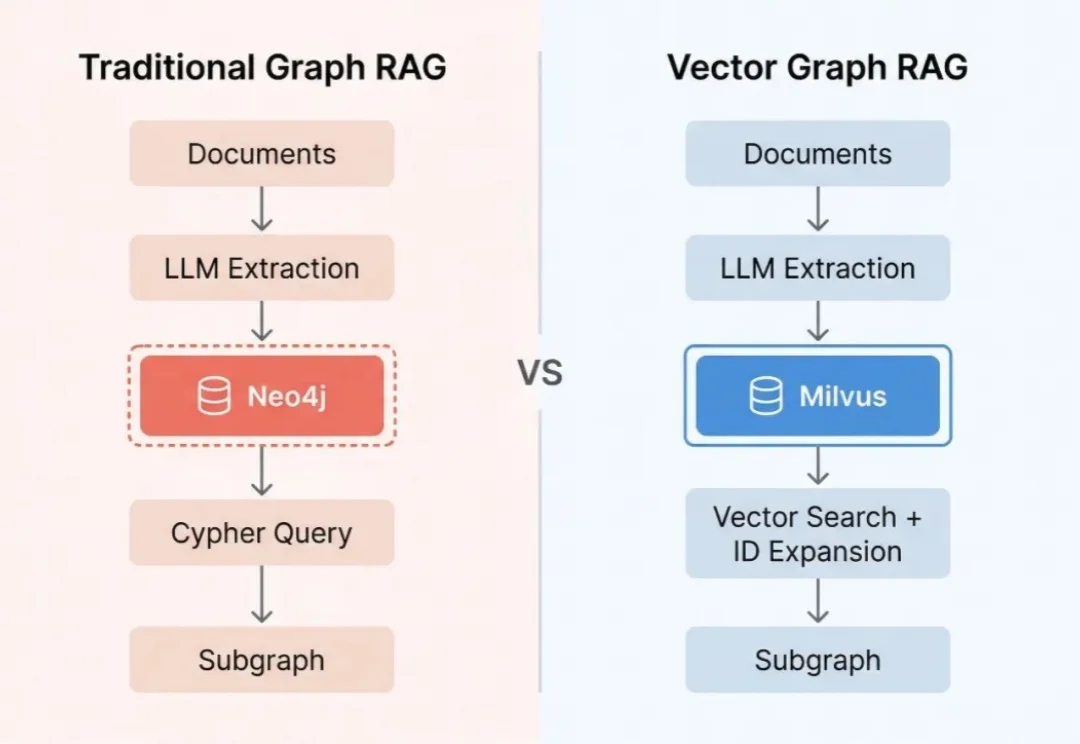
前段时间,我们做了一个开源项目 Vector Graph RAG,尝试只用 Milvus 向量数据库实现知识图谱的多跳检索,省去额外部署图数据库的麻烦。
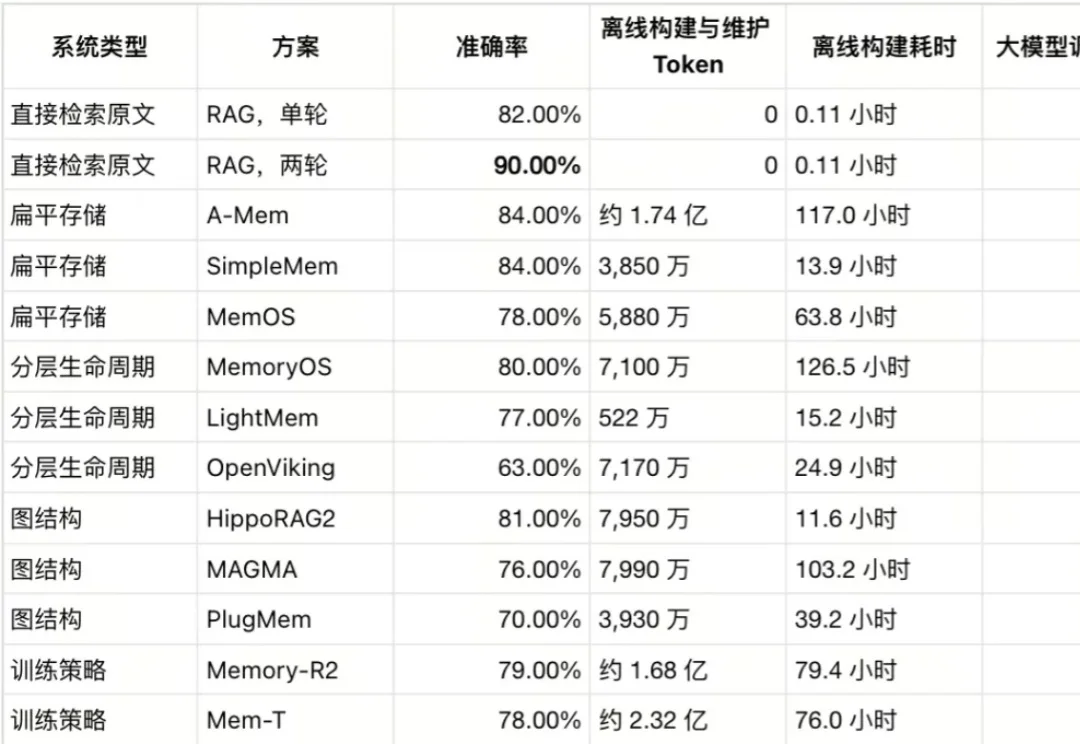
为 Agent 建记忆,花掉了上亿 Token,结果在相当一部分情况下,回答准确率甚至低于直接用RAG检索聊天记录。
DeepSeek Harness 团队发表技术文章,介绍由 Router 统筹、Worker 执行的 Super-agent 架构,支持跨会话并行、主动响应外部事件和长期在线,并已用于内部研发协作,相关原型 dsh-superagent-prototype 已开源但尚非正式产品。