NeurIPS 2026 | 港大提出RaPO:强化微调破解MLLM灾难性遗忘,代码已开源
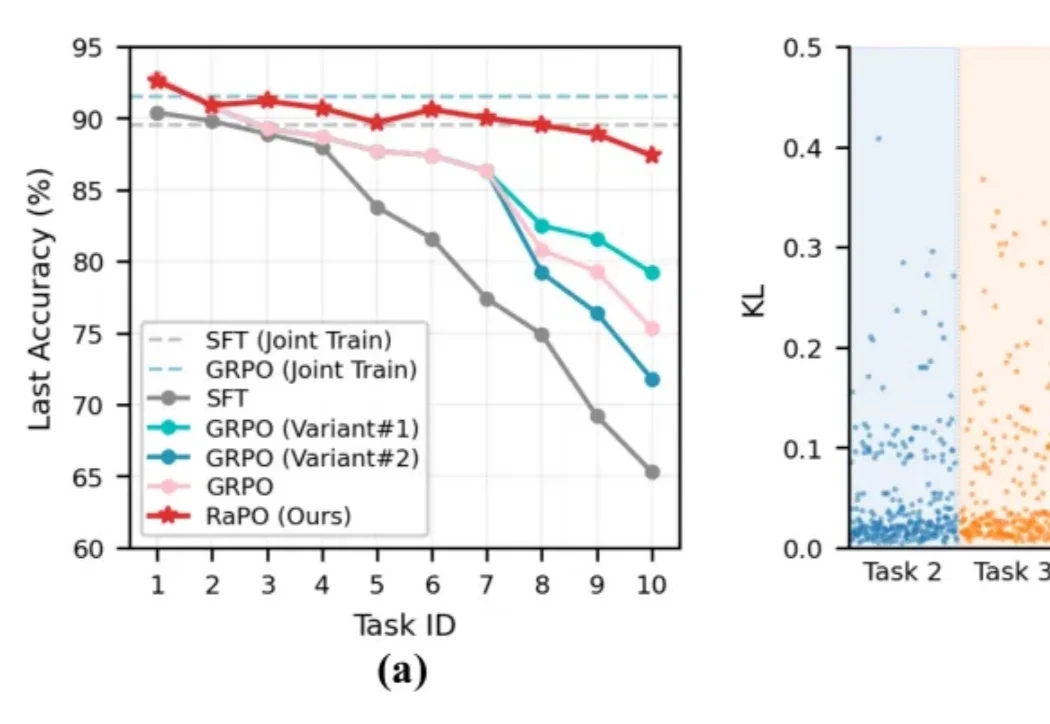
NeurIPS 2026 | 港大提出RaPO:强化微调破解MLLM灾难性遗忘,代码已开源在 LLM/MLLM 领域,基于 verifier 奖励的强化微调(Reinforcement Fine-Tuning, RFT,如 GRPO)在激发复杂推理能力方面展现出显著优势。由于 On-policy 优化的特性,很多研究指出 RFT 相比传统的监督微调(SFT)天然具备更强的抗遗忘能力。
搜索
在 LLM/MLLM 领域,基于 verifier 奖励的强化微调(Reinforcement Fine-Tuning, RFT,如 GRPO)在激发复杂推理能力方面展现出显著优势。由于 On-policy 优化的特性,很多研究指出 RFT 相比传统的监督微调(SFT)天然具备更强的抗遗忘能力。
近日,前豆包策略产品负责人孙展鹏的初创公司未见之境完成首轮融资,投资方为红杉中国与Monolith砺思资本。
元示科技宣布连续完成近亿元人民币天使轮及天使+轮融资,分别获创新工场、上海未来产业基金与燕缘创投联合领投及Monolith领投,资金将用于模型研发、数据与实验平台建设及药物研发应用验证。
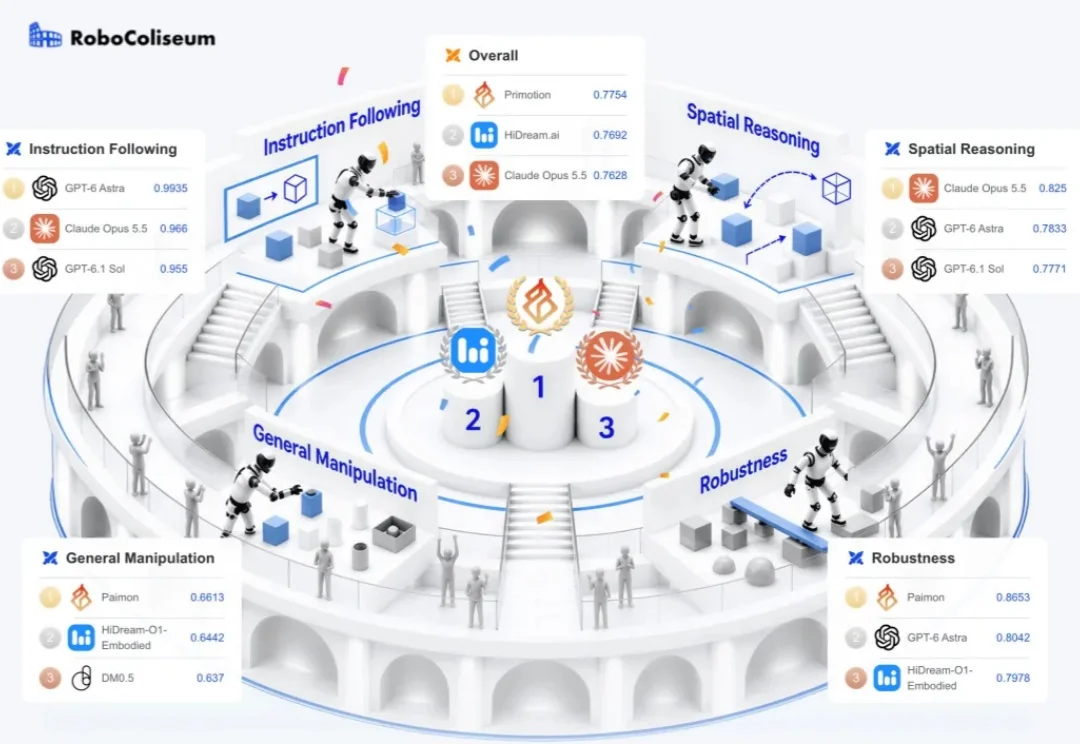
如果让 GPT、Claude、Gemini 直接指挥机器人干活,谁更靠谱?
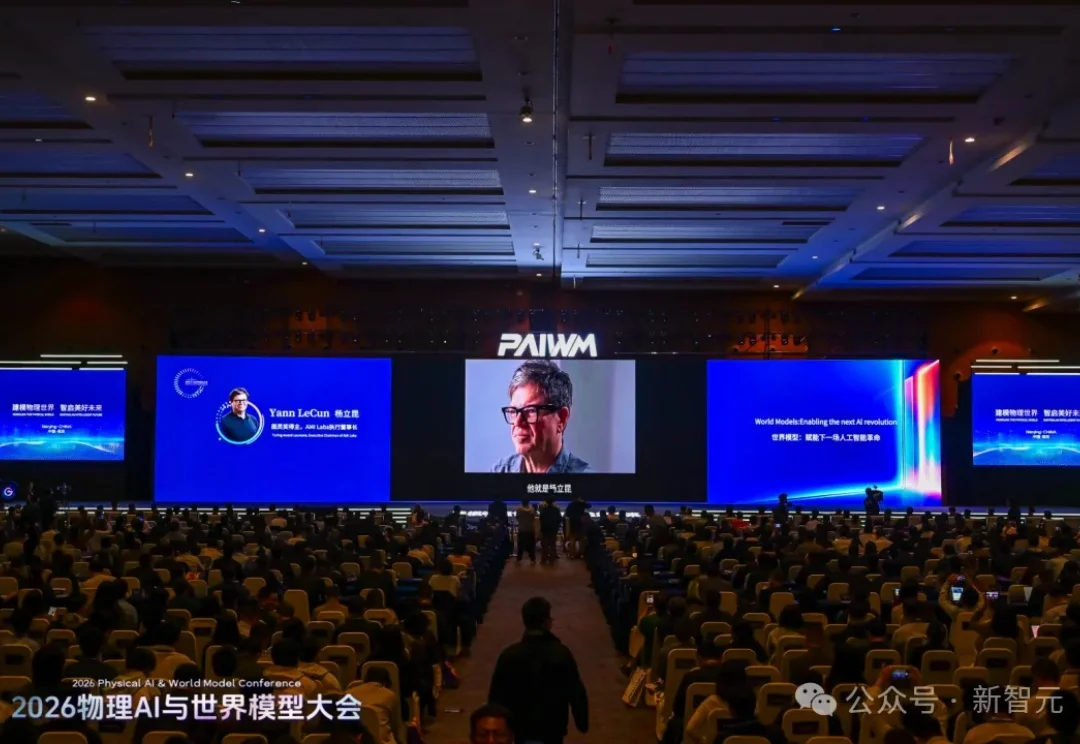
10月20日,南京国际博览中心,首届2026物理AI与世界模型大会开幕。
如今,AI正式杀入物理世界!
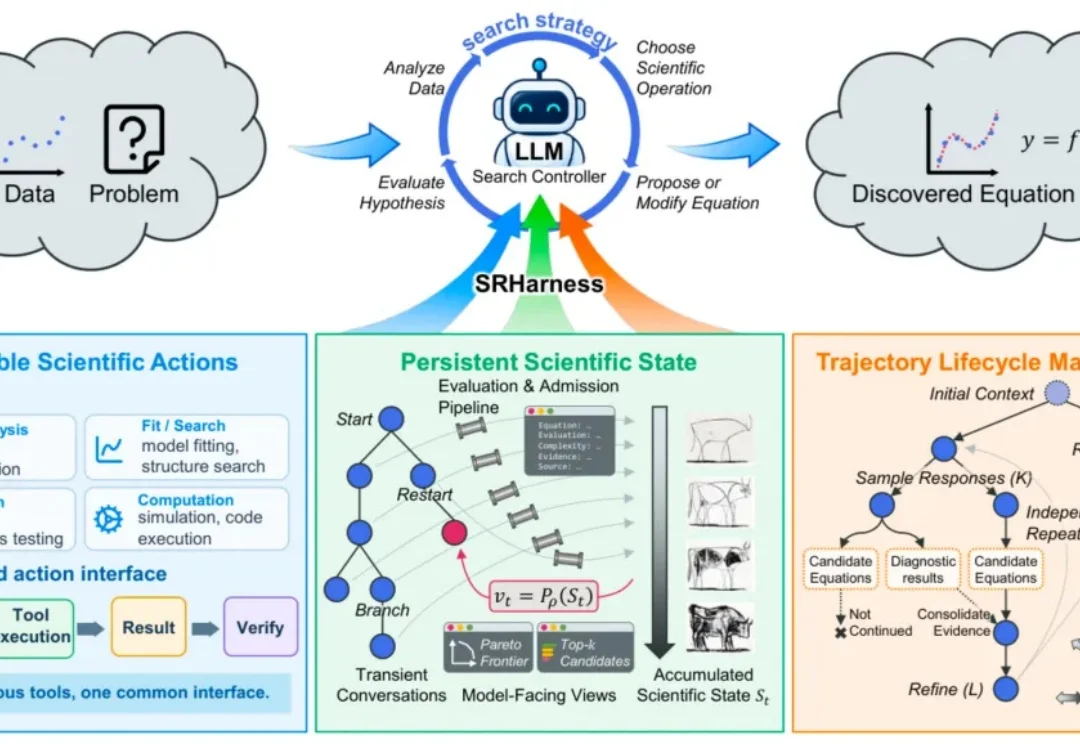
近日,清华大学电子工程系数据科学与智能实验室在 AI for Science 方向提出面向智能体符号回归(agentic symbolic regression)的运行时框架 SRHarness [1],让 AI 更可靠地从观测数据中发现公式;同时构建机制发现基准 MechBench [2],系统评测 AI 能否进一步揭示公式背后的机理。
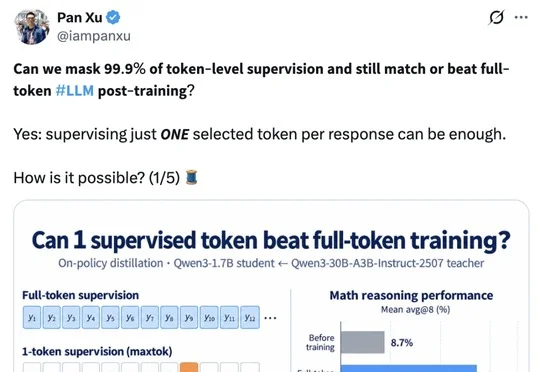
亚马逊公司与杜克大学的研究表明,在大模型后训练的在线策略蒸馏(OPD)中,仅保留万分之一的极端稀疏监督信号即可显著提升学生模型的推理能力,且性能可匹配甚至超越密集全信号训练。
TaoMate-H3 是由阿里巴巴 TaoLive AIGC 团队研发的音视频联合流式生成模型。基于 MiniMax H3,TaoMate-H3 将三步 LoRA 推理与自回归生成相结合,能够根据文本
GitHub火热开源项目Colibrì以纯C实现分层推理框架,通过AI内存多层化将SSD、RAM和VRAM组成动态调度系统,无需GPU即可让普通笔记本运行744B参数GLM-5.2等超大MoE模型,已揽获32k Star并支持9个模型家族。