AI资讯新闻榜单内容搜索-ODE

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: ODE
GPT-5.1 Codex 比Claude便宜 55%,代码漏洞更少!全栈开发老鸟警告:Anthropic 需要重新考虑定价了!

GPT-5.1 Codex 比Claude便宜 55%,代码漏洞更少!全栈开发老鸟警告:Anthropic 需要重新考虑定价了!

GPT-5.1 Codex 比Claude便宜 55%,代码漏洞更少!全栈开发老鸟警告:Anthropic 需要重新考虑定价了!

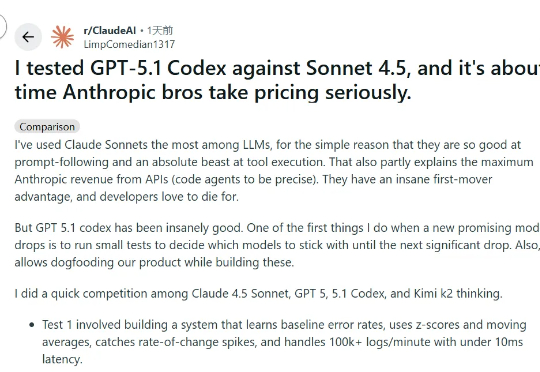
最近,小编注意到一位全栈工程师 Rohith Singh 在Reddit上发表了一篇帖子,介绍他如何对四个模型(Kimi K2 Thinking、Sonnet 4.5、GPT-5 Codex 和 GPT-5.1 Codex)进行了实测。

来自主题: AI资讯
11355 点击    2025-11-18 15:10
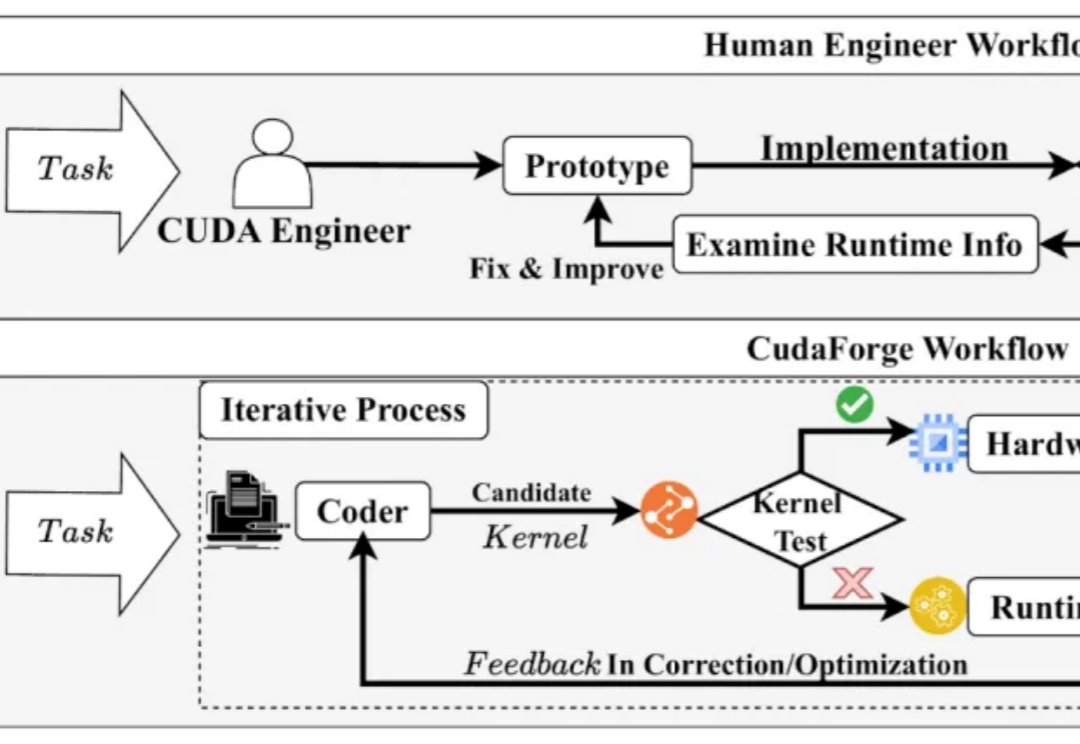
成本仅0.3美元,耗时26分钟!CudaForge:颠覆性低成本CUDA优化框架

成本仅0.3美元,耗时26分钟!CudaForge:颠覆性低成本CUDA优化框架

成本仅0.3美元,耗时26分钟!CudaForge:颠覆性低成本CUDA优化框架

CUDA 代码的性能对于当今的模型训练与推理至关重要,然而手动编写优化 CUDA Kernel 需要很高的知识门槛和时间成本。与此同时,近年来 LLM 在 Code 领域获得了诸多成功。

来自主题: AI技术研报
11607 点击    2025-11-18 10:06
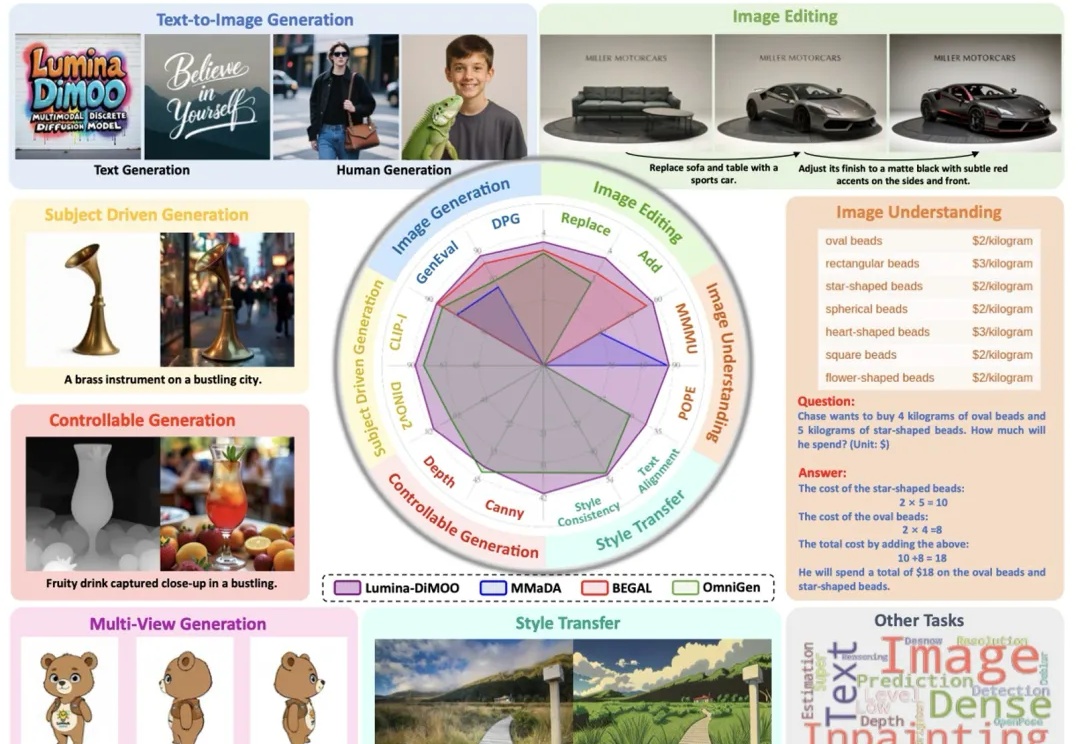
Lumina-DiMOO:多模态扩散语言模型重塑图像生成与理解

Lumina-DiMOO:多模态扩散语言模型重塑图像生成与理解

Lumina-DiMOO:多模态扩散语言模型重塑图像生成与理解

上海人工智能实验室推出了一款革新的多模态生成理解一体化的扩散语言模型 ——Lumina-DiMOO。基于离散扩散建模(Discrete Diffusion Modeling),Lumina-DiMOO 打破了多模态任务之间的壁垒,在同一离散扩散框架下,完成从 文本→图像、图像→图像、图像→文本的全栈能力闭环。

来自主题: AI技术研报
10555 点击    2025-11-17 14:33
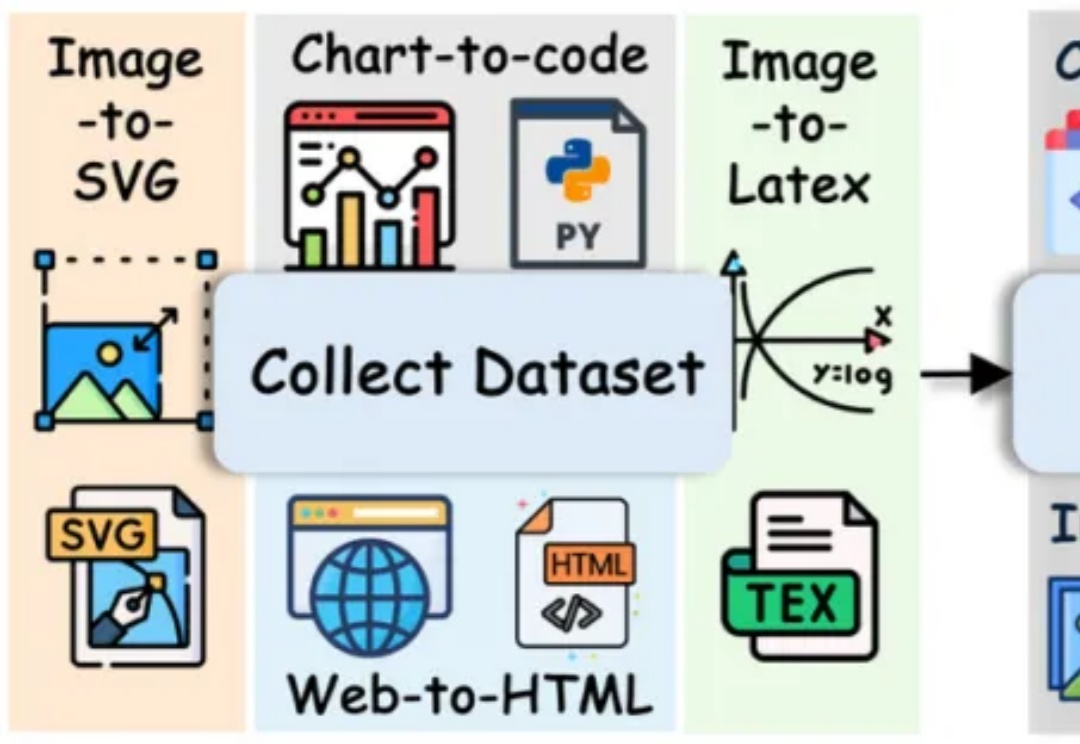
VinciCoder:多模态统一代码生成框架和视觉反馈强化学习,数据代码模型权重已开源

VinciCoder:多模态统一代码生成框架和视觉反馈强化学习,数据代码模型权重已开源

VinciCoder:多模态统一代码生成框架和视觉反馈强化学习,数据代码模型权重已开源

长期以来,多模态代码生成(Multimodal Code Generation)的训练严重依赖于特定任务的监督微调(SFT)。尽管这种范式在 Chart-to-code 等单一任务上取得了显著成功 ,但其 “狭隘的训练范围” 从根本上限制了模型的泛化能力,阻碍了通用视觉代码智能(Generalized VIsioN Code Intelligence)的发展 。

来自主题: AI技术研报
11039 点击    2025-11-17 14:32
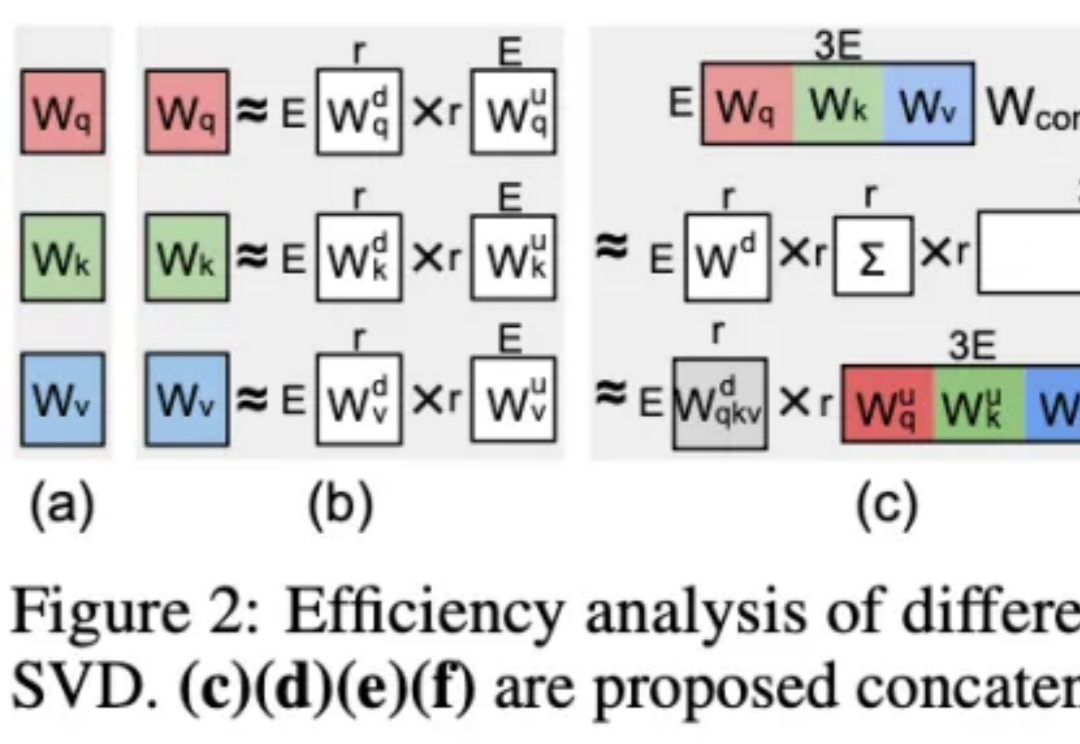
NeurIPS 2025 Spotlight | NYU提出QSVD,仅数学压缩让模型更轻、更快、更稳

NeurIPS 2025 Spotlight | NYU提出QSVD,仅数学压缩让模型更轻、更快、更稳

NeurIPS 2025 Spotlight | NYU提出QSVD,仅数学压缩让模型更轻、更快、更稳

在多模态智能浪潮中,视觉语言模型(Vision-Language Models, VLM)已成为连接视觉理解与语言生成的核心引擎。从图像描述、视觉问答到 AI 教育和交互系统,它们让机器能够「看懂世界、说人话」。

来自主题: AI技术研报
11467 点击    2025-11-17 09:53
Transformer作者重磅预言:AI无寒冬,推理革命引爆万亿市场!

Transformer作者重磅预言:AI无寒冬,推理革命引爆万亿市场!

Transformer作者重磅预言:AI无寒冬,推理革命引爆万亿市场!

Transformer的火种已燃烧七年。如今,推理模型(Reasoning Models)正点燃第二轮革命。Transformer共同作者、OpenAI研究员Łukasz Kaiser预判:未来一两年,AI会极速跃升——瓶颈不在算法,而在GPU与能源。

来自主题: AI资讯
9907 点击    2025-11-15 17:00
FDA对偶锚点:模型知识迁移的新视角——从参数空间到输入空间

FDA对偶锚点:模型知识迁移的新视角——从参数空间到输入空间

FDA对偶锚点:模型知识迁移的新视角——从参数空间到输入空间

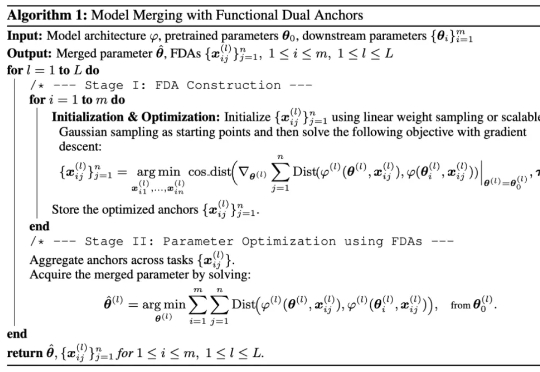
研究者们提出了 FDA(Model Merging with Functional Dual Anchors)——一个全新的模型融合框架。与传统的参数空间操作不同,FDA 将专家模型的参数知识投射到输入-表征空间中的合成锚点,通过功能对偶的方式实现更高效的知识整合。

来自主题: AI技术研报
9095 点击    2025-11-14 13:57
RAE+VAE? 预训练表征助力扩散模型Tokenizer,加速像素压缩到语义提取

RAE+VAE? 预训练表征助力扩散模型Tokenizer,加速像素压缩到语义提取

RAE+VAE? 预训练表征助力扩散模型Tokenizer,加速像素压缩到语义提取

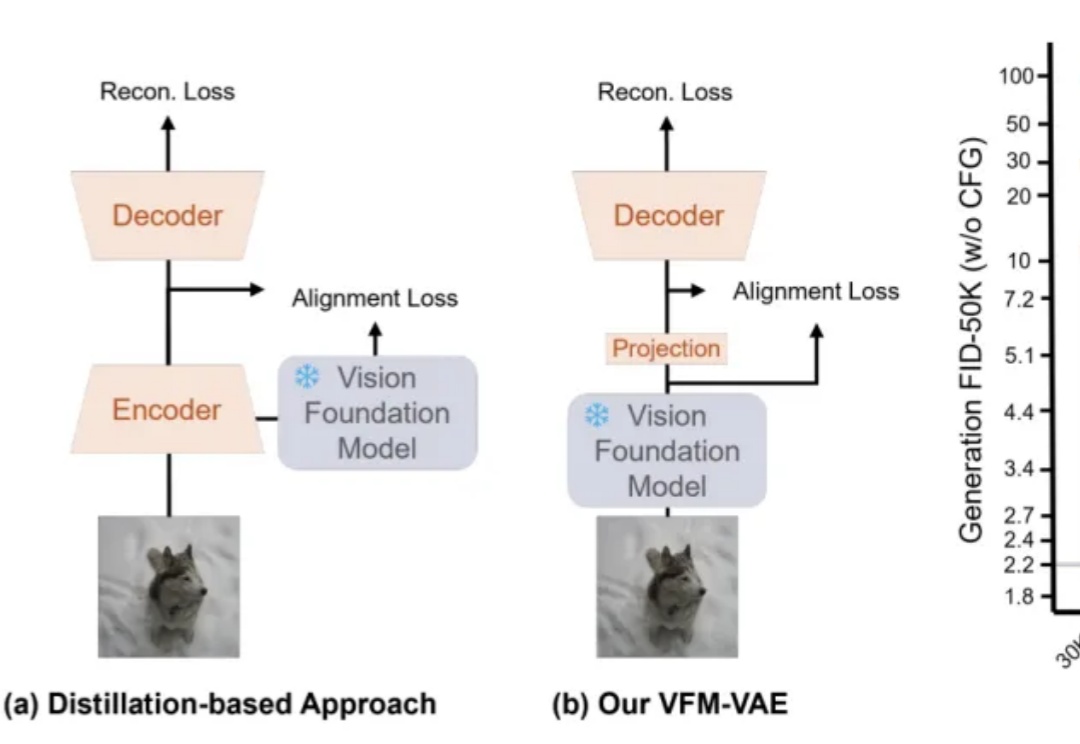
近期,RAE(Diffusion Transformers with Representation Autoencoders)提出以「 冻结的预训练视觉表征」直接作为潜空间,以显著提升扩散模型的生成性能。

来自主题: AI技术研报
13544 点击    2025-11-14 10:21