
放弃n8n!飞书多维表格才是效率的神,确实太好用了~【附喂饭级教程】
放弃n8n!飞书多维表格才是效率的神,确实太好用了~【附喂饭级教程】上上周四,我去杭州给一家企业做了一场AI编程培训,内容是 Claude Code。
来自主题: AI技术研报
11357 点击 2025-11-25 09:59

 搜索
上上周四,我去杭州给一家企业做了一场AI编程培训,内容是 Claude Code。
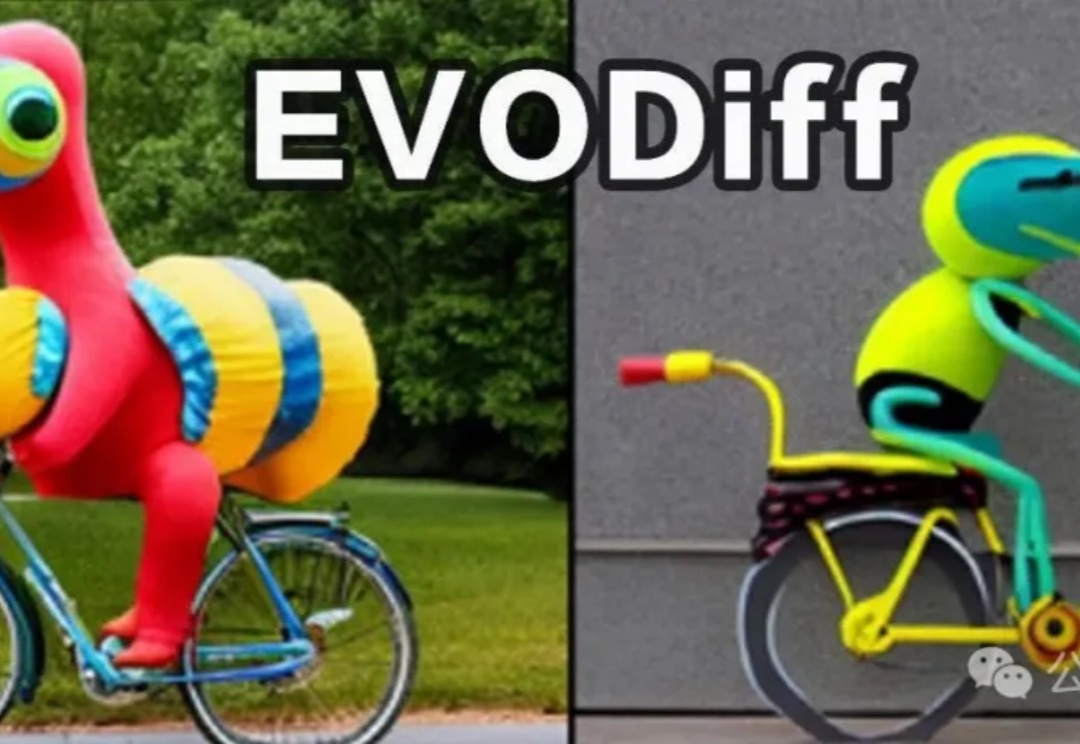
扩散概率生成模型(Diffusion Models)已成为AIGC时代的重要基础,但其推理速度慢、训练与推理之间的差异大,以及优化困难,始终是制约其广泛应用的关键问题。近日,被NeurIPS 2025接收的一篇重磅论文EVODiff给出了全新解法:来自华南理工大学曾德炉教授「统计推断,数据科学与人工智能」研究团队跳出了传统的数值求解思维,首次从信息感知的推理视角,将去噪过程重构为实时熵减优化问题。
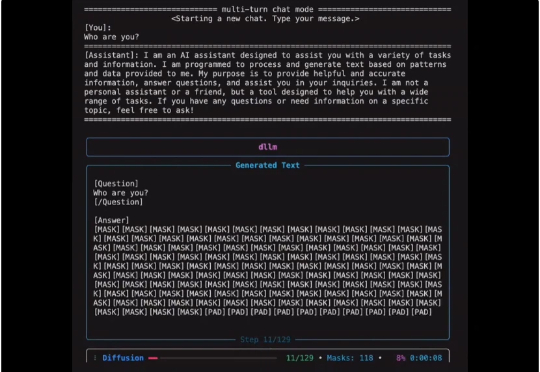
扩散式语言模型(Diffusion Language Model, DLM)虽近期受关注,但社区长期受限于(1)缺乏易用开发框架与(2)高昂训练成本,导致多数 DLM 难以在合理预算下复现,初学者也难以真正理解其训练与生成机制。
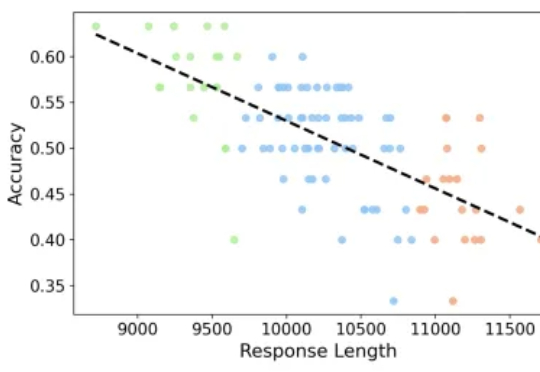
专注推理任务的 Large Reasoning Models 在数学基准上不断取得突破,但也带来了一个重要问题:越想越长、越长越错。本文解读由 JHU、UNC Charlotte 等机构团队的最新工作
前沿AI竞赛在2025年11月达到高潮。48小时内,谷歌推出Gemini 3 Pro宣称在主要推理基准测试中领先,而OpenAI立即用GPT-5.1-Codex-Max反击,这是一款专门训练用于通过创新"压缩"(compaction)技术自主工作超过24小时的专业编码模型[43]。加上Claude Sonnet 4.5已确立的编码统治地位和激进的安全过滤器,开发者面临前所未有的选择:
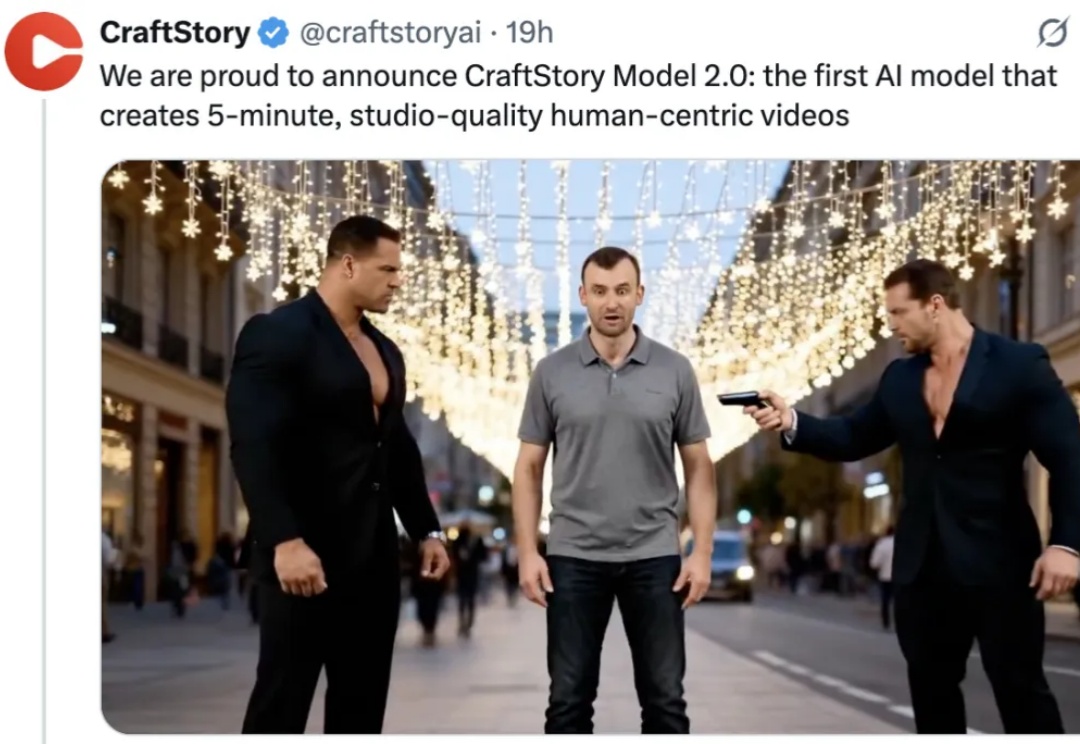
近日,一家名为 CraftStory 的 AI 初创公司推出了 Model 2.0 视频生成系统,凭借可生成长达五分钟的富有表现力、可媲美专业水准、以人为中心的视频,破解了困扰 AI 视频生成行业长久以来的「视频时长」难题,引起热议,并被视为或将是 OpenAI 的 Sora 和 Google 的 Veo 的强有力竞争者。
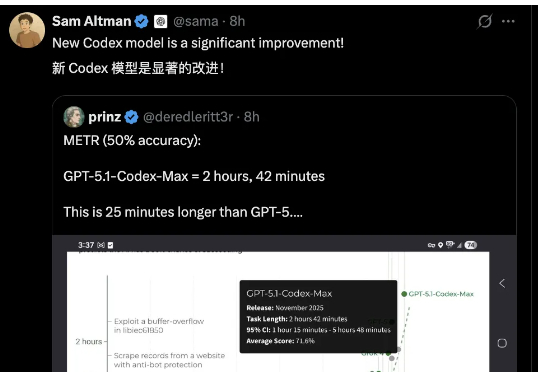
Gemini 3力压全场,OpenAI坐不住了。发布Codex新版本——GPT-5.1-Codex-Max,突破上下文窗口限制,实现跨越数百万token的长时间连续工作,最长超过24小时的那种。
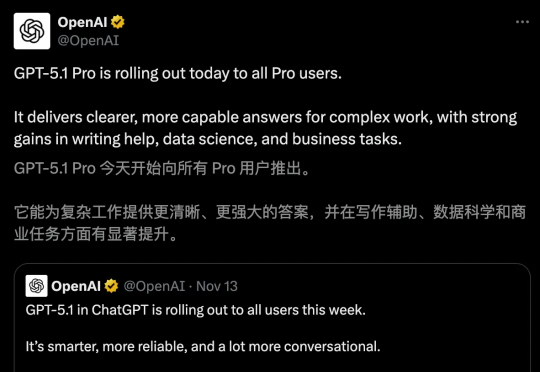
AI圈一日一更的频率,真的是有点跟不住了....前两天,先是Grok 4.1、Gemini 3 Pro发布,今天OpenAI GPT-5.1 Pro也静默登场了! 众所周知,GPT-5.1主打「情商智商」双强,Pro无疑将这两大优势推向更高层次。
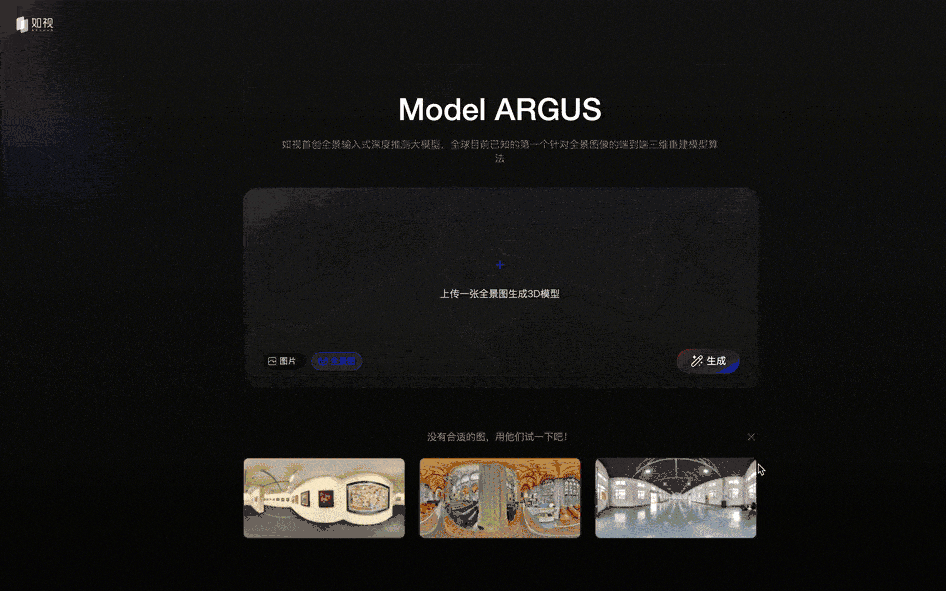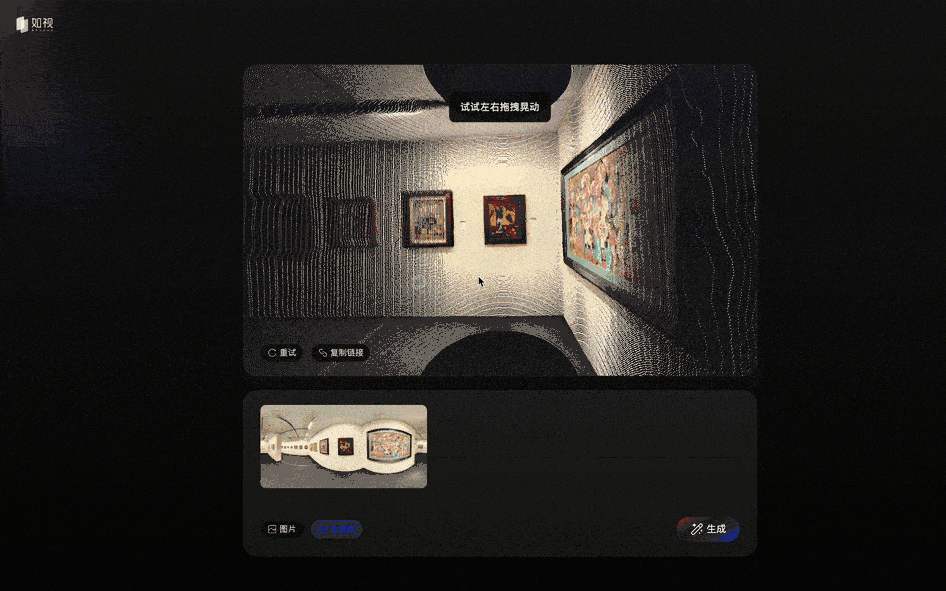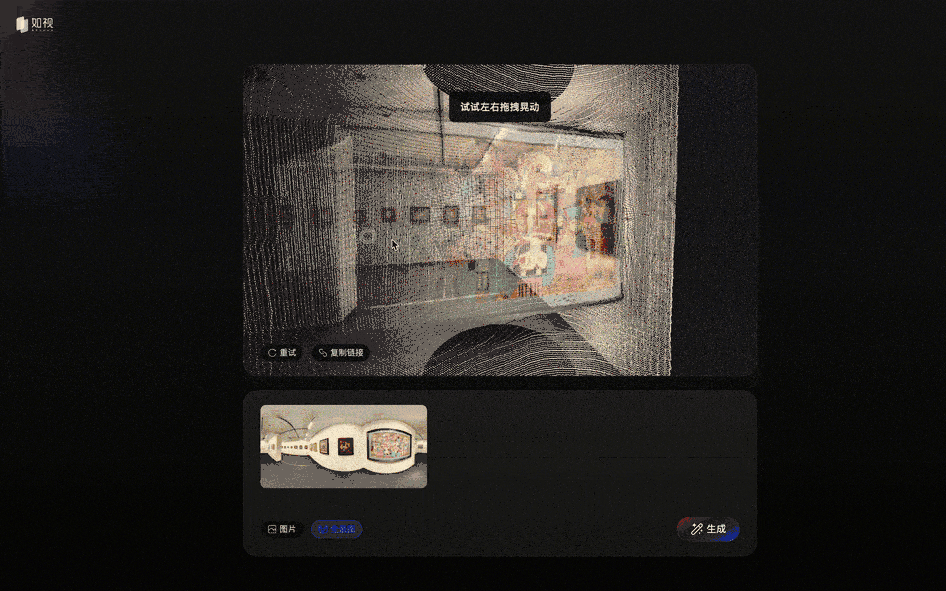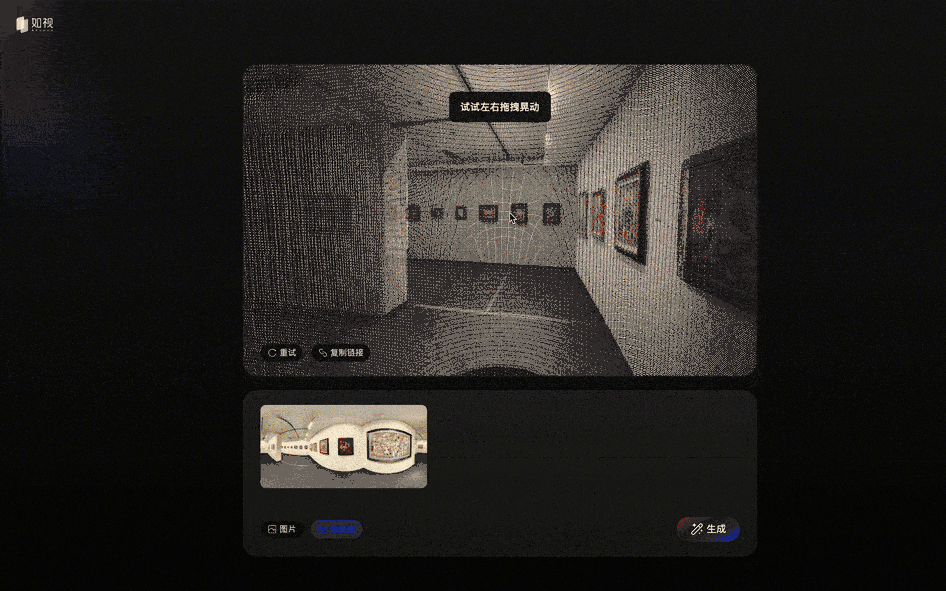
近来,世界模型(World Model)很火。多个 AI 实验室纷纷展示出令人惊艳的 Demo:仅凭一张图片甚至一段文字,就能生成一个可交互、可探索的 3D 世界。这些演示当然很是炫酷,它们展现了 AI 强大的生成能力。
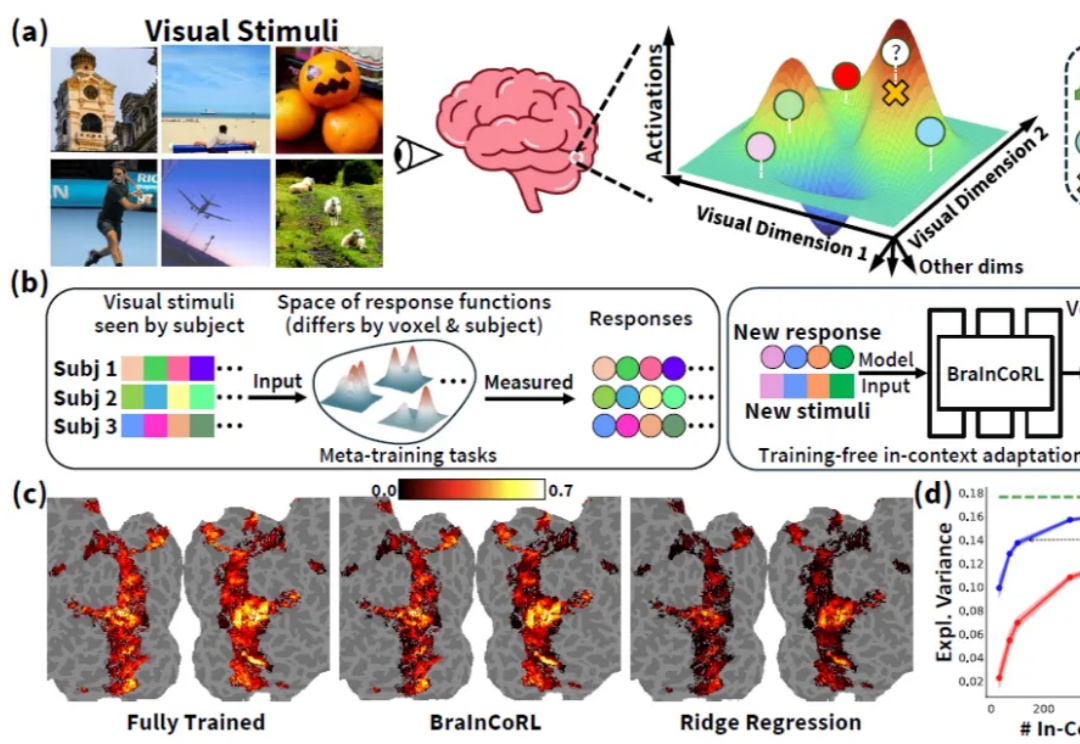
人类高级视觉皮层在个体间存在显著的功能差异,而构建大脑编码模型(brain encoding models)—— 即能够从视觉刺激(如图像)预测人脑神经响应的计算模型 —— 是理解人类视觉系统如何表征世界的关键。传统视觉编码模型通常需要为每个新被试采集大量数据(数千张图像对应的脑活动),成本高昂且难以推广。