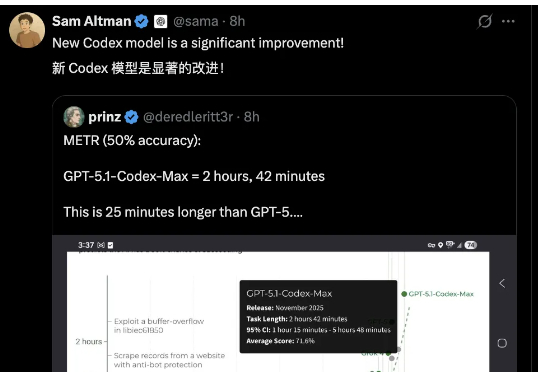
狙击Gemini 3!OpenAI发布GPT-5.1-Codex-Max
狙击Gemini 3!OpenAI发布GPT-5.1-Codex-MaxGemini 3力压全场,OpenAI坐不住了。发布Codex新版本——GPT-5.1-Codex-Max,突破上下文窗口限制,实现跨越数百万token的长时间连续工作,最长超过24小时的那种。
来自主题: AI资讯
10417 点击 2025-11-20 20:29

 搜索
Gemini 3力压全场,OpenAI坐不住了。发布Codex新版本——GPT-5.1-Codex-Max,突破上下文窗口限制,实现跨越数百万token的长时间连续工作,最长超过24小时的那种。
最近,我越来越沉迷刷小红书了。
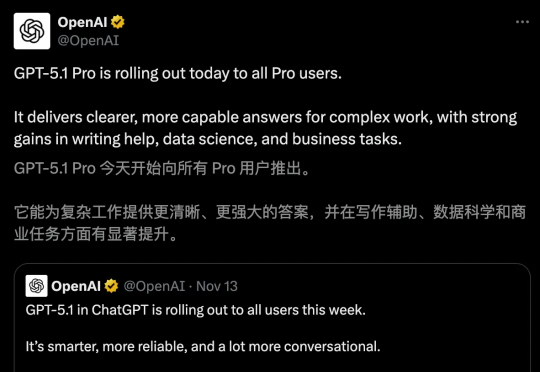
AI圈一日一更的频率,真的是有点跟不住了....前两天,先是Grok 4.1、Gemini 3 Pro发布,今天OpenAI GPT-5.1 Pro也静默登场了! 众所周知,GPT-5.1主打「情商智商」双强,Pro无疑将这两大优势推向更高层次。
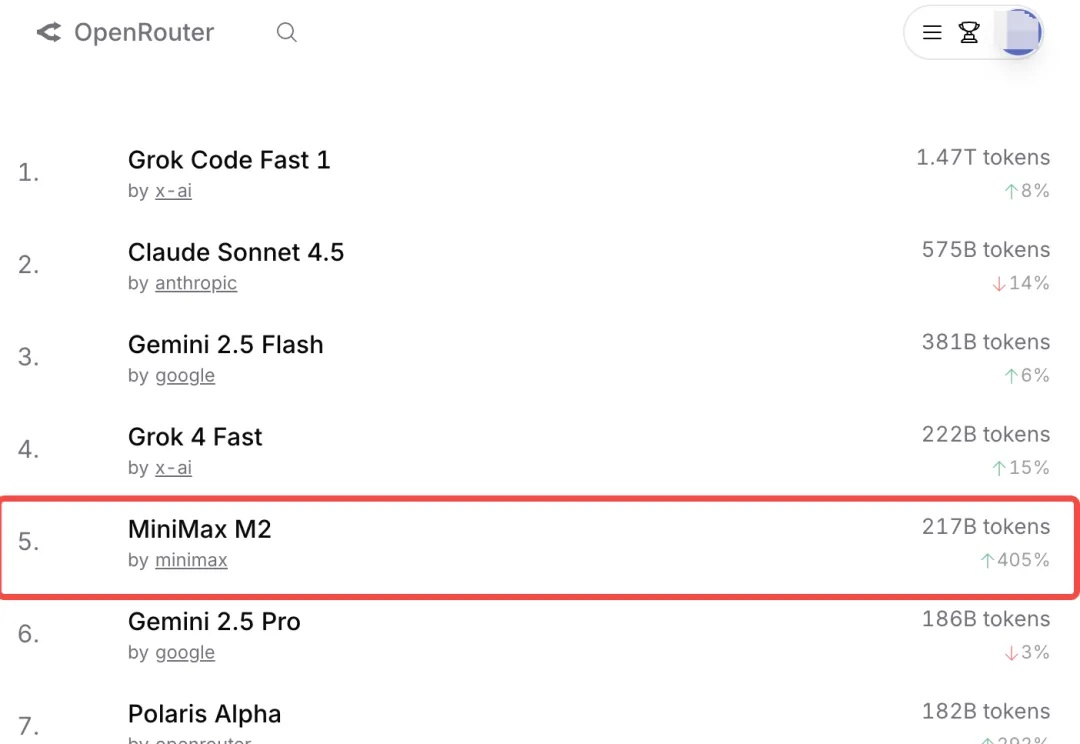
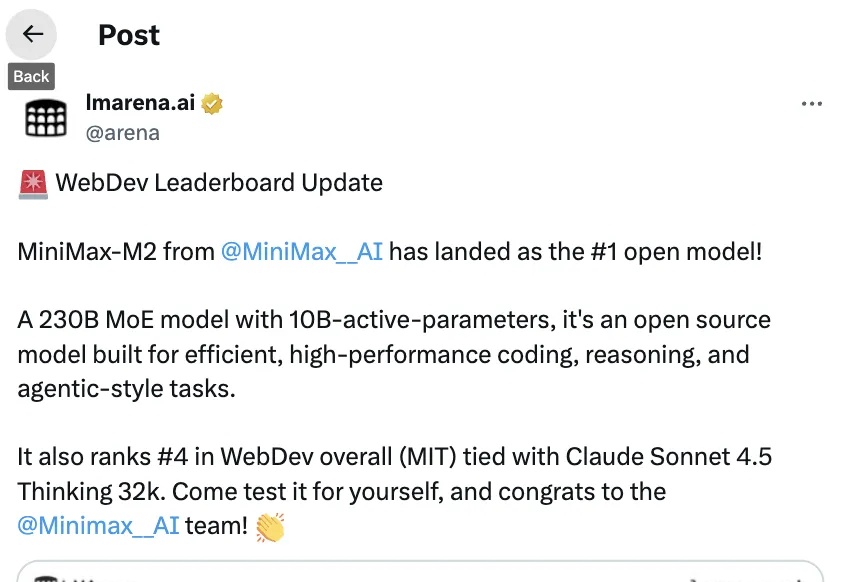
MiniMax,今年真猛。

正好上周(10月27日),MiniMax 公司发布了[2] M2 模型,代表了国产大模型的最新水平。我就想,可以测测它的实战效果,跟智谱公司的 GLM 4.6 和 Anthropic 公司的 Claude Sonnet 4.5 对比一下。毕竟它们都属于目前最先进的编程大模型,跟我们开发者切身相关。
新乐子来了。 10个AI大模型,券商账户实时交易,勇闯美股。 除了老面孔GPT、Claude、Gemini、Grok、Qwen、DeepSeek,这次四个国产新玩家,豆包、Minimax、Kimi、文心也加入战场。昨晚,首战正式开赛,豆包已经一马当先,开始了开门红。
生成式AI技术的成熟,让智能编程逐渐成为众多开发者的日常,然而一个大模型API选型的“不可能三角”又随之而来:追求顶级、高速的智能(如GPT-4o/Claude 3.5),就必须接受高昂的调用成本;追求低成本,又往往要在性能和稳定性上做出妥协。开发者“既要又要”的正义,谁能给?
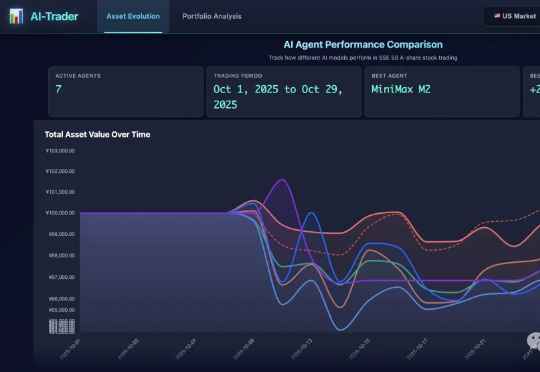
屠榜开源大模型的MiniMax M2是怎样炼成的?为啥M1用了Linear Attention,到了M2又换成更传统的Full Attention了? 面对现实任务,M2表现得非常扛打,在香港大学的AI-Trader模拟A股大赛中拿下了第一名,20天用10万本金赚了将近三千元。
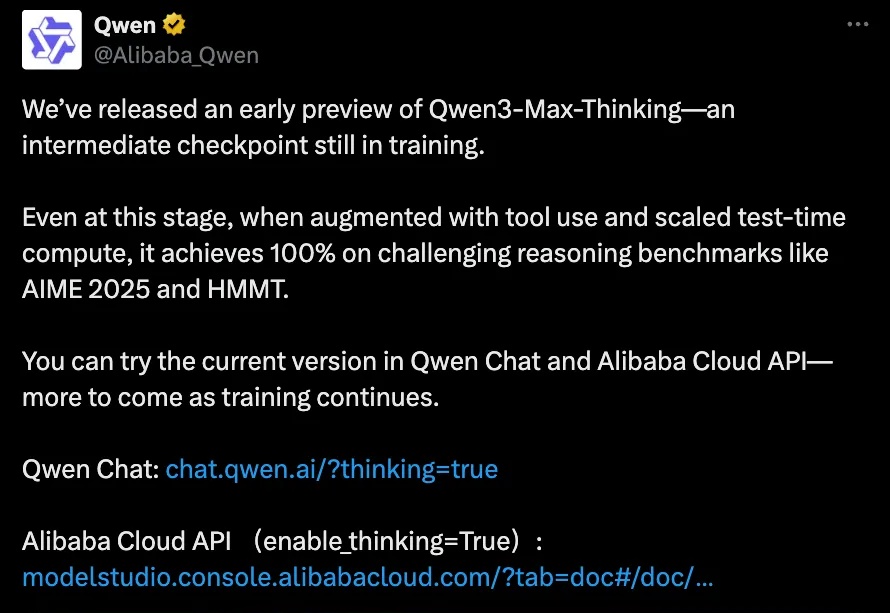
半成品模型,已经刷下高难度数学推理测试AIME 25满分战绩。
Qwen 团队终于在周日的晚上, 兑现了本周会更新Qwen3-Max thinking 的承诺。 而这个更新, 基本也是上周所有更新中为数不多非常期待的了。 毕竟Qwen3-Max也是Qwen整个家族里最大、最强的模型,