ECCV2024 Oral | 第一视角下的动作图像生成,Meta等提出LEGO模型
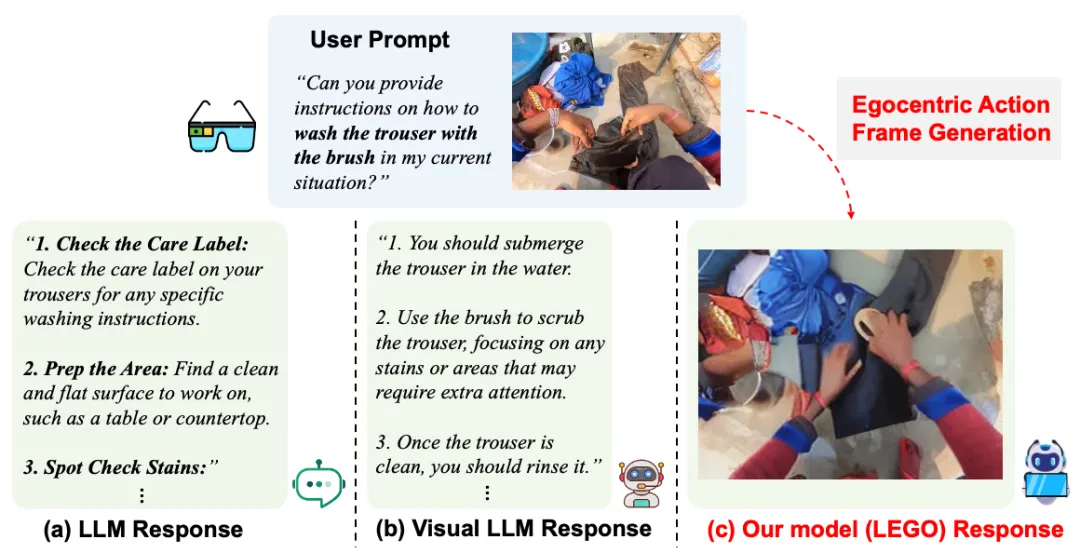
ECCV2024 Oral | 第一视角下的动作图像生成,Meta等提出LEGO模型如何基于用户的问题和当前场景的照片,生成同一场景下的第一视角的动作图像,从而更准确地指导用户执行下一步行动?
来自主题: AI资讯
5333 点击 2024-10-02 11:22

 搜索
如何基于用户的问题和当前场景的照片,生成同一场景下的第一视角的动作图像,从而更准确地指导用户执行下一步行动?

字节&复旦大学多模态理解大模型来了:可以精确定位到视频中特定事件的发生时间。