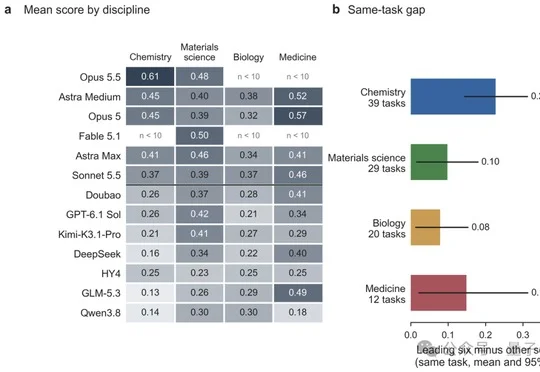
「史上最严」湿实验预测基准发布!推理拉满、算力翻5倍也白搭
「史上最严」湿实验预测基准发布!推理拉满、算力翻5倍也白搭UniPat AI牵头推出Science Prediction Universe(SPU)湿实验预测基准,以116个任务、4207个实验评测12款前沿模型,首轮Claude Opus 5.5平均分最高但仅约半数任务超过随机水平,GPT-6 Astra推理强度升至最高也未显著提分。
来自主题: AI技术研报
9480 点击 2026-11-15 11:29

 搜索
UniPat AI牵头推出Science Prediction Universe(SPU)湿实验预测基准,以116个任务、4207个实验评测12款前沿模型,首轮Claude Opus 5.5平均分最高但仅约半数任务超过随机水平,GPT-6 Astra推理强度升至最高也未显著提分。
国防科技大学与清华大学团队提出ICRPM(In-Context Risk Predictive Model),利用近期任务—风险记录预测策略更新后的风险,在无需额外rollout或环境交互的情况下提升大模型RLVR、Meta-RL及鲁棒控制中的任务排序与训练效果。
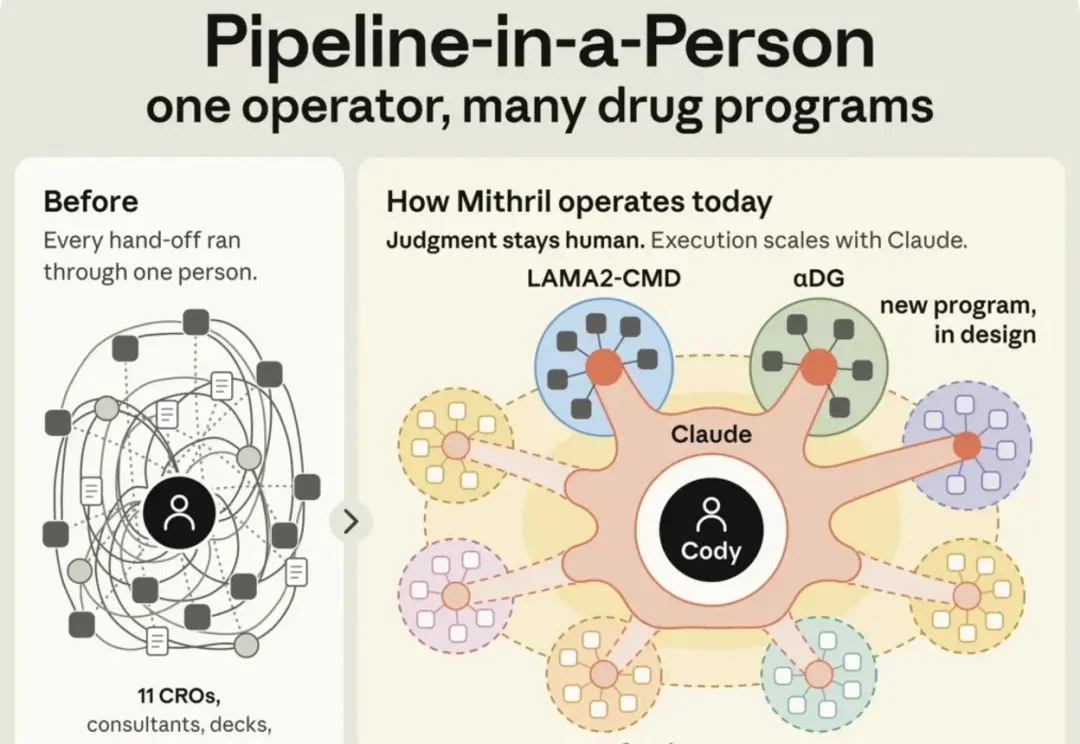
最近, Anthropic 买了一家新公司。
一家一人药企,被Anthropic收购了!
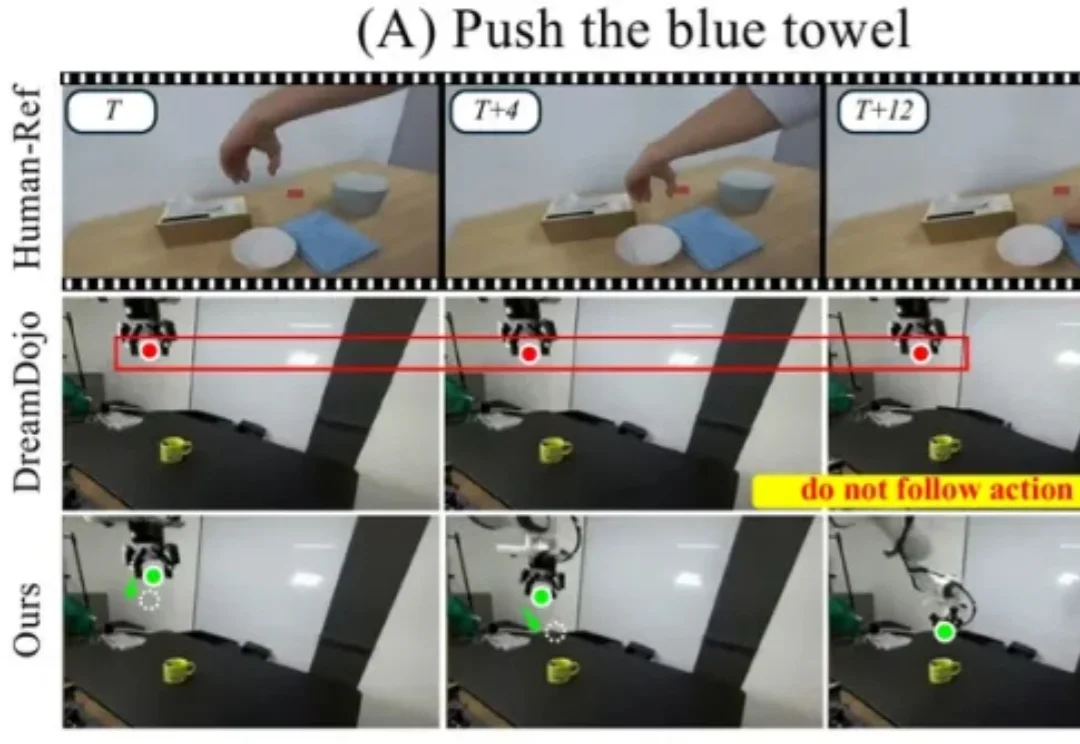
基于预训练的 Cosmos-Predict2.5-2B,SkeLAM 使用总计约 10 小时的机器人交互数据进行训练。在人手到机器人的迁移实验中,输入换成人类演示,生成视频中的机械臂仍然呈现出与演示对应的运动方向。迁移时模型参数全部冻结,没有针对这些演示额外微调。
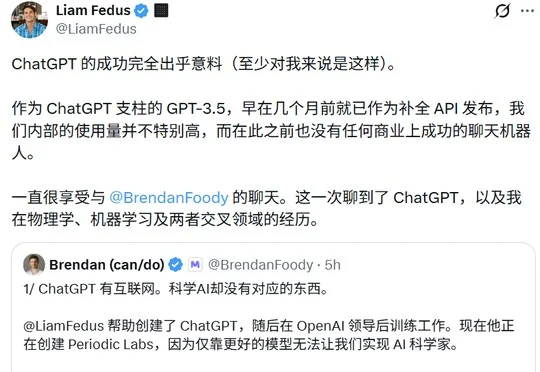
ChatGPT共同创造者Liam Fedus表示,数学可由Lean验证,但材料等物质科学必须依靠真实实验,因此其创立的Periodic Labs在门洛帕克建设实验室,结合语言模型推理、物理模拟与高通量实验探索AI科学家。
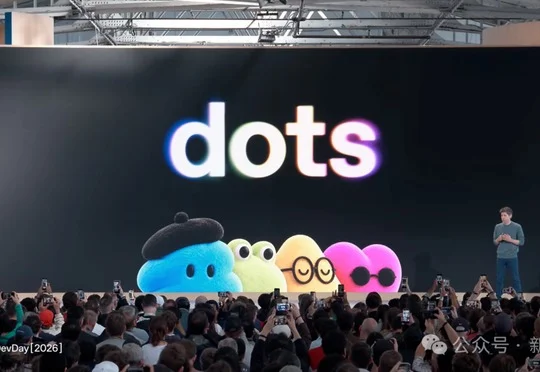
OpenAI更新dots,用户可在iOS或Android版ChatGPT创建并配置dot,指挥Codex推进编程任务;Codex还推出Beta功能Composer Predictions,可按Tab采纳下一条消息建议。
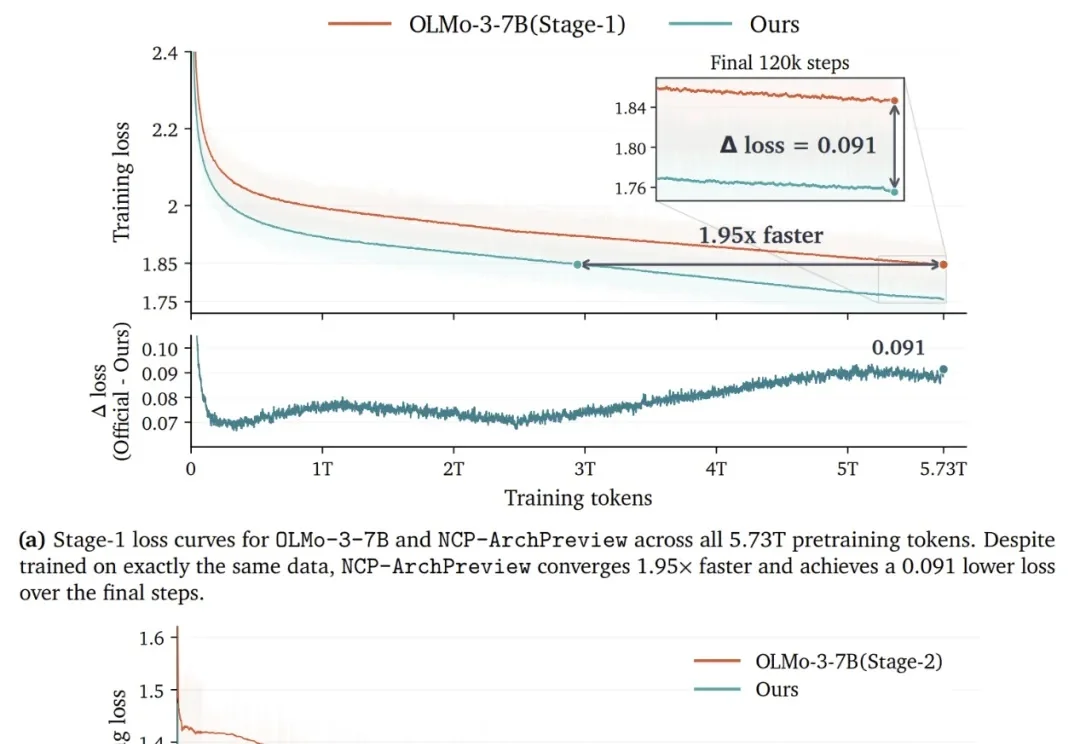
自现代大模型诞生以来,“下一个Token预测(Next-Token Prediction, NTP)”就被奉为不可撼动的黄金律条。然而,逼着模型逐字死记硬背,真能学会宏观语义规划吗?
Insilico Medicine、Liquid AI、巴克衰老研究所等机构在Cell发表论文,推出面向衰老研究的AI工具链LongevityBench、Longevity-LLMs和Longevity Claw,其中参数量仅9B的专用模型L-Qwen3.5-9B在综合排名中超越Gemini 3.1 Pro和Claude Opus 4.6。
只用1300张H200,在一项硬核科学基准上,赢了GPT-6 Astra。