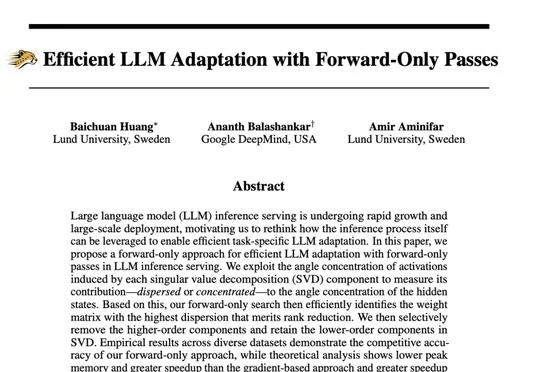
NeurIPS 2026 | 如何让LLM在推理中不断进化
NeurIPS 2026 | 如何让LLM在推理中不断进化隆德大学与Google DeepMind提出仅前向搜索方法,利用LLM前向传播中激活值的角度集中度筛选SVD秩并实施降秩,在无需反向传播的情况下实现下游任务自适应,较LASER-Grad降低峰值内存并提高加速比。
来自主题: AI技术研报
6225 点击 2026-11-21 11:34

 搜索
隆德大学与Google DeepMind提出仅前向搜索方法,利用LLM前向传播中激活值的角度集中度筛选SVD秩并实施降秩,在无需反向传播的情况下实现下游任务自适应,较LASER-Grad降低峰值内存并提高加速比。
DeepMind在博客文章《AGI 之后是什么?》中提出,AGI并非终点,并从扩大模型与数据规模、推动技术范式转变、提升多智能体协作和递归自我改进四方面探讨通往ASI的路径,同时强调建立衡量、预测与治理体系。
聚是一团火,散是满天星。
很多人之前都跟我说,能不能分享一些DeepSeek Harness的好用的用法和插件,正好,前几天,DeepSeek限额冲上了热搜。
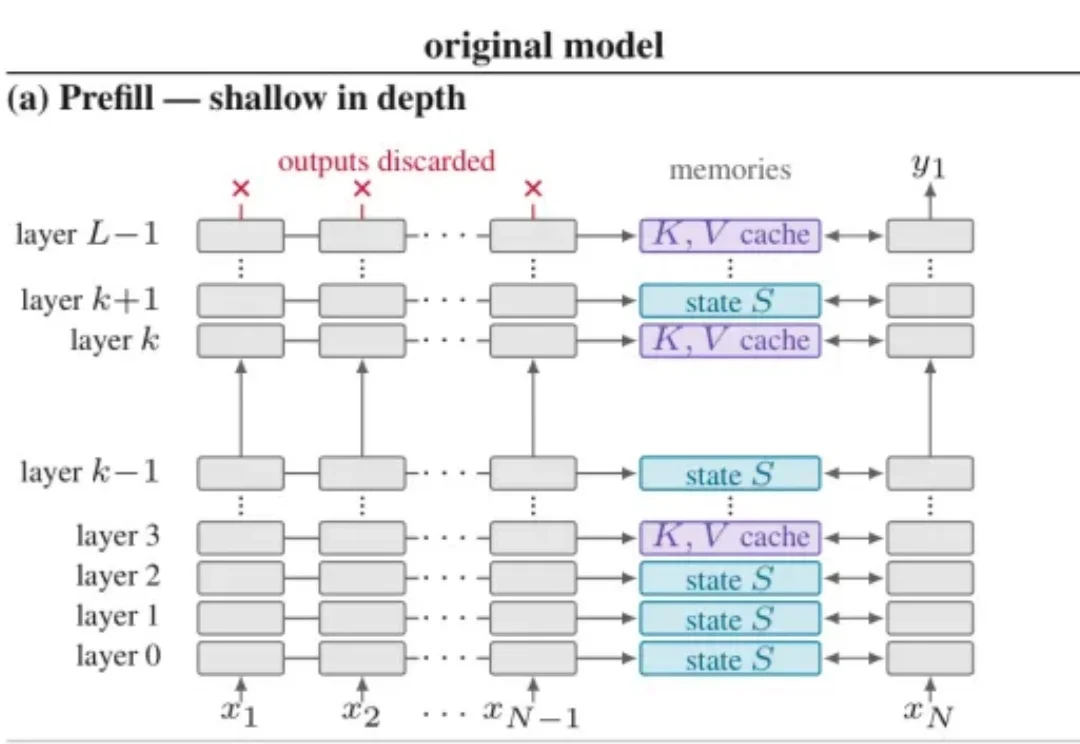
Qwen3.8-Flash-Next 有 48 层。处理一段输入时,SEED 让除最后一个以外的 token 只运行前 31 层,再由轻量的记忆写入组件,为后续 17 层生成 KV Cache 和循环状态。到了生成阶段,每个 token 仍然运行完整的 48 层。
让四家国产大模型同样的金融分析任务:只有 Qwen4-Max 默认档的 Excel 打开重算无错误值,DeepSeek 最便宜,Kimi 最慢也最贵。
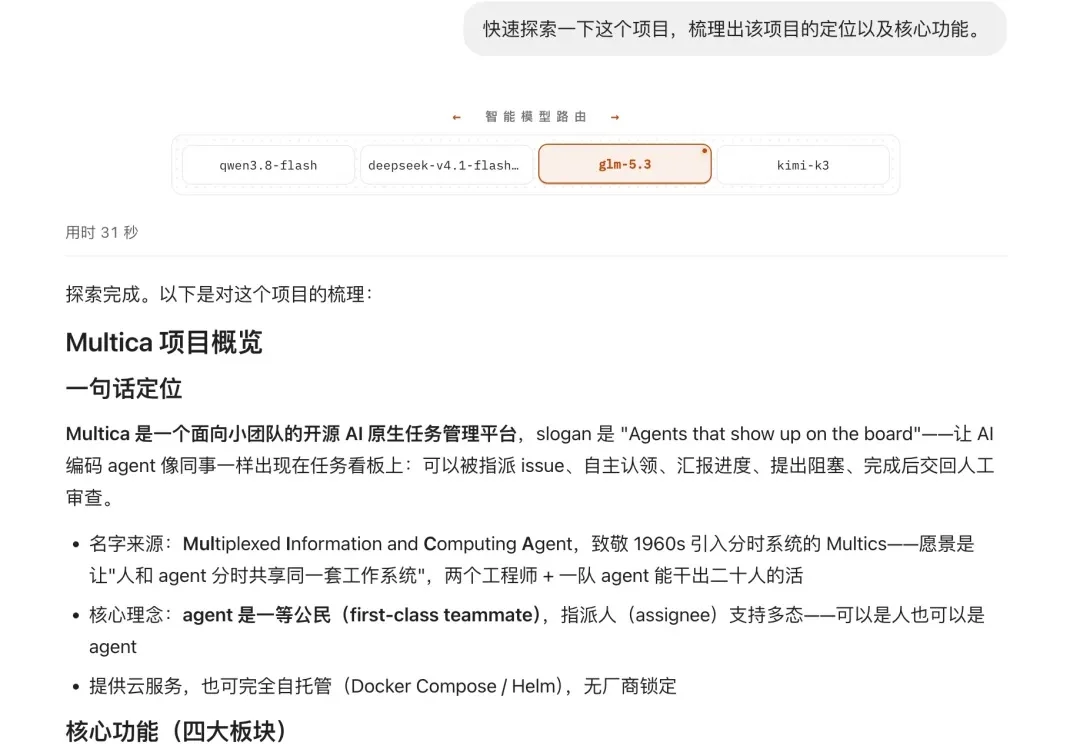
国产模型当中,DeepSeek 写文档最有人味,GLM-5.3 写代码性价比最高,Kimi 做前端最好看。
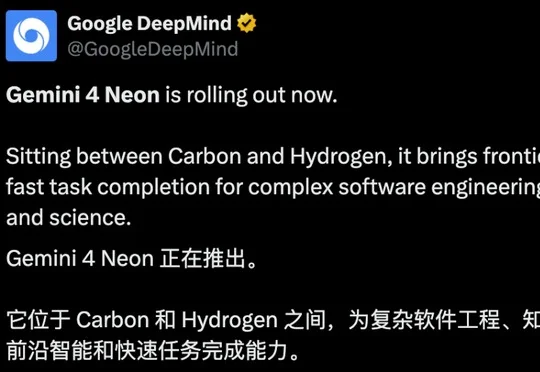
谷歌发布Gemini 4 Neon,主打复杂编程、推理及企业工作流中的更快、更省体验;谷歌DeepMind同时宣布世界模型Genie 4正式上线,支持会话中用自然语言改变环境和原生音频。
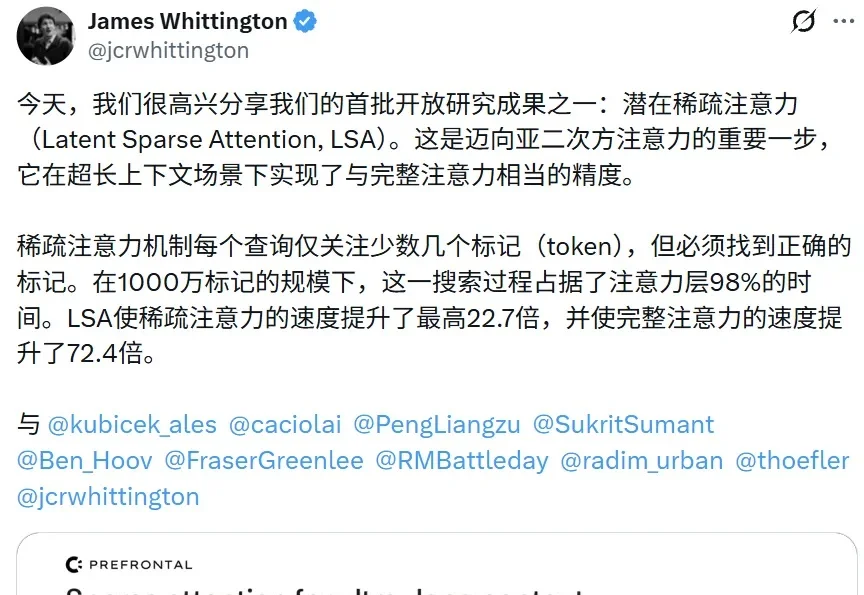
如今,百万 token 上下文已经从卖点变成了标配。4 月,DeepSeek-V4 把 1M 上下文定为所有官方服务的默认规格;8 月,智谱发布的 GLM-5.3-Flash 同样支持 1M 上下文,并首次在 GLM 系列中引入稀疏注意力与线性注意力的混合架构。这些模型背后有一个共同的选择:让每个 query 不再看遍所有历史 token,只挑出少数最相关的去「看」。
给“机器人战场”建立新坐标。