NeurIPS'26 | 港科大:从CPU到GPU,AI能否真正加速全流程?
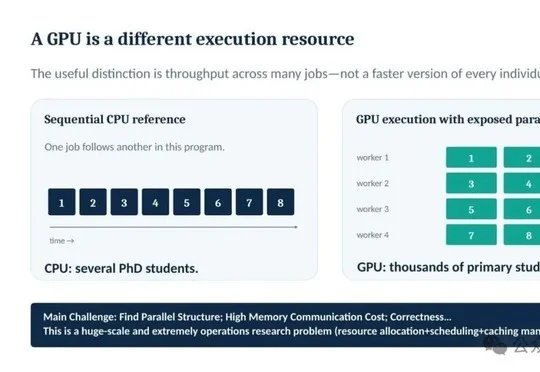
NeurIPS'26 | 港科大:从CPU到GPU,AI能否真正加速全流程?港科大团队在NeurIPS 2026上提出AccelEval基准,覆盖6个领域42项任务和43类CUDA优化策略,评测大模型能否从可信CPU程序生成端到端更快的GPU实现,其中Gemini 3.1 Pro在中规模通过正确性验证的任务上取得71.2倍几何平均加速比。
搜索
港科大团队在NeurIPS 2026上提出AccelEval基准,覆盖6个领域42项任务和43类CUDA优化策略,评测大模型能否从可信CPU程序生成端到端更快的GPU实现,其中Gemini 3.1 Pro在中规模通过正确性验证的任务上取得71.2倍几何平均加速比。
华为鲲鹏在HC 2026上发布鲲鹏超节点全面升级,支持4096节点组网和百TB级统一内存池,面向Agentic AI时代构建"通算+智算"协同的智能体底座,配合鲲鹏920、鲲鹏950处理器及openEuler等四大基础软件,已在京东618等场景落地验证。
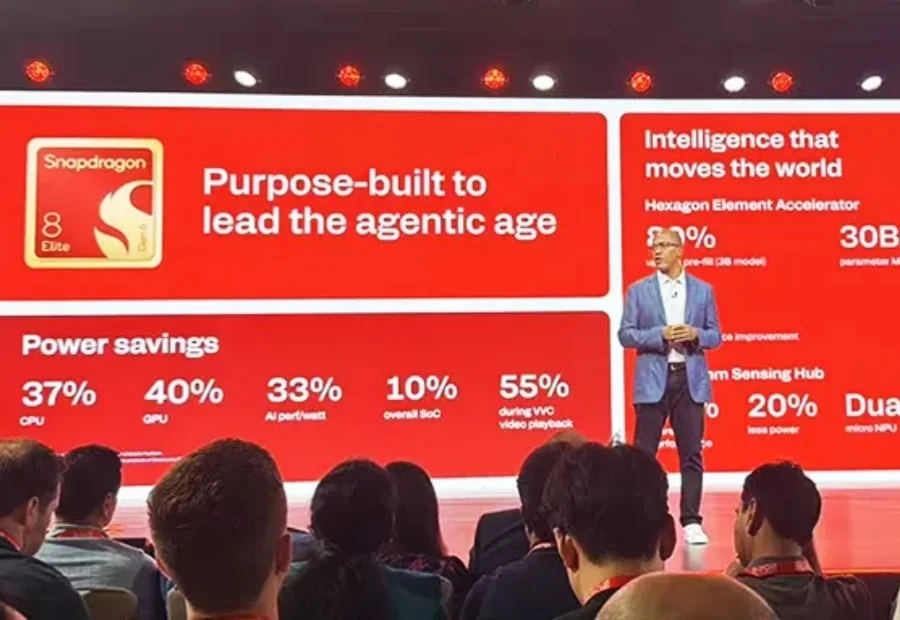
骁龙首次双旗舰齐发,最高8核CPU、GPU内置AI核、NPU内存扩容,安卓旗舰大战正式开打。
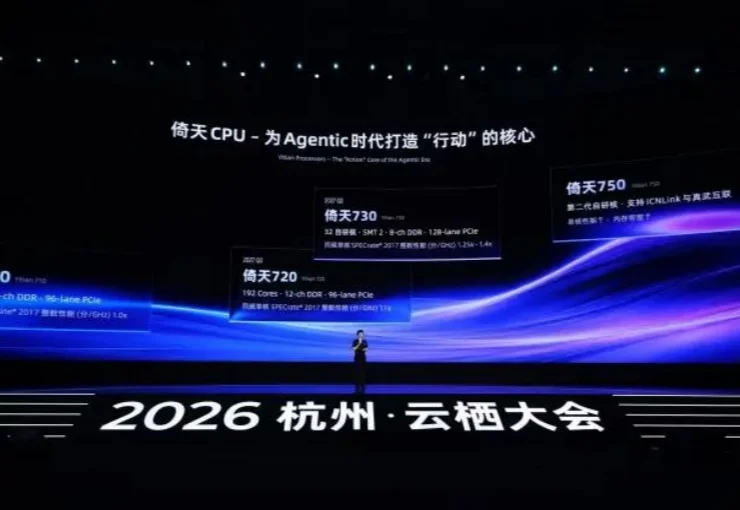
CPU的价值,在Agent时代,真的需要被重估了。
从真武 V900 到新一代磐久超节点服务器,平头哥八年来陆续布局的 AI 芯片、CPU、scale up 互联、scale out 网络和存储芯片,开始被装进同一套算力系统。
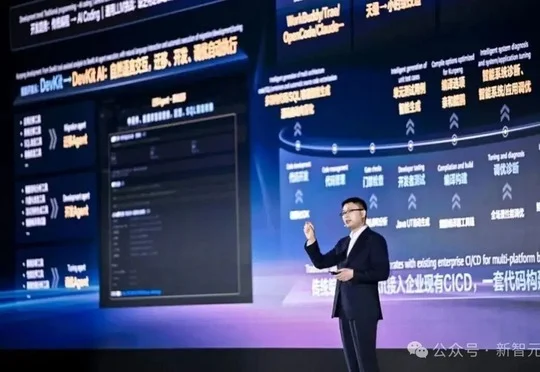
拿Agent做Coding,想必大家都已经很熟悉了。
高通提前剧透下一代骁龙旗舰移动平台的核心升级:Oryon CPU首次实现5GHz主频并引入动态缓存架构FlexCache,Hexagon NPU推出Element Accelerator与更大共享内存,Adreno GPU首次加入Matrix Cores并集成AI图形渲染技术Adreno Neural Fusion,全面强化端侧智能体AI性能与体验。
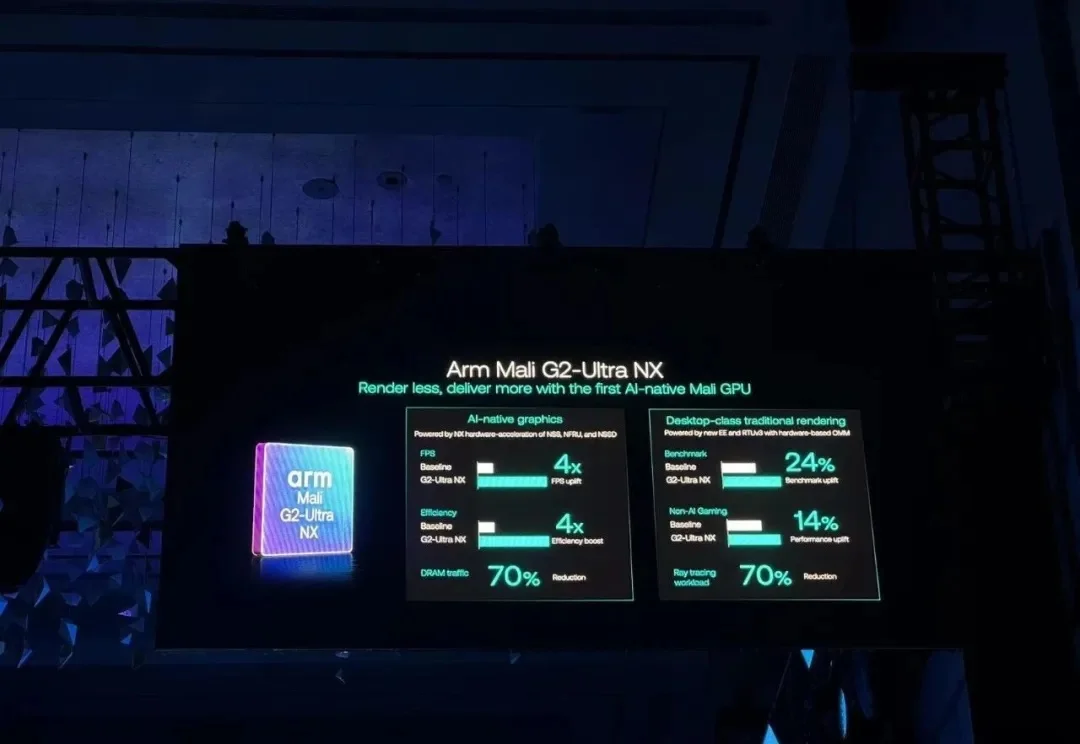
以后手机GPU渲染游戏画面,不用再吭哧吭哧把每个像素都算出来了。
谷歌Antigravity团队公布Teamwork多智能体编排框架成果,轻量级Gemini 3.7 Flash复现了Gemini 3.1 Pro解出的3道博士级数学难题,并从零构建RISC-V CPU模拟器、改进Eigen和ParlayHash开源库代码,证明小模型通过制度化博弈编排也能完成顶尖科研与工程任务。
ChatGPT Work于8月25日上线云浏览器登录功能,背后的云电脑配有约9个虚拟CPU和15GB内存,可在网页和手机端自动登录网站处理订狗粮、保险报销等任务,而密码对AI不可见,标志着该智能体首次跨越登录墙真正替用户办完事。