Claude 被封号后我找到了新的办公搭子
Claude 被封号后我找到了新的办公搭子Claude 账号被封后,作者实测豆包工作和腾讯 WorkBuddy 处理人物稿、日历、销售报表及 PPT,认为豆包工作更省额度,并可先用 DeepSeek V4.1 Flash 找资料、再用 Kimi K3.1 Pro 写稿以降低成本。
来自主题: AI资讯
8127 点击 2026-11-15 11:30

 搜索
Claude 账号被封后,作者实测豆包工作和腾讯 WorkBuddy 处理人物稿、日历、销售报表及 PPT,认为豆包工作更省额度,并可先用 DeepSeek V4.1 Flash 找资料、再用 Kimi K3.1 Pro 写稿以降低成本。
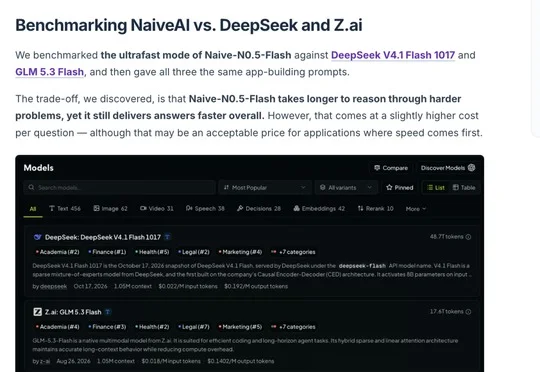
Latent Space实测显示,NaiveAI开源模型Naive-N0.5-Flash综合能力介于DeepSeek V4.1 Flash 1017与GLM 5.3 Flash之间,编程单项评测反超,峰值速度约2100 Token/s,3D太阳系任务表现最佳。
DeepSeek 正式开放全家桶 API,V4.1-Flash(deepseek-flash)支持联网搜索、文件解析、链接阅读、语音交互及 Search、Fetch、OCR、ASR、TTS 独立调用,并开源聊天应用 Demo,降低开发者打造个性化超级 App 的门槛。
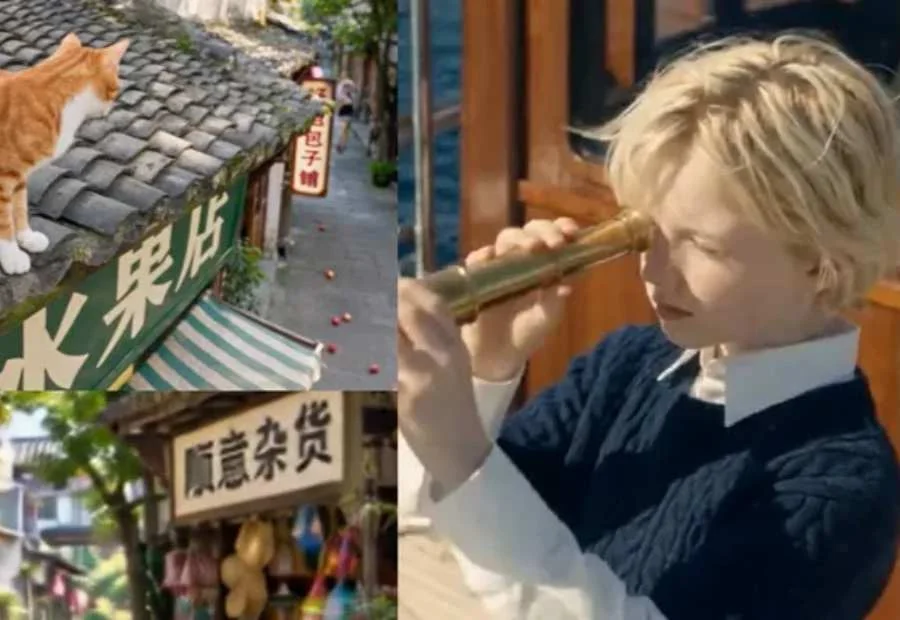
单段最长支持30秒视频生成。
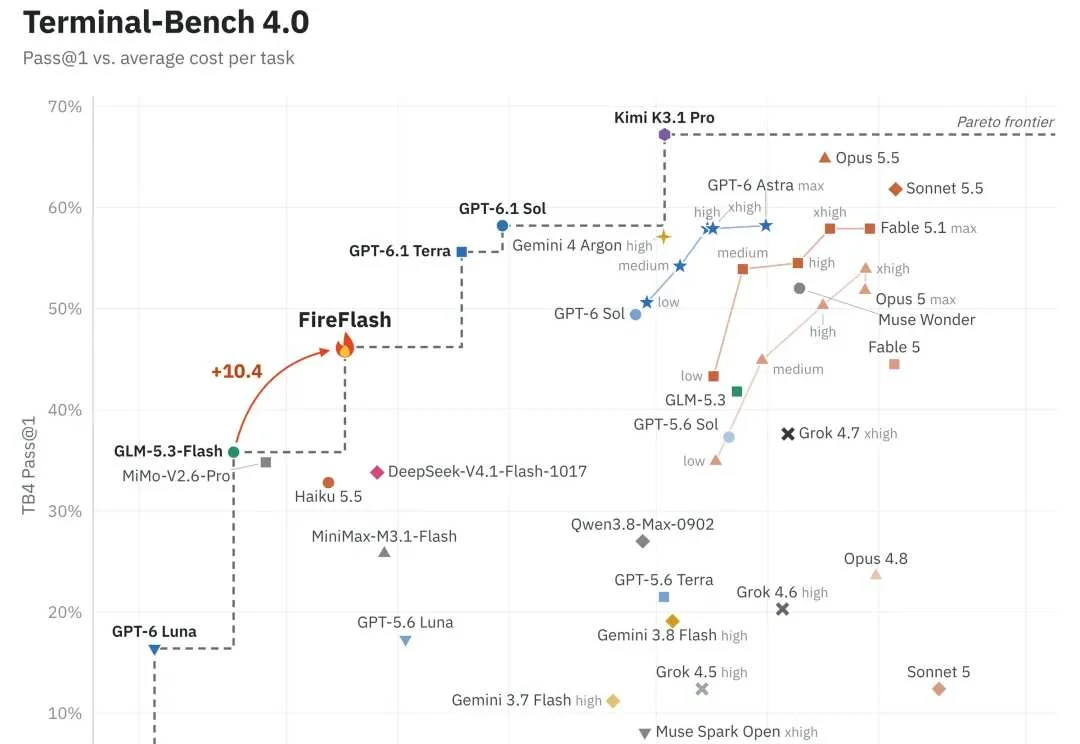
长程智能体(long-horizon agents)正从「修一个 bug」走向连续数小时的终端与编程工作,但它的强化学习训练也格外昂贵:前沿实验室可以在数千张 GPU 上扩展 RL,而对多数团队来说,一条训练样本往往就是一次长达 3 小时、上百轮工具调用的完整尝试,任何一个环节出错,浪费的都是成小时的 GPU 时间。
今天,百度文心亮出了最新模型:文心 5.5 Flash Preview(ERNIE 5.5 Flash Preview),正式发布!
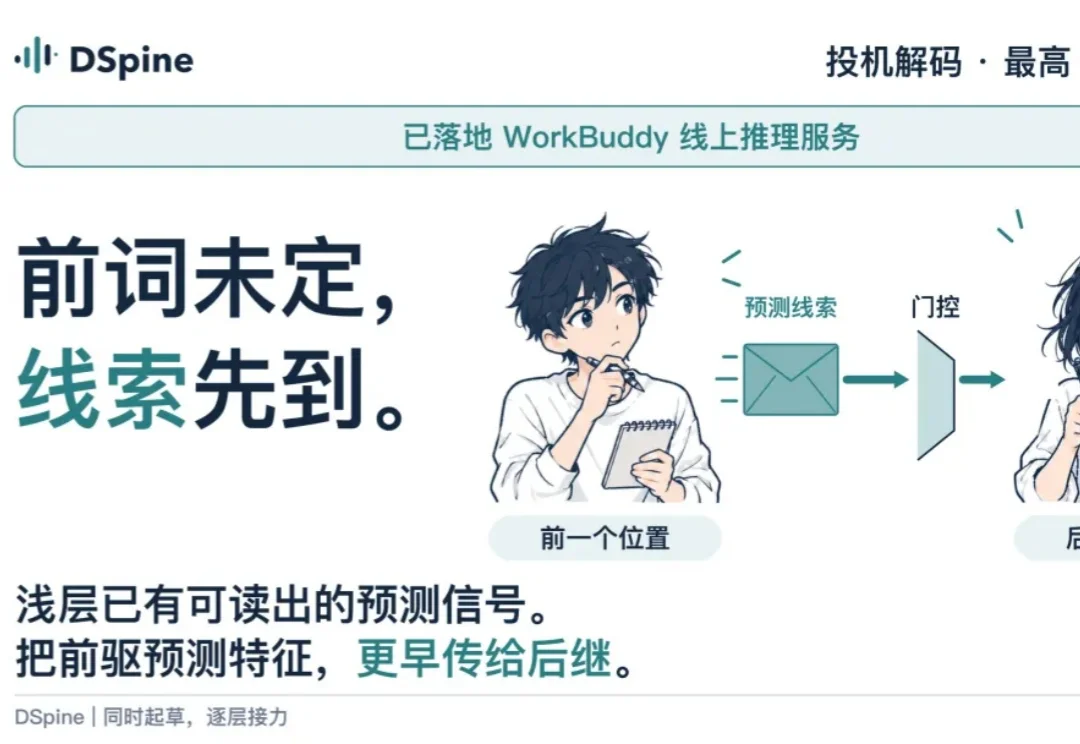
在大型语言模型(LLM)的无损推理加速中,推测解码(Speculative Decoding)已成为工业界标配。以 EAGLE-3 为代表的自回归草稿模型虽然预测准,但每多猜一个 token 就要多跑一步串行前向;而受扩散语言模型启发的 DFlash 将草稿生成彻底并行化 —— 一次骨干网络前向即可同时吐出整块候选 token,大幅压缩了起草耗时。
NaiveAI开源的Naive-N0.5-Flash已让普通玩家在个人电脑上完成数据处理、训练、评测与纠错,覆盖客服、游戏和机器人控制等任务,推动Vibe Training与递归自我改进落地。
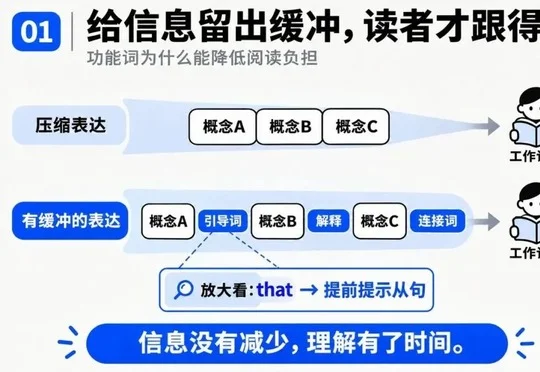
文章分析前沿模型文字难懂的原因,指出 Google 通过 LearnLM 将易读性、命题保真度、认知负荷管理和强化学习后训练融入 Gemini 2.5 Pro 与 Flash,并介绍 UIDPO 和修辞结构对齐两种认知对齐路径。
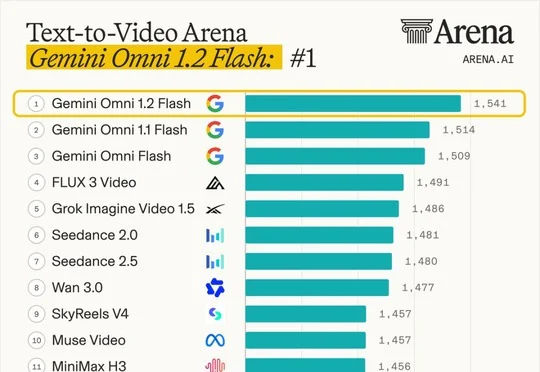
谷歌发布新一代视频模型 Gemini Omni 1.2 Flash,登顶Arena文生视频和图生视频双榜,支持3至15秒生成、多轮对话编辑及4K放大,价格较上一代降低30%,15秒720p视频仅需1.05美元。