AI资讯新闻榜单内容搜索-8

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: 8
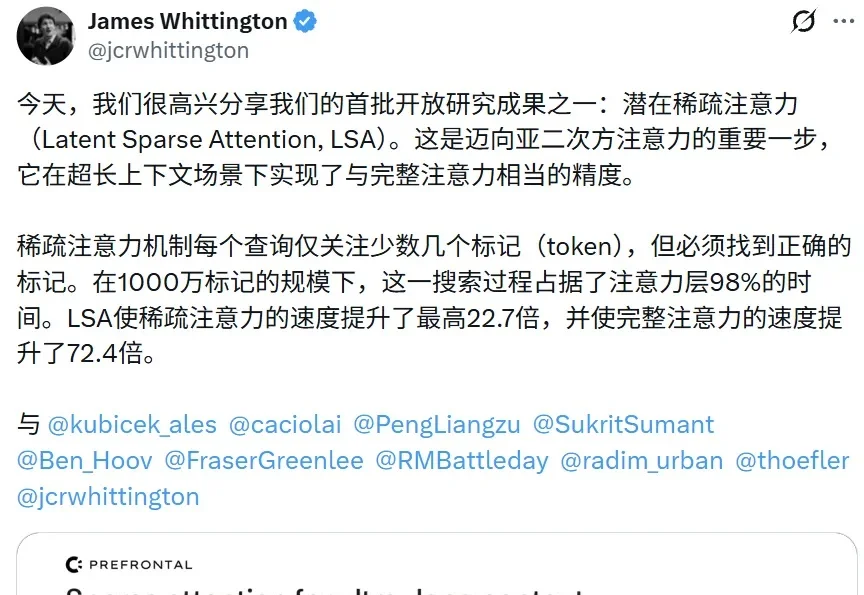
千万token下,比DeepSeek式稀疏注意力再快22倍

千万token下,比DeepSeek式稀疏注意力再快22倍

千万token下,比DeepSeek式稀疏注意力再快22倍

如今,百万 token 上下文已经从卖点变成了标配。4 月,DeepSeek-V4 把 1M 上下文定为所有官方服务的默认规格;8 月,智谱发布的 GLM-5.3-Flash 同样支持 1M 上下文,并首次在 GLM 系列中引入稀疏注意力与线性注意力的混合架构。这些模型背后有一个共同的选择:让每个 query 不再看遍所有历史 token,只挑出少数最相关的去「看」。

来自主题: AI技术研报
9470 点击    2026-11-17 16:25
Fable 5.2疑心重,知道自己在被测试!避免犯错反而赚钱少了

Fable 5.2疑心重,知道自己在被测试!避免犯错反而赚钱少了

Fable 5.2疑心重,知道自己在被测试!避免犯错反而赚钱少了

11 月 9 日,Anthropic 发布了新模型 Claude Fable 5.2,它很厉害,带 1000 个分身在 30 小时内做完了费马大定理的形式化证明,解开两道黑洞和量子引力难题,还花 8 天从零写出一套能在笔记本上开机的操作系统。

来自主题: AI资讯
6289 点击    2026-11-17 16:24
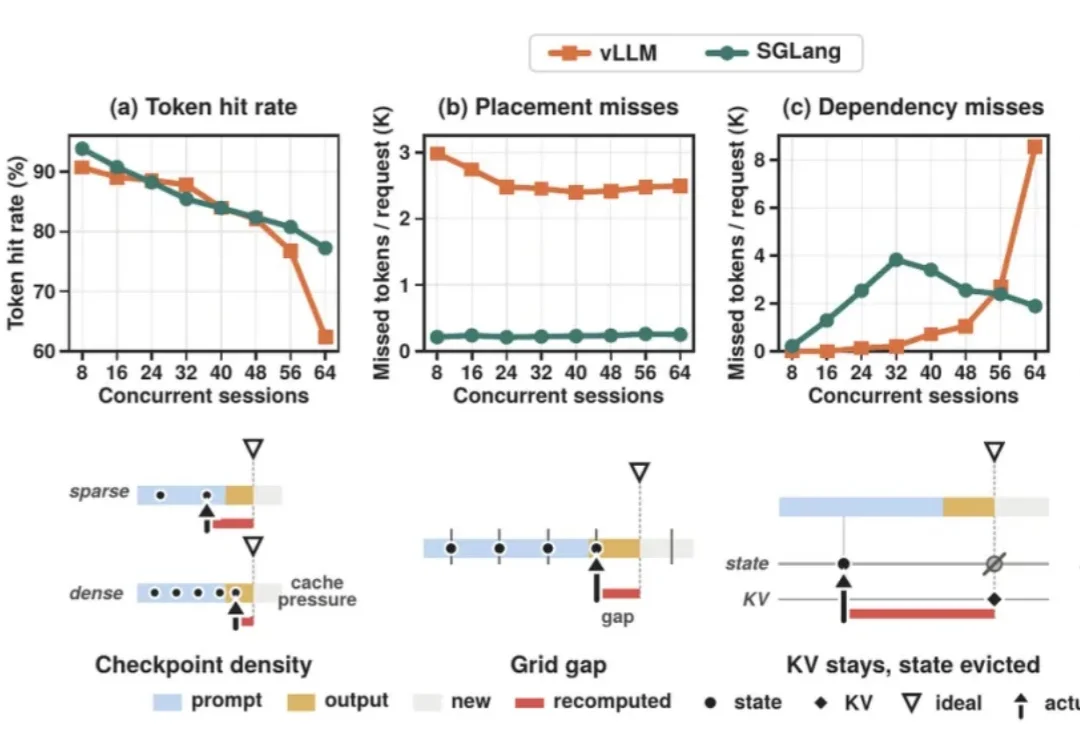
混合架构模型跑Agent,预填充吞吐再提升3倍!FlashStates重新设计混合状态缓存

混合架构模型跑Agent,预填充吞吐再提升3倍!FlashStates重新设计混合状态缓存

混合架构模型跑Agent,预填充吞吐再提升3倍!FlashStates重新设计混合状态缓存

Kimi Delta Attention(KDA)、Gated DeltaNet(GDN)、Mamba-2 等线性注意力与状态空间层,正在成为开源大模型的常见组件。Kimi K3.1 Pro、GLM-5.3-Flash、Qwen3.8-Flash-Next、Nemotron 3 Super 都采用了「全注意力 + 线性层」的混合架构,以换取更快的解码和更小的 KV Cache。

来自主题: AI技术研报
8919 点击    2026-11-17 10:05
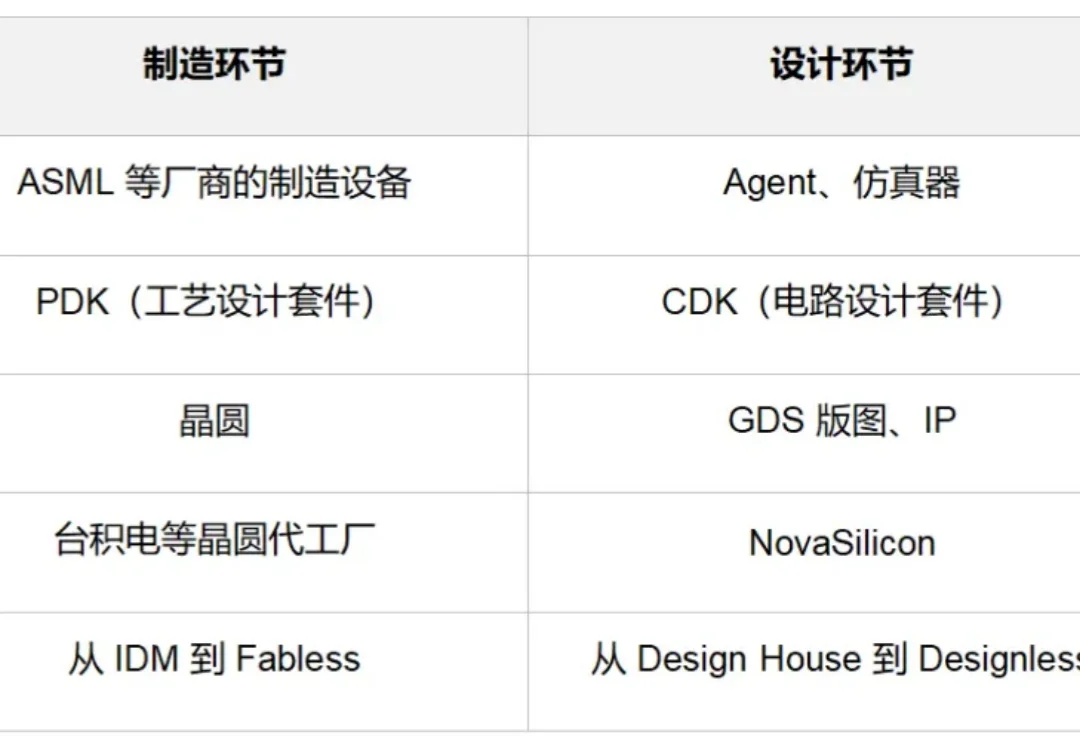
自研Agent两场实测均分超过GPT-6,NovaSilicon首提CDK,Fabless之后是Designless?

自研Agent两场实测均分超过GPT-6,NovaSilicon首提CDK,Fabless之后是Designless?

自研Agent两场实测均分超过GPT-6,NovaSilicon首提CDK,Fabless之后是Designless?

1987 年成立的台积电只做代工。晶圆厂把制造工艺封装成 PDK(Process Design Kit,工艺设计套件)交给客户,PDK 是晶圆厂的核心技术,通过有限接口分享给芯片公司 ,保留核心的制造配方。通过使用 PDK,芯片公司可以把制造交出去,自己专心做设计,这类公司被叫作 Fabless。

来自主题: AI技术研报
6065 点击    2026-11-16 15:43
Claude破译哥德尔天书!80年笔记震撼数学界:他离菲奖只剩最后一步

Claude破译哥德尔天书!80年笔记震撼数学界:他离菲奖只剩最后一步

Claude破译哥德尔天书!80年笔记震撼数学界:他离菲奖只剩最后一步

芬兰赫尔辛基大学逻辑学家Jan von Plato借助Claude解读哥德尔16本工作簿,梳理出663条定理雏形,其中400条经形式化验证成立,并还原了哥德尔接近证明选择公理独立性的关键论证。

来自主题: AI资讯
8222 点击    2026-11-15 11:31
2B模型拿下98.4%成功率!浙大VLA新成果让机器人学会状态变化

2B模型拿下98.4%成功率!浙大VLA新成果让机器人学会状态变化

2B模型拿下98.4%成功率!浙大VLA新成果让机器人学会状态变化

浙江大学ACES实验室OmniAI团队提出VLA-Δ,通过三类监督学习物理状态变化,基于2B视觉语言骨干在LIBERO取得98.4%的平均成功率,并在真实双臂机器人五类任务中取得68.0%的平均成功率。

来自主题: AI资讯
8140 点击    2026-11-15 11:30