
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
AI视频生成中,推理速度提升与生成质量下降,可能同时发生。
减少计算步骤可以缩短生成时间,但也可能引入误差累积;保留完整计算过程能够维持生成质量,却需要承担更高的算力与显存开销。
当视频生成从单次体验进入批量生产,问题不再只是模型能否生成视频,而是如何在生成质量、推理时延与资源成本之间取得平衡。
针对这一需求,是石科技正式发布新品「多模态模型服务」,将优化重点放在视频生成推理加速、缓存与显存管理、多模态Token压缩,以及素材理解与生成链路衔接上。
其中:
这些技术分别作用于不同环节,最终指向同一个目标:
在保障生成质量与服务稳定性的前提下,提高多模态模型的推理效率与算力利用率。
视频生成模型通常需要经过多轮迭代计算,逐步完成从初始信息到视频内容的生成。在这一过程中,相邻计算步骤之间存在可复用的信息。
如果每一步都执行完整计算,会产生较高的推理开销;但如果直接跳过部分步骤或复用历史结果,缓存误差又可能随迭代不断累积,最终影响生成质量。
因此,视频推理加速的关键,并不是简单减少计算次数,而是判断哪些计算可以安全复用,以及何时需要重新计算来控制误差。
是石科技采用基于历史缓存残差的自适应加速技术,通过历史计算信息评估缓存复用风险,并动态调整计算与刷新策略。
对于变化较小的计算部分,系统复用历史结果,减少重复计算;对于误差风险较高的关键部分,则触发重新计算与校准,降低缓存误差对后续生成过程的影响。通过动态刷新与误差校准机制,系统在减少计算开销的同时,尽可能维持视频生成轨迹的一致性。

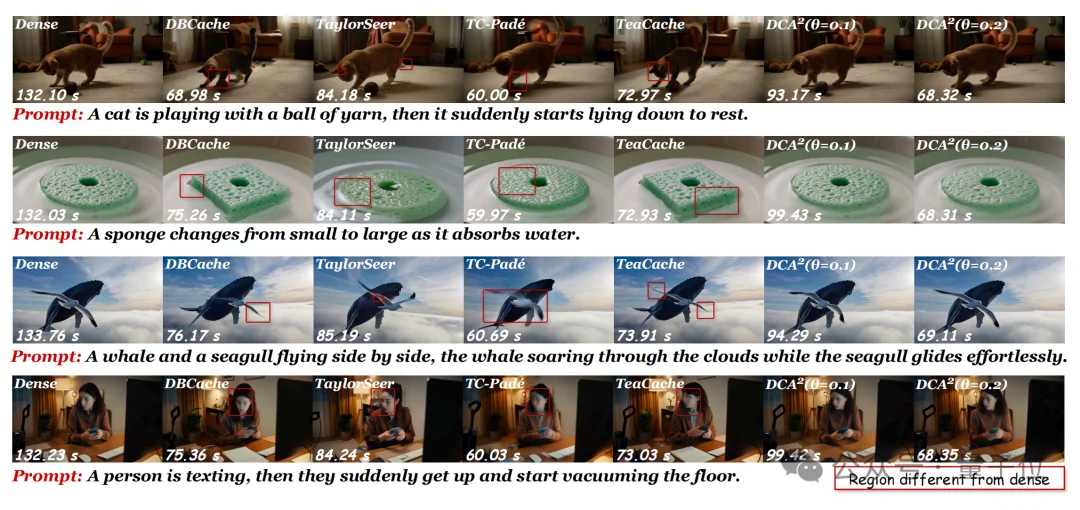
在发布方案展示的测试条件下,相比Dense基线方案,该技术实现端到端平均2.48倍的加速,同时保持生成质量。
这意味着,推理加速不再完全依赖减少生成步骤,而是通过更精细的计算复用策略,在效率与质量之间建立动态平衡。
视频生成的资源开销不仅来自计算量,也来自推理过程中的显存占用。
当多个视频任务并发执行时,缓存数据的存储、读取和更新都会影响显存使用效率。即使单个任务获得加速,如果缓存管理带来额外资源负担,仍可能限制整体任务处理能力。
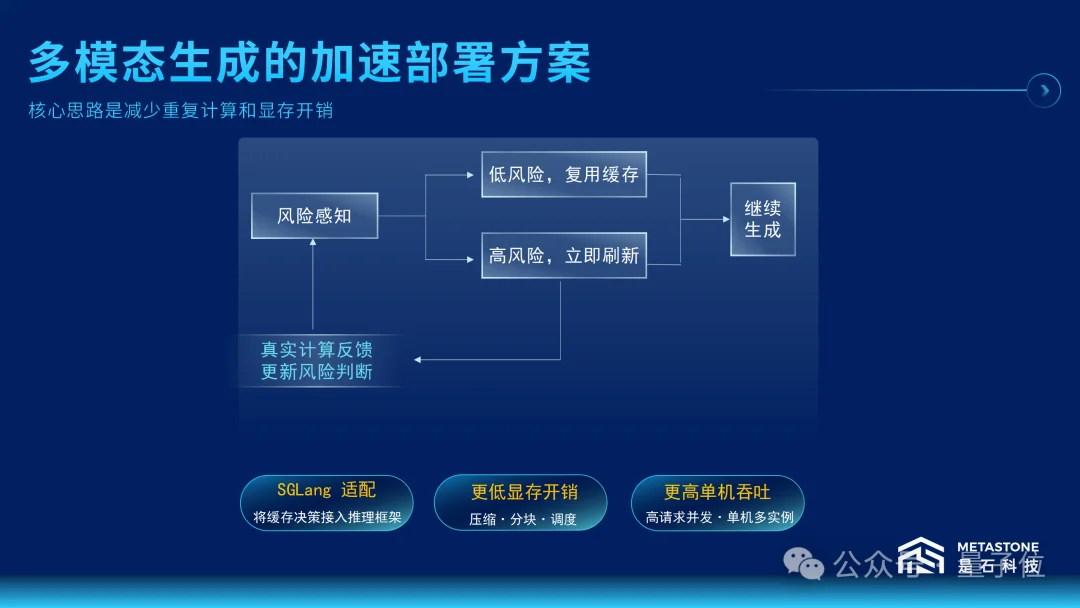
因此,单任务推理加速与多任务资源利用,需要协同优化。
是石科技将智能缓存决策与SGLang推理框架结合,通过缓存复用、分块处理、压缩及智能调度等机制,减少重复计算与不必要的显存开销。
同时,系统引入风险感知机制,根据实际计算反馈动态调整缓存策略,在提高复用效率的同时控制误差风险。这一设计将优化范围从单次推理计算扩展到资源管理层面。
对于企业级视频生产而言,生成速度、显存占用与任务并发能力共同决定算力资源的实际产出。通过降低冗余计算和缓存开销,可以为更高并发和更灵活的任务部署提供空间。
视频生成之外,多模态理解同样面临计算效率问题。
与文本相比,视频和音频包含更高密度的时序信息。模型在处理连续视频帧、声音片段等输入时,需要将这些内容转化为大量Token,进而增加计算与存储负担。但不同模态、不同片段的信息密度并不相同。部分Token包含关键语义信息,部分则存在较高冗余。
如果对所有Token采用相同处理方式,容易产生不必要的计算开销;如果直接进行统一压缩,又可能丢失影响理解结果的重要信息。
是石科技提出基于模态自适应的免训练Token压缩方法,利用基于AudioCLIP的模态感知技术,识别不同模态中的有效信息,并据此调整Token保留与压缩策略。
其核心思路是:根据模态特征与信息价值分配计算资源,而不是对所有输入进行等比例处理。
该方法无需额外训练,通过减少冗余Token,降低多模态理解阶段的计算负担,同时尽可能保留关键语义信息。
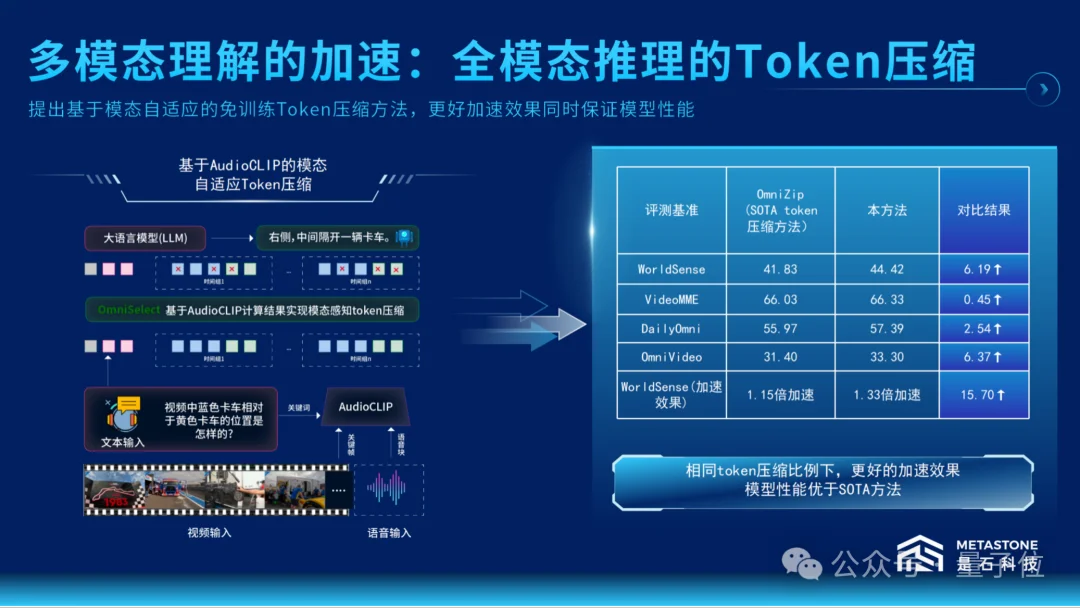
在WorldSense评测中,该方法实现1.33倍加速。在VideoMME、DailyOmni等多模态理解基准测试中,也展现出良好的性能表现。这使多模态推理优化从视频生成端进一步延伸至素材理解端,为处理复杂视听输入提供更高效的技术路径。
推理效率之外,多模态视频创作还需要解决理解结果如何进入生成流程的问题。
实际业务中的视频生成请求,往往同时包含人物图片、参考视频、音频及文字要求。
这些输入不仅具有不同的数据形式,还包含人物身份、动作、声音、镜头与时间顺序等约束。
如果直接将复杂素材与自然语言指令交给生成模型,素材之间的关联关系和执行要求可能难以得到一致表达。
为此,是石科技构建了基于全模态模型的Context Engine解决方案,在多模态理解与视频生成之间建立结构化的信息衔接机制。
系统首先理解输入素材及创作需求,提取人物、声音和相关约束,再将其组织为包含镜头、动作、对白等内容的结构化信息,供后续视频生成模型执行。例如,用户提供人物图片和参考音频,并要求生成一段人物对白视频时,系统需要将人物信息、声音内容与镜头安排进行关联,而不只是生成一段文字提示词。
这一解决方案通过素材绑定、结构化分镜、时轴校验及错误修正等机制,使不同模态的信息能够在生成流程中形成相对明确的对应关系。
其优化重点,是将复杂的多模态输入转化为更清晰、可校验、可执行的生成上下文。
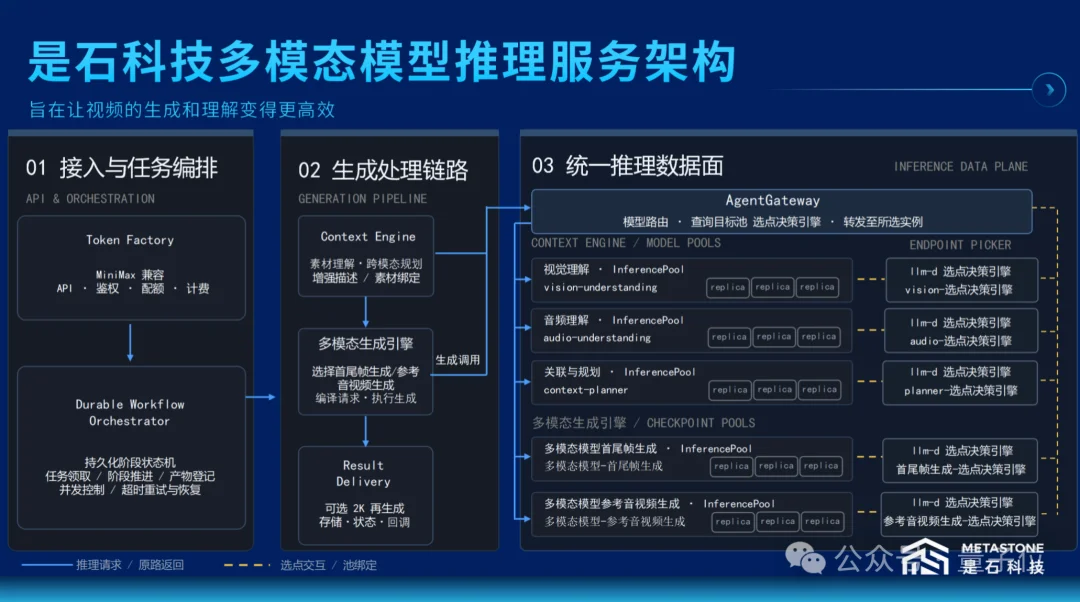
在服务层面,是石科技进一步构建覆盖API接入、任务编排、模型路由、推理执行与结果交付的多模态推理架构,并通过任务状态管理、并发控制、超时重试与恢复机制,支撑实际业务中的任务运行与交付。
多模态模型进入生产环境后,生成质量、推理时延、显存成本与任务稳定性不再是彼此独立的指标。
视频生成端需要控制冗余计算与误差累积,多模态理解端需要减少无效Token处理,生成链路则需要保证素材信息和创作约束能够有效传递。
此次是石科技发布的多模态模型服务,将这些优化能力放在同一条生产链路中考虑。
从自适应缓存加速、显存资源管理,到模态感知Token压缩、基于全模态模型的Context Engine解决方案的结构化衔接,再到推理服务架构,优化对象逐步从单个模型的计算过程延伸至多模态任务的执行与交付。
AI视频规模化应用的关键,不只是缩短一次生成的等待时间,而是在既定算力资源下,持续完成更多满足质量要求的生成任务。
从“能生成”到“好生产”,未来是石科技将持续围绕多模态推理效率、资源利用与服务稳定性等方面展开技术优化,为AI视频从模型能力走向实际生产提供基础支撑。
文章来自于"量子位",作者 "允中"。

【开源免费】LangGPT 是一个通过结构化和模板化的方法,编写高质量的AI提示词的开源项目。它可以让任何非专业的用户轻松创建高水平的提示词,进而高质量的帮助用户通过AI解决问题。
项目地址:https://github.com/langgptai/LangGPT/blob/main/README_zh.md
在线使用:https://kimi.moonshot.cn/kimiplus/conpg00t7lagbbsfqkq0
