
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
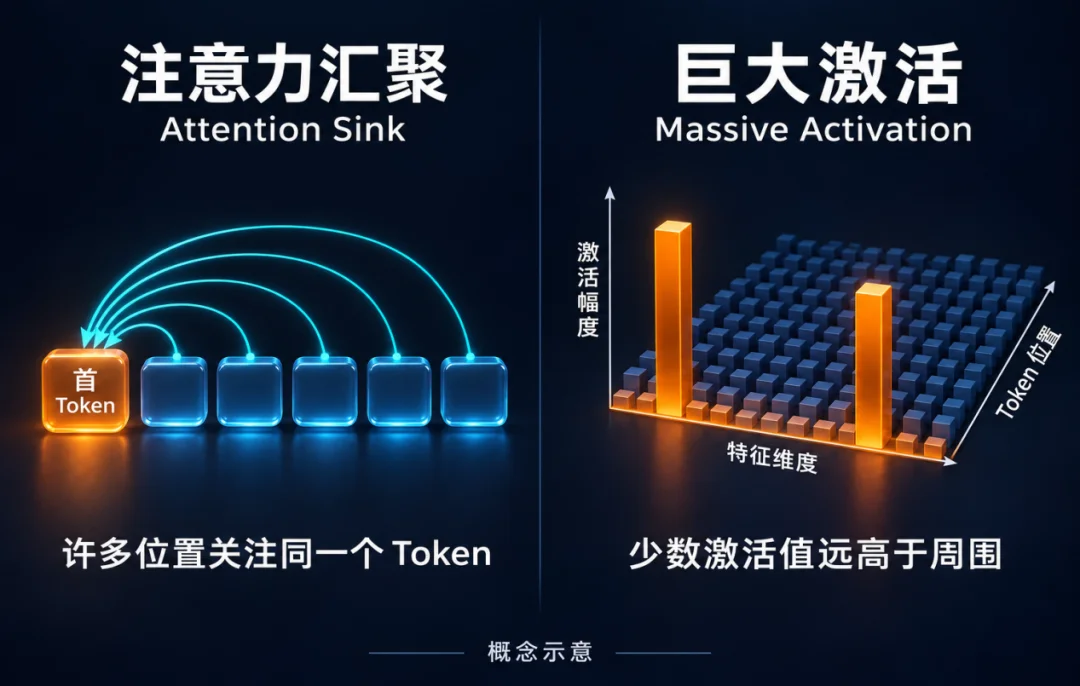
大语言模型中有一个反复出现的现象。序列开头的少数 Token,往往吸引大量注意力。即使它们没有多少实际语义,模型仍然会频繁地看向它们。这就是注意力汇聚(Attention Sinks)。
同一个位置还常出现另一件怪事。模型内部计算产生的部分数值会变得非常大,形成巨大激活(Massive Activations)。两种现象常常一起出现,但它们究竟是怎么联系起来的?
已有研究主要从前向计算出发观察模型如何处理输入、形成输出,而在一项被 NeurIPS 2026 接收的工作中,来自清华大学、北京大学的研究团队把目光转向了模型的另一半:反向传播。
他们发现,注意力汇聚也会把训练信号集中到少数 Token 上,形成「梯度汇聚」(Gradient Sinks)。而巨大激活可以通过 RMSNorm 衰减这些局部集中的梯度。
换句话说,看起来异常的大激活,可能承担着梯度调节的作用。
01 被归一化的激活
为什么会被训练得那么大?
要理解研究者的动机,需要先看看现代 Transformer 大模型里的归一化层。在采用 pre-norm 的模型中,一个 Token 的隐藏状态进入注意力或者前馈网络(MLP)子层之前,会先经过 RMSNorm 完成归一化。这意味着如果保持向量方向不变,只把它整体放大,归一化后交给子层的输入几乎不变。
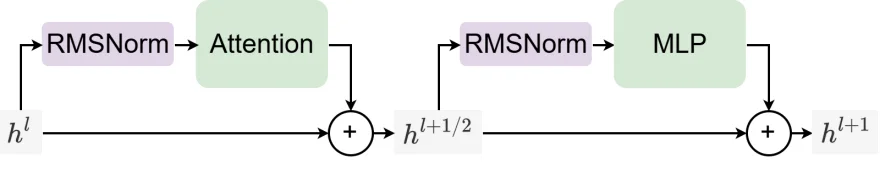
一个疑问也就随之而生:既然前向计算要先归一化,那巨大的激活范数为什么会被训练出来呢?
答案可能藏在归一化的反向传播里。前向计算中被消去的尺度,仍然会影响梯度的反向传递。
02 注意力既是前向的 Value 路由
也是反向的梯度路由
注意力机制的前向计算,是对不同位置的 Value 向量加权求和。反向传播时,同一组注意力权重,也决定了梯度如何分配回这些位置。如果许多后续 Token 都关注同一个位置,它们的梯度也会沿着这些连接传回来。
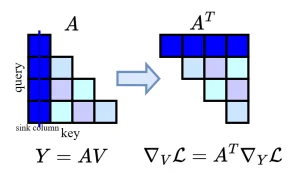
在因果注意力中,开头的 Token 能被大量后续位置访问。一旦它成为注意力汇聚点,就具备了承接大量反向训练信号的结构条件。当然具体汇聚强度,还取决于这些梯度的方向和相关性。
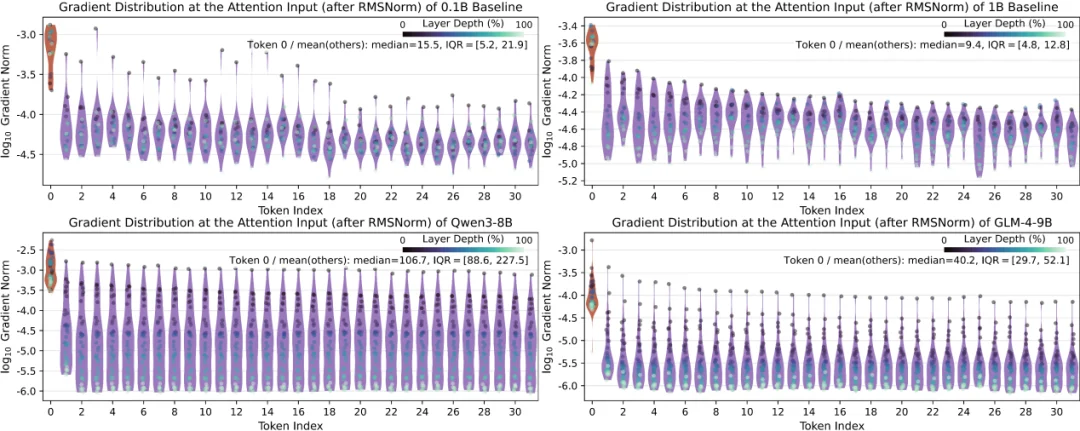
研究团队在从头训练的模型以及多款开源模型上进行了测量。结果显示,在 RMSNorm 之后的注意力输入处,梯度集中的现象普遍存在。首 Token 的梯度范数远大于其他 Token,通常高出其他早期位置平均值的一到两个数量级。这就是论文观察到的梯度局部集中,称为梯度汇聚(Gradient Sink)。注意力的汇聚点,也是梯度的汇聚点。
进一步往上游拆分 Query、Key、Value 三条路径后,差异更加明显。Key 和 Value 路径在首 Token 处出现突出峰值,其中 Value 路径最为显著;Query 路径则相对平缓。局部梯度集中呈现出明确的路径结构。
03 巨大激活
成为梯度的「减压阀」
梯度汇聚与巨大激活又有什么联系呢?这就需要进一步观察梯度尺度在整个注意力子层中的变化。实验发现,虽然首 Token 的梯度经过注意力子层之后被急剧放大,但是其残差流梯度的尺度却相对稳定,这是因为经过注意力层汇聚的梯度被 RMSNorm 压缩了。
研究团队从理论上分析了 RMSNorm 的梯度传递性质。核心结果指出,在其他条件相同时,输入激活的尺度越大,RMSNorm 对反向梯度的收缩能力越大。更准确地说,RMSNorm 的雅可比矩阵算子范数上界与输入的均方根尺度成反比。这让激活尺度成为一种局部梯度调节手段。
于是,论文提出了这样一条机制链:注意力向少数位置集中,带来 Value 路径上的梯度汇聚,而较大的残差流激活则通过 RMSNorm 衰减传回残差流的分支梯度。在这一视角下,巨大激活可以被理解为模型训练过程中形成的一种自适应调节结构。
04 怎么验证?
给梯度一种额外的调节方式
如果上述解释成立,就会产生一个可以检验的预测:如果模型获得另一条衰减局部梯度的路径,那么即使注意力汇聚仍然存在,模型对巨大激活的依赖也应当减弱。
为此,研究团队提出了 V-scale,即在 Value 投影之后、注意力聚合之前,根据 Value 向量的大小进行缩放,对小范数 Value 对应的回传梯度施加更强的衰减。
选择 Value 路径有两个直接原因:这里承载了最显著的梯度峰值,而且注意力汇聚位置的 Value 范数往往较小。这种变换为局部集中的梯度提供了另一条衰减路径。
实验结果符合预测。在 0.3B 模型中,梯度汇聚比值的中位数从约 40.3 降至 5.6。与此同时,首 Token 的残差流激活范数显著下降,即巨大激活被显著缓解而模型仍保留明显的注意力汇聚行为。并且巨大激活缓解主要源于 MLP 输出范数的下降。
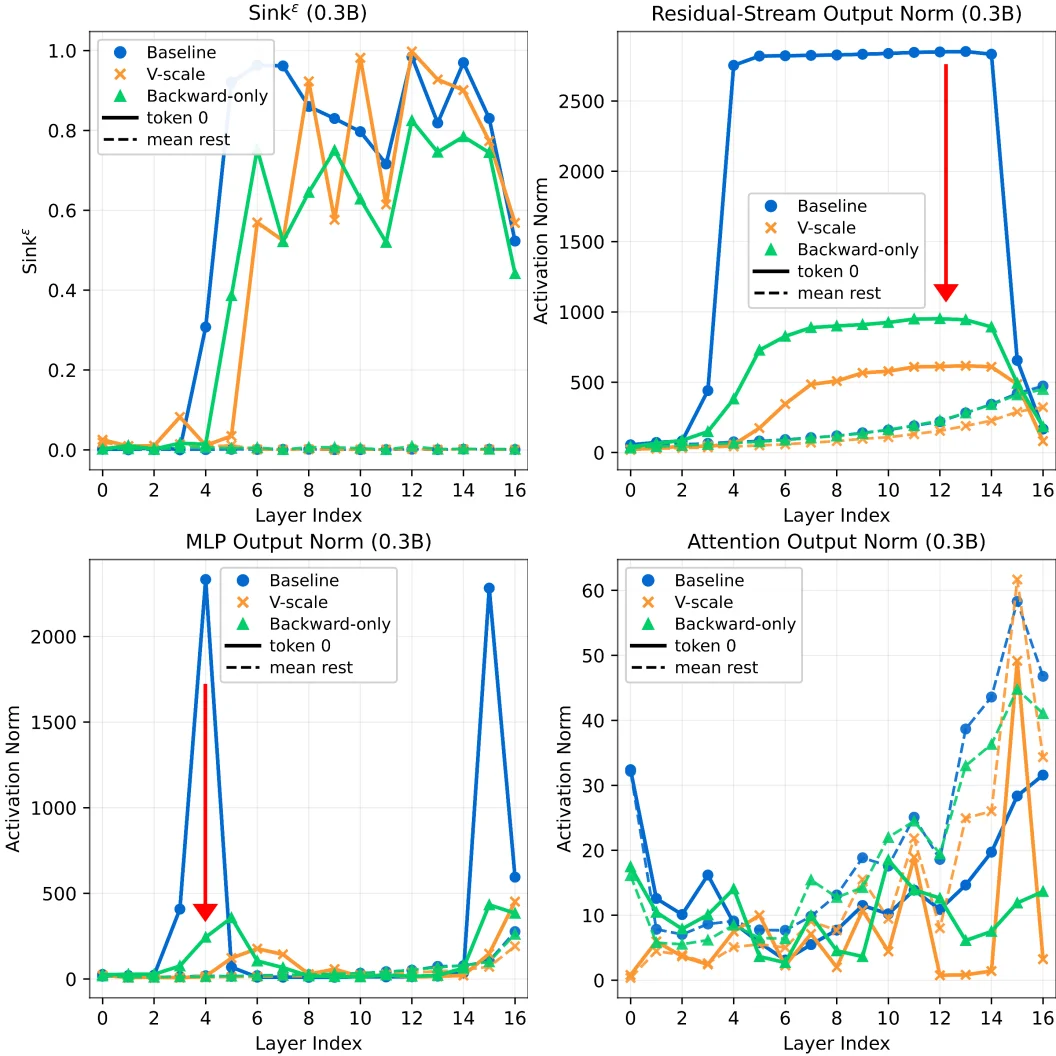
不过完整的 V-scale 仍然改变了前向传播的 Value。为了排除前向缩放的影响,研究团队进一步设计了仅改变反向规则的对照。
结果是,仅反向干预的模型也出现了同样的现象分离,首 Token 的残差流和 MLP 输出范数减小,注意力汇聚仍然明显。因此,实验为「巨大激活参与调节局部梯度压力」提供了实验支持。
05 理解模型的异常
也要看训练信号如何流动
这项工作的价值,在于把两个经常被讨论的现象——注意力汇聚和巨大激活——连了起来,并发现了它们在反向传播中的关联,即梯度汇聚。
注意力权重既决定前向的信息聚合,也决定反向的梯度路由。归一化层既改变前向表示的尺度,也影响反向信号的传递。把两者放在一起,才能更完整地理解某些极端激活为何会在训练中形成。
研究由此提供了一个新的思路:当我们发现模型的某些「异常」现象时,或许可以进一步追问它们在模型训练过程中发挥着什么作用。
作者信息
文章来自于微信公众号 “机器之心”,作者 “机器之心”

【开源免费】Browser-use 是一个用户AI代理直接可以控制浏览器的工具。它能够让AI 自动执行浏览器中的各种任务,如比较价格、添加购物车、回复各种社交媒体等。
项目地址:https://github.com/browser-use/browser-use
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
【开源免费】graphrag是微软推出的RAG项目,与传统的通过 RAG 方法使用向量相似性作为搜索技术不同,GraphRAG是使用知识图谱在推理复杂信息时大幅提高问答性能。
项目地址:https://github.com/microsoft/graphrag
【开源免费】Dify是最早一批实现RAG,Agent,模型管理等一站式AI开发的工具平台,并且项目方一直持续维护。其中在任务编排方面相对领先对手,可以帮助研发实现像字节扣子那样的功能。
项目地址:https://github.com/langgenius/dify
【开源免费】RAGFlow是和Dify类似的开源项目,该项目在大文件解析方面做的更出色,拓展编排方面相对弱一些。
项目地址:https://github.com/infiniflow/ragflow/tree/main
【开源免费】phidata是一个可以实现将数据转化成向量存储,并通过AI实现RAG功能的项目
项目地址:https://github.com/phidatahq/phidata
【开源免费】TaskingAI 是一个提供RAG,Agent,大模型管理等AI项目开发的工具平台,比LangChain更强大的中间件AI平台工具。
项目地址:https://github.com/TaskingAI/TaskingAI
