
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
前不久,微信视觉团队开源了WeMM-Embedding。
这是一个多模态 Embedding 模型系列,可以处理文本、图片、视频和视觉文档,其中 2B 版本也能在一张 8GB 显卡上跑起来。
对视觉文档检索来说,它有一个很实用的能力:同一个 Embedding 模型既可以输入 OCR 文本,也可以直接输入原始图片。
以前比较这两条路线,经常还要换模型:一边用文本 Embedding,一边用视觉 Embedding。最后效果有差异,很难说清有多少来自输入方式,有多少来自模型本身。WeMM 至少把这个变量收窄了——同一个 checkpoint,可以直接比较:
图片 → OCR → 文本 → Embedding
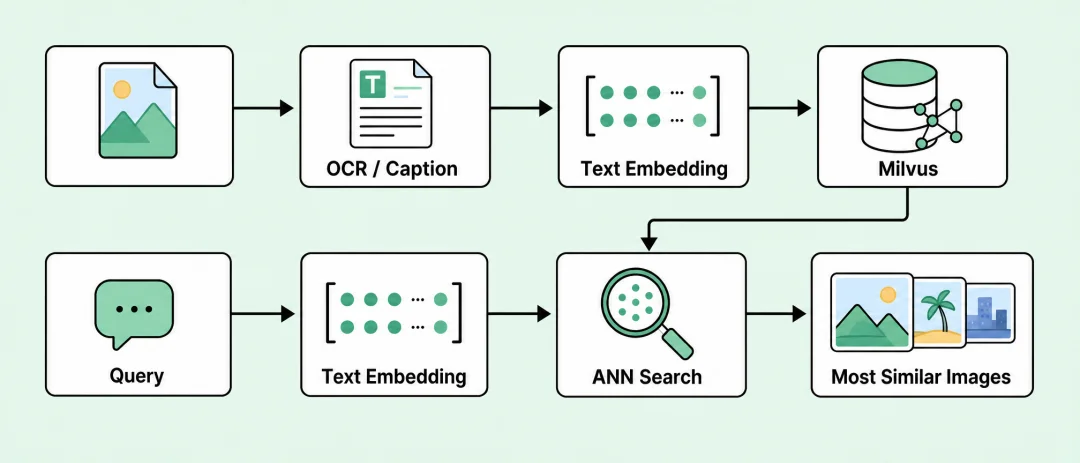
和:
图片 → Embedding
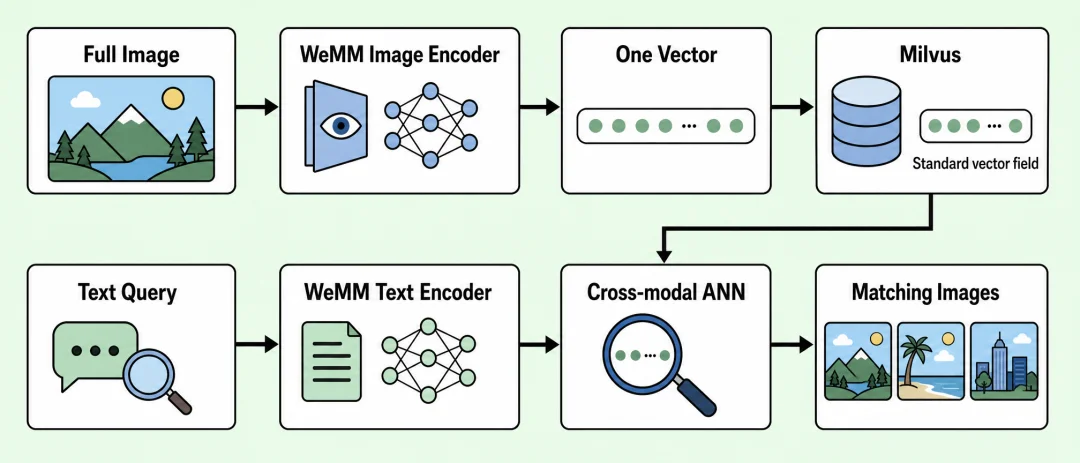
但只到这一步还不够,我想继续往下测两个问题。
第一,对信息图这种文字和视觉结构都很密的文档,直接编码原图,相比 OCR 文本能提升多少检索效果?
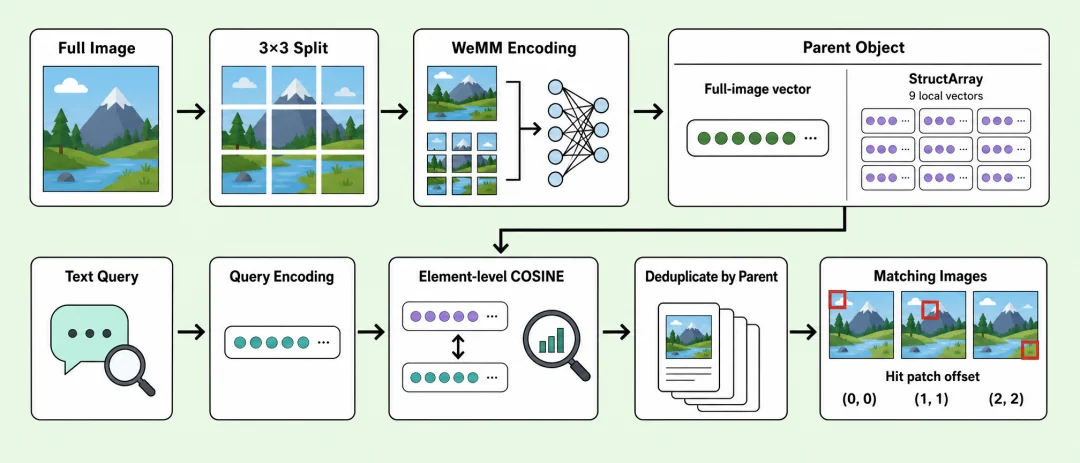
第二,如果整张信息图只生成一个向量还不够,把它切成多个局部区域、每个区域单独生成向量,能不能继续提高检索效果?我又引入了最新的 Milvus Struct Array,把图切成3×3共九块,每块编码一个向量,连同整图一起存进向量数据库。
以下为完整的实验过程。
数据上,使用的是vidore/infovqa_test_subsampled。
InfoVQA 来自 InfographicVQA,是一套针对信息图的问答数据。信息图里通常同时存在标题、正文、数字、图表、图例和复杂版式,很适合测试 OCR 文本和原图表示之间的差异。
我从中取了 50 张信息图和对应的 50 条 query。每条 query 都有一张目标图片,检索时从这 50 张图里找它。
三个方案都使用 WeMM-Embedding-2B(能够被大部分普通显卡带起来,方便复现;同时也能覆盖这次需要测试的 text input 和 image input),向量维度固定为 2,048,Milvus 中使用余弦相似度。
S1:OCR 文本
使用数据集提供的 OCR 内容,把一张信息图里的文字展开成文本,再送入 WeMM。
每张图一个文本向量。
Infographic
→ OCR text
→ WeMM
→ 1 vector
S2:整张原图
跳过 OCR,直接把原图送入 WeMM。
每张图一个视觉向量。
Infographic
→ WeMM
→ 1 vector
整图设置:
max_pixels = 786432
S3:整图 + 九个局部区域
保留整图向量,同时把图片固定切成 3×3 九块,每块再生成一个向量。
Infographic
├── global embedding
├── region 1 embedding
├── region 2 embedding
├── ...
└── region 9 embedding
每个局部:
max_pixels = 262144
九个局部向量存在 Milvus 的StructArray里。(StructArray 是 Milvus 用来保存 parent-child 数据的一种结构:一条父记录下面可以挂多个结构相同的子元素,每个子元素可以有自己的 bbox、类型、标量字段和向量。)
一张图的数据大致是:
infographic
├── global_embedding
└── regions
├── region_id + bbox + embedding
├── region_id + bbox + embedding
├── ...
└── region_id + bbox + embedding
这样可以搜索 region,最后仍然返回完整图片。
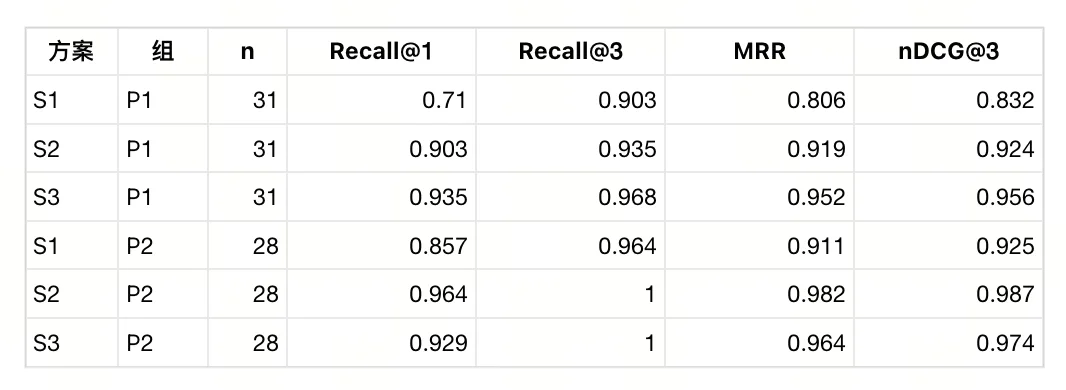
这次主要看四个指标:
全量 50 条结果
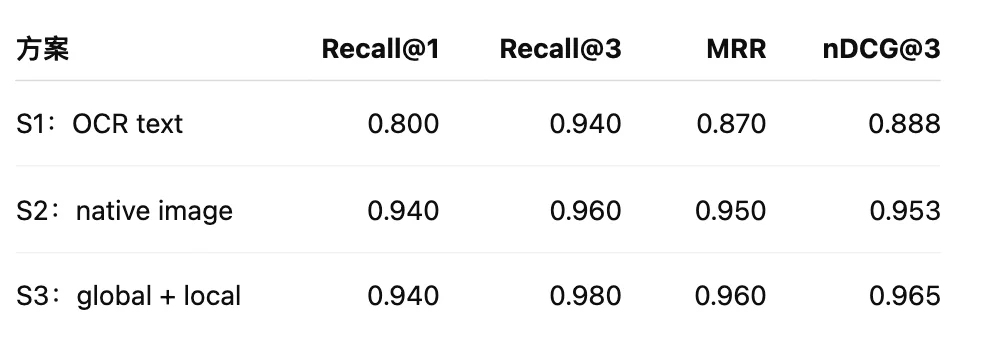
S1 有 40 条 query 把正确图片排在第一。
S2 是 47 条。
S3 也是 47 条。
我还根据问题词和 OCR geometry 自动划了 P1、P2 两个探索性子集。这两组没有逐条人工核验,只用来观察不同 query 上的变化。结果如下
成本记录如下:
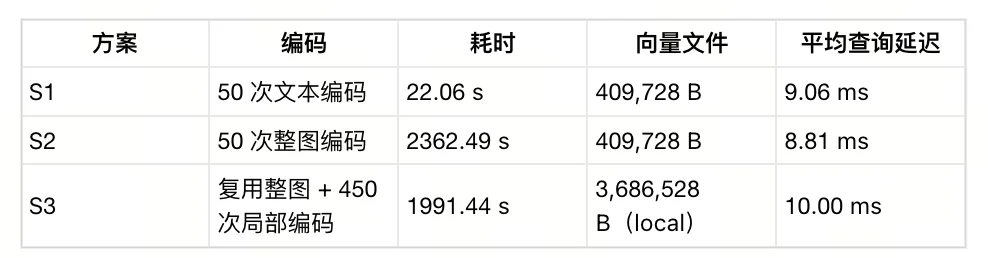
一个 2,048 维 float32 向量的理论大小是 2048 × 4 = 8192 bytes。
S1 和 S2 都是 50 个向量。S3 在 50 个 global vectors 之外增加了 450 个 local vectors,向量数量是单向量方案的 10 倍。
表里的文件大小只是 raw vector payload。写进 Milvus 以后,索引结构、metadata 和 segment 还会继续占空间。
查询延迟在三组里都是 9~10 ms,但 collection 只有 50 张图片,这个规模不足以测试生产环境里的 ANN latency、内存和吞吐。编码耗时也只对应这次 8GB GPU 和当前推理配置。
S1 到 S2 的变化最直接:Recall@1 从 0.80 提高到 0.94,50 条 query 里多找对了 7 条。
S1 先把页面经过 OCR 和 reading order 转成线性文本,再生成 Embedding。OCR 错误、文本顺序、长度限制都会影响最终表示;颜色、图形、布局以及元素之间的位置关系,如果没有被显式写进文本,也不会进入向量。
S2 直接输入原图,这些视觉信息可以一起参与编码。因此在这批信息图上,原图方案的 Top-1 从 40/50 提高到了 47/50。
S2 到 S3 的结果要分开看。给每张图增加九个局部向量后,全量 Recall@1 仍然是 0.94,P2 还从 27/28 降到了 26/28。
这里更可能需要检查的是当前 S3 的局部打分方式。
这次局部检索使用 MaxSim:九个 region 分别和 query 比较,再取最高分。region 越多,每张图获得高局部分数的机会也越多。如果当前排序中过度依赖这个最高 local score,一个错误图片只要有一块和 query 偶然很像,就可能超过整图语义更匹配的正确图片。
这和 StructArray 本身没有直接关系。StructArray 可以搜索整个父对象下面的一组子向量,也可以搜索单个 region;Milvus 还支持把顶层的 global vector 和 StructArray 里的 local vector 做 hybrid search,再在父图层面重新排序。
所以 S3 后面更值得调的是 global/local 的打分比例。例如同时保留整图得分和局部得分:
score = α × global_score + β × local_score
再比较不同的 α、β,或者只在 global retrieval 不确定时引入 local signal。这样能避免一个局部最高分直接主导整张图片的排名。
固定 3×3 也会影响结果。信息图里的 chart、legend、table 和 text block 不一定落在九宫格边界内;同时,crop 还提高了局部内容的有效分辨率。因此下一轮最好把切分方式、分辨率和 score fusion 分开测试。
28 条 region-level query 中,13 条最高分 region 落在自动构造的目标区域,命中率是 0.464,随机参考值是 0.111。局部向量已经捕捉到一定的区域信号,现在需要解决的是怎样把这些信号加入整图排序,而不让偶然的局部高分干扰结果。
这轮 50-query 实验确定了一件事:信息图检索加入原图 Embedding是一个很有必要的环节。
同一个 WeMM-Embedding-2B 下,OCR 文本的 Recall@1 是 0.80,原图是 0.94。实际系统里可以继续保留 OCR 做精确文字、数字、filter 和 citation,同时用原图向量做视觉语义召回。
多向量方案目前没有提高 Recall@1,但局部命中结果说明 region embedding 有可用信号。下一轮我们会重点测试 global/local score fusion,并把固定九宫格换成更符合页面结构的 region,再单独控制 crop 带来的变化。
作者介绍
Zilliz黄金写手:尹珉
文章来自于"Zilliz",作者 "尹珉"。


【开源免费】graphrag是微软推出的RAG项目,与传统的通过 RAG 方法使用向量相似性作为搜索技术不同,GraphRAG是使用知识图谱在推理复杂信息时大幅提高问答性能。
项目地址:https://github.com/microsoft/graphrag
【开源免费】Dify是最早一批实现RAG,Agent,模型管理等一站式AI开发的工具平台,并且项目方一直持续维护。其中在任务编排方面相对领先对手,可以帮助研发实现像字节扣子那样的功能。
项目地址:https://github.com/langgenius/dify
【开源免费】RAGFlow是和Dify类似的开源项目,该项目在大文件解析方面做的更出色,拓展编排方面相对弱一些。
项目地址:https://github.com/infiniflow/ragflow/tree/main
【开源免费】phidata是一个可以实现将数据转化成向量存储,并通过AI实现RAG功能的项目
项目地址:https://github.com/phidatahq/phidata
【开源免费】TaskingAI 是一个提供RAG,Agent,大模型管理等AI项目开发的工具平台,比LangChain更强大的中间件AI平台工具。
项目地址:https://github.com/TaskingAI/TaskingAI
