打入AI底层!NUS尤洋团队用扩散模型构建神经网络参数,LeCun点赞
打入AI底层!NUS尤洋团队用扩散模型构建神经网络参数,LeCun点赞扩散模型,迎来了一项重大新应用——像Sora生成视频一样,给神经网络生成参数,直接打入了AI的底层!
来自主题: AI技术研报
9288 点击 2024-02-25 16:00

 搜索
扩散模型,迎来了一项重大新应用——像Sora生成视频一样,给神经网络生成参数,直接打入了AI的底层!
好消息,好消息,真·Sora视频上新了!走过路过不要错过!
最近几年,基于 Transformer 的架构在多种任务上都表现卓越,吸引了世界的瞩目。使用这类架构搭配大量数据,得到的大型语言模型(LLM)等模型可以很好地泛化用于真实世界用例。

继 2023 年 1 月 YOLOv8 正式发布一年多以后,YOLOv9 终于来了!
在过去的 2023 年中,大型语言模型(LLM)在潜力和复杂性方面都获得了飞速的发展。展望 2024 年的开源和研究进展,似乎我们即将进入一个可喜的新阶段:在不增大模型规模的前提下让模型变得更好,甚至让模型变得更小。
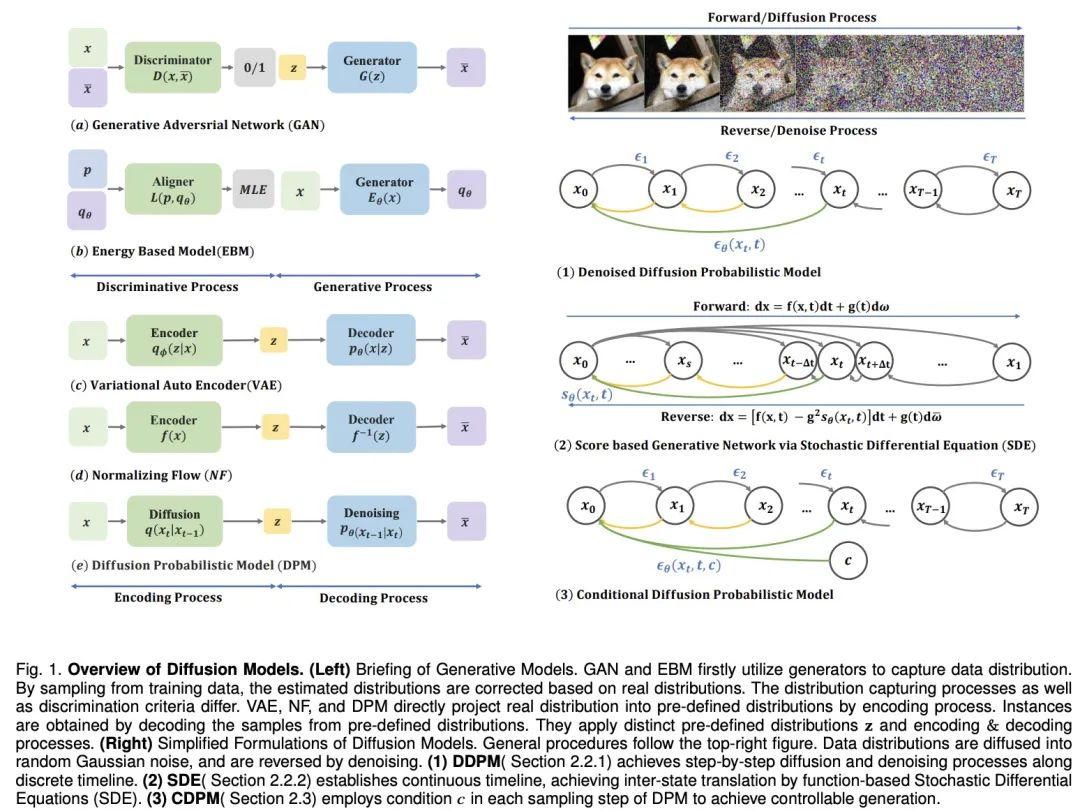
为了使机器具有人类的想象力,深度生成模型取得了重大进展。这些模型能创造逼真的样本,尤其是扩散模型,在多个领域表现出色。扩散模型解决了其他模型的限制,如 VAEs 的后验分布对齐问题、GANs 的不稳定性、EBMs 的计算量大和 NFs 的网络约束问题。
大语言模型之大,成本之高,让模型的稀疏化变得至关重要。
在微调大型模型的过程中,一个常用的策略是“知识蒸馏”,这意味着借助高性能模型,如GPT-4,来优化性能较低的开源模型。这种方法背后隐含的哲学理念与logos中心论相似,把GPT-4等模型视为更接近唯一的逻辑或真理的存在。
过去几天,OpenAI 非常热闹,先有 AI 大牛 Andrej Karpathy 官宣离职,后有视频生成模型 Sora 撼动 AI 圈。
视觉语言模型虽然强大,但缺乏空间推理能力,最近 Google 的新论文说它的 SpatialVLM 可以做,看看他们是怎么做的。