多模态大模型训练的显存与吞吐困局,被小红书开源的BigMac打破了
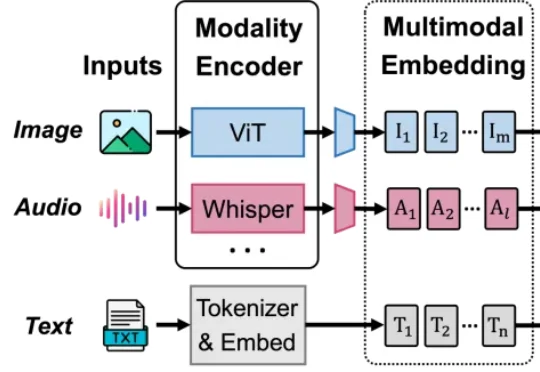
多模态大模型训练的显存与吞吐困局,被小红书开源的BigMac打破了BigMac 是原生多模场景下的流水并行训练新范式。它针对多模态大模型训练中计算效率与显存占用难以兼顾的问题,提出了依赖安全的嵌套流水线:以成熟的 LLM 流水线为主干,在不打乱 LLM 执行顺序的前提下,有序嵌入编码器和生成器计算,从而在不增加 LLM 流水线空泡、保持激活显存有界的同时,高效实现多模态流水训练。
搜索
BigMac 是原生多模场景下的流水并行训练新范式。它针对多模态大模型训练中计算效率与显存占用难以兼顾的问题,提出了依赖安全的嵌套流水线:以成熟的 LLM 流水线为主干,在不打乱 LLM 执行顺序的前提下,有序嵌入编码器和生成器计算,从而在不增加 LLM 流水线空泡、保持激活显存有界的同时,高效实现多模态流水训练。
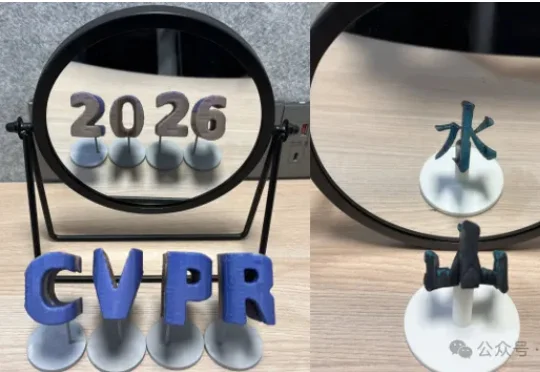
近日,来自清华大学等单位的研究团队提出了AutoMIA,一种自动生成镜像错觉艺术的 AI 设计方法,用户仅需任意指定两张图片,分别对应镜子前和镜子中的图案,AutoMIA就可以自动完成3维艺术品的设计,并且支持直接3D打印出来制作艺术品。
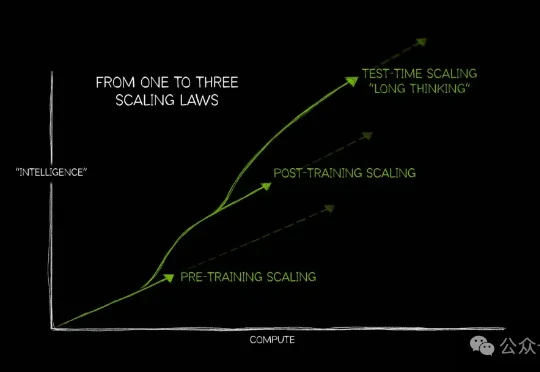
新智元报道 大模型变强,过去靠两条路。 做大——Scaling Law出现后,参数从百亿推向千亿,算力支出一路飙升。 想久——o1带火思考模型,用更长的思维链、更多推理时间换结果。 问题是,除了Sca
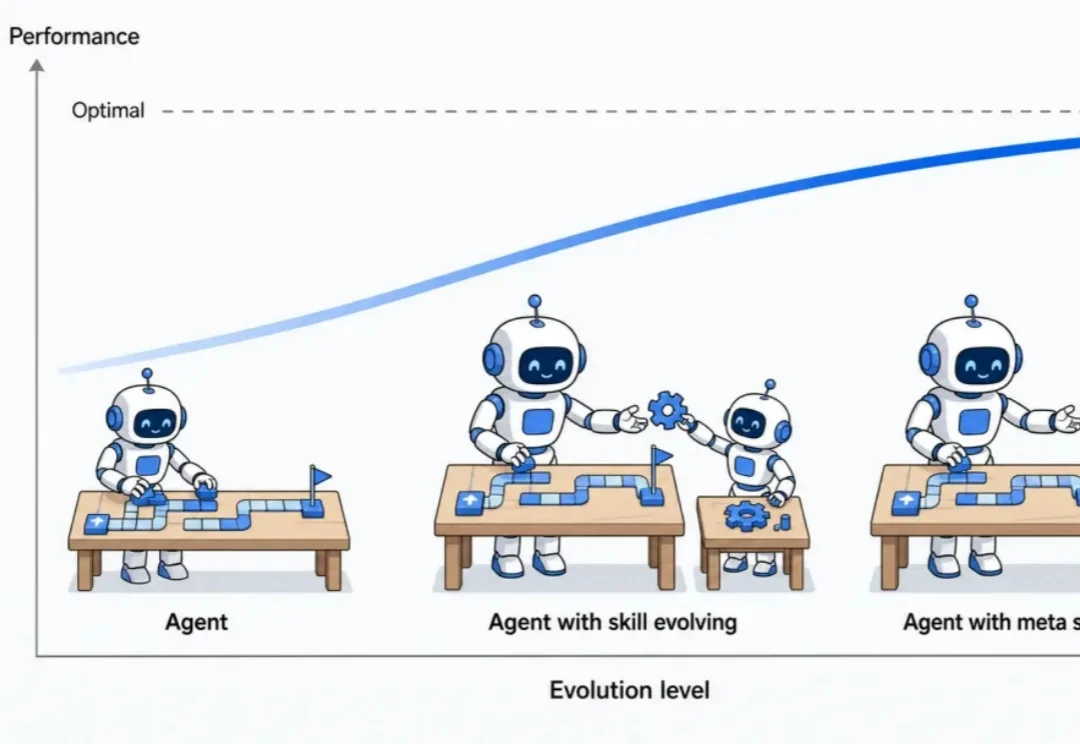
当大模型 Agent 被部署到工具调用、长程任务和开放环境中,一个关键问题会随之出现:能否在不更新模型参数的情况下,将执行经验沉淀下来,并在下一次做得更好?
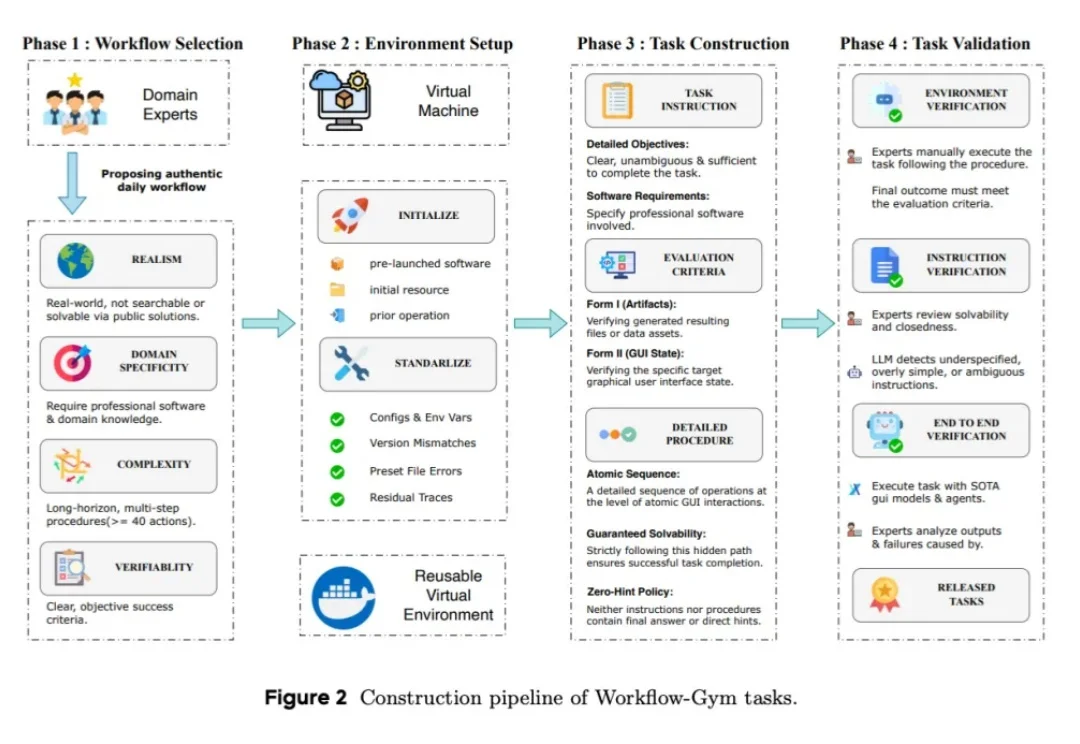
你可能已经在各种 benchmark 榜单上看过 GUI Agent 的 "大胜" 了。
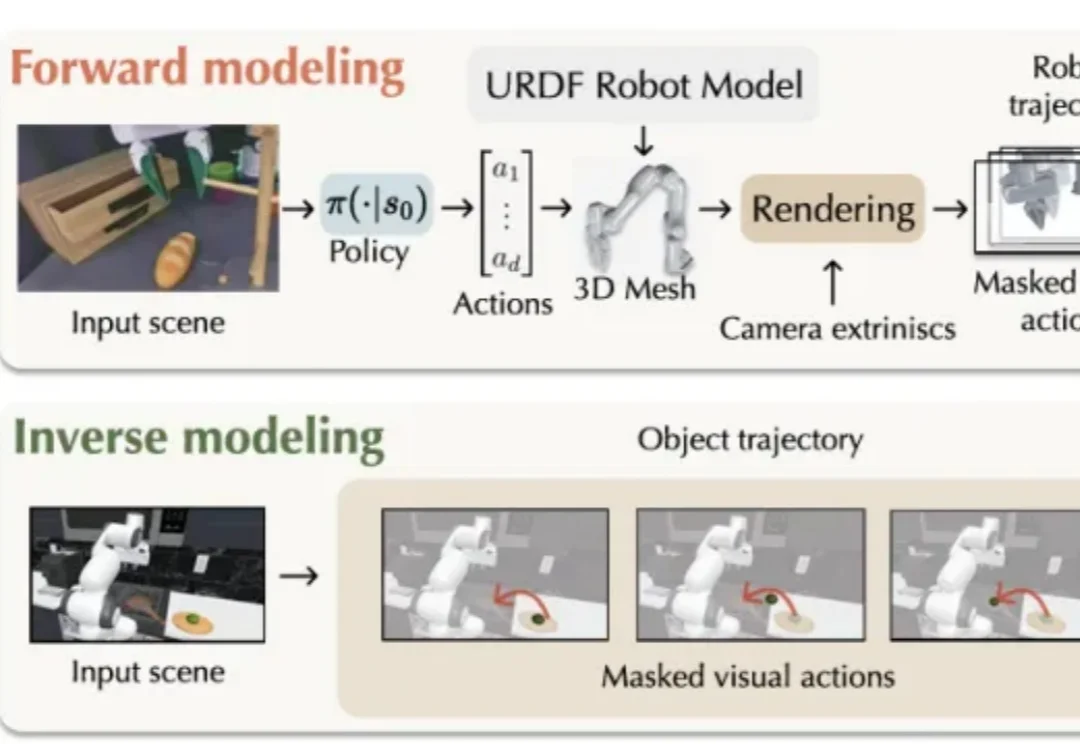
如果要让机械臂把咖啡机旁的杯子移到桌上,需要经历哪几个步骤?
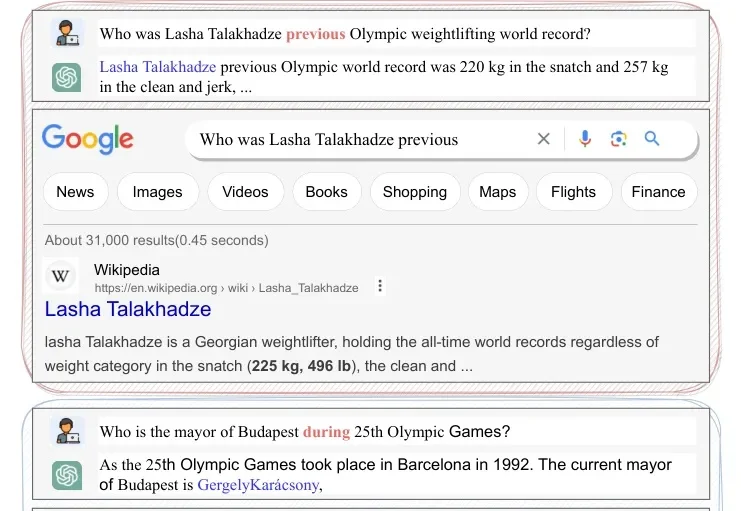
向ChatGPT问一个看起来挺简单的问题:“Lasha Talakhadze之前的奥运举重纪录是多少?”
逛过WAIC具身智能展区的人,多半有同一个疑问: 都2026年了,机器人干活,怎么还是慢吞吞的?
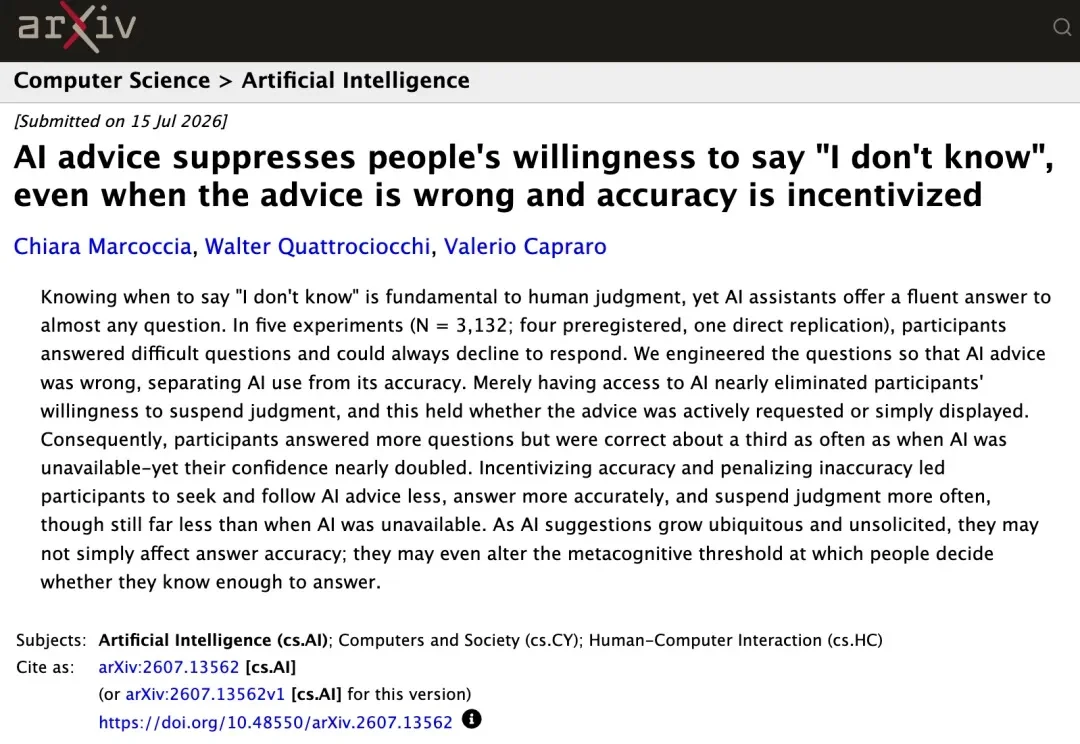
最新研究发现,AI幻觉不只会骗你了,还能喂大你的自信心、削弱你的判断力。
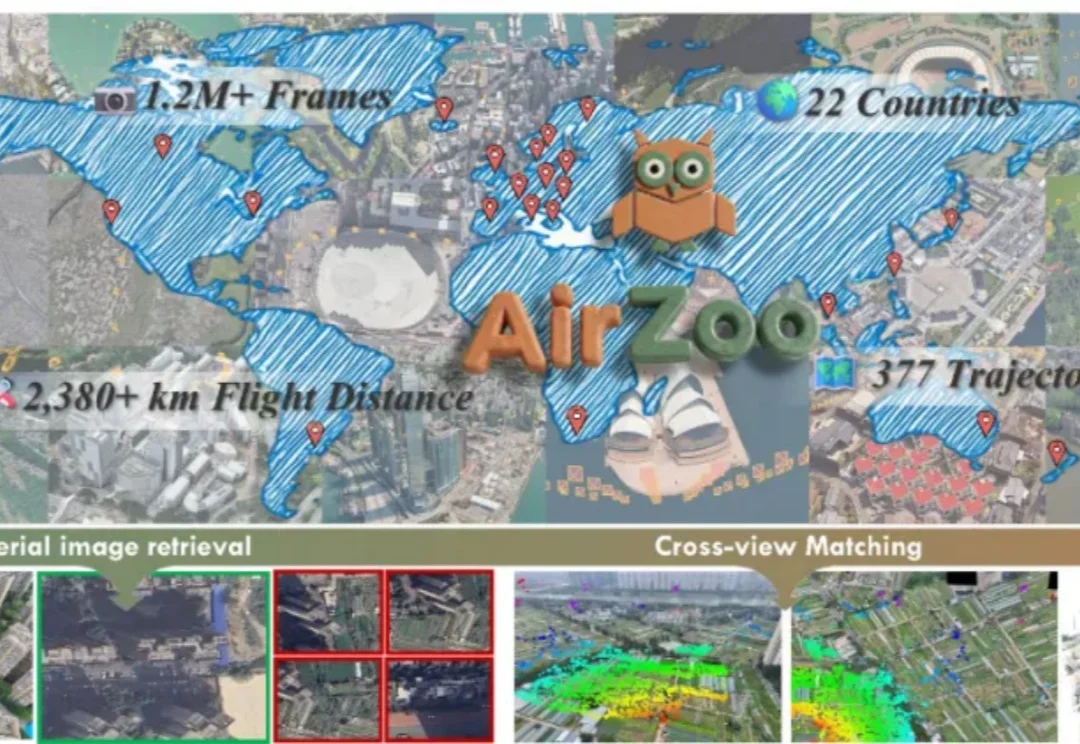
国防科技大学虚拟现实与视觉计算团队(SAW Lab)联合先进制导与控制技术国家级重点实验室等推出面向航拍几何 3D 视觉的统一大规模数据集与评测基准 「AirZoo」。