深度|吴恩达:中国在开源权重模型的发布方面已经远远领先于美国;很多人用Agentic AI的方式是错的
深度|吴恩达:中国在开源权重模型的发布方面已经远远领先于美国;很多人用Agentic AI的方式是错的如果一项任务主要涉及文本处理,并且你拥有完善的数据渠道,能够获取完成该任务所需的全部文本信息,那么人工智能完成这项任务的难度就会较低。
来自主题: AI资讯
12622 点击 2025-12-29 15:04

 搜索
如果一项任务主要涉及文本处理,并且你拥有完善的数据渠道,能够获取完成该任务所需的全部文本信息,那么人工智能完成这项任务的难度就会较低。
清华大学等多所高校联合发布SR-LLM,这是一种融合大语言模型与深度强化学习的符号回归框架。它通过检索增强和语义推理,从数据中生成简洁、可解释的数学模型,显著优于现有方法。在跟车行为建模等任务中,SR-LLM不仅复现经典模型,还发现更优新模型,为机器自主科学发现开辟新路径。
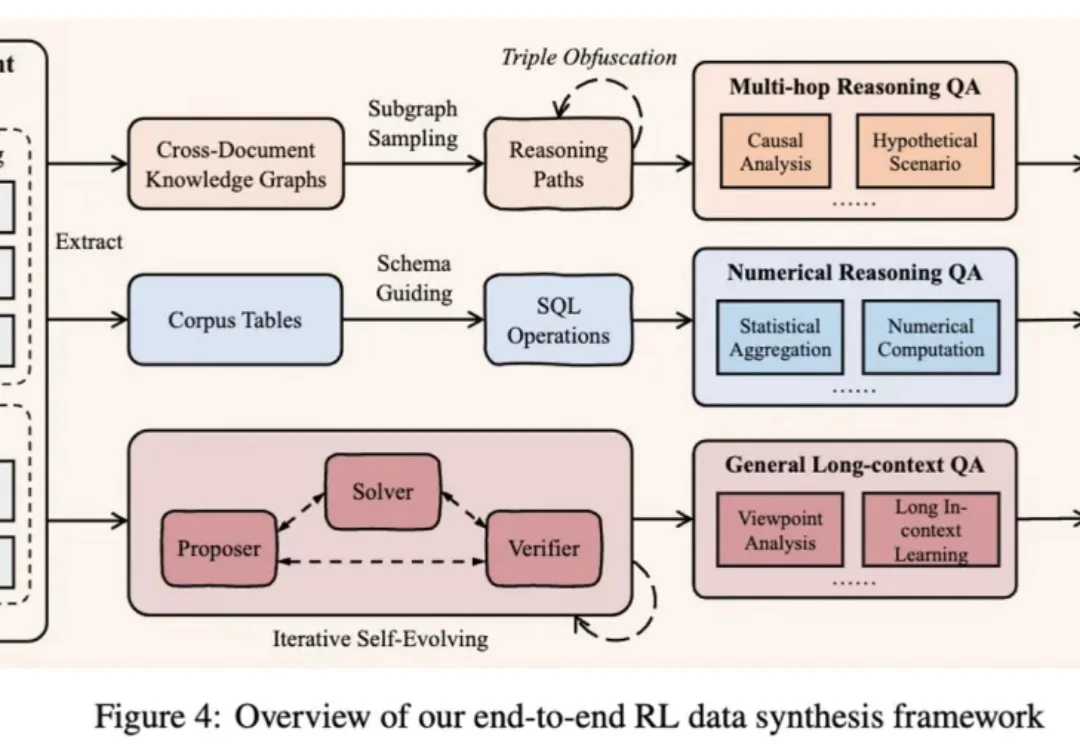
作为大模型从业者或研究员的你,是否也曾为一个模型的 “长文本能力” 而兴奋,却在实际应用中发现它并没有想象中那么智能?
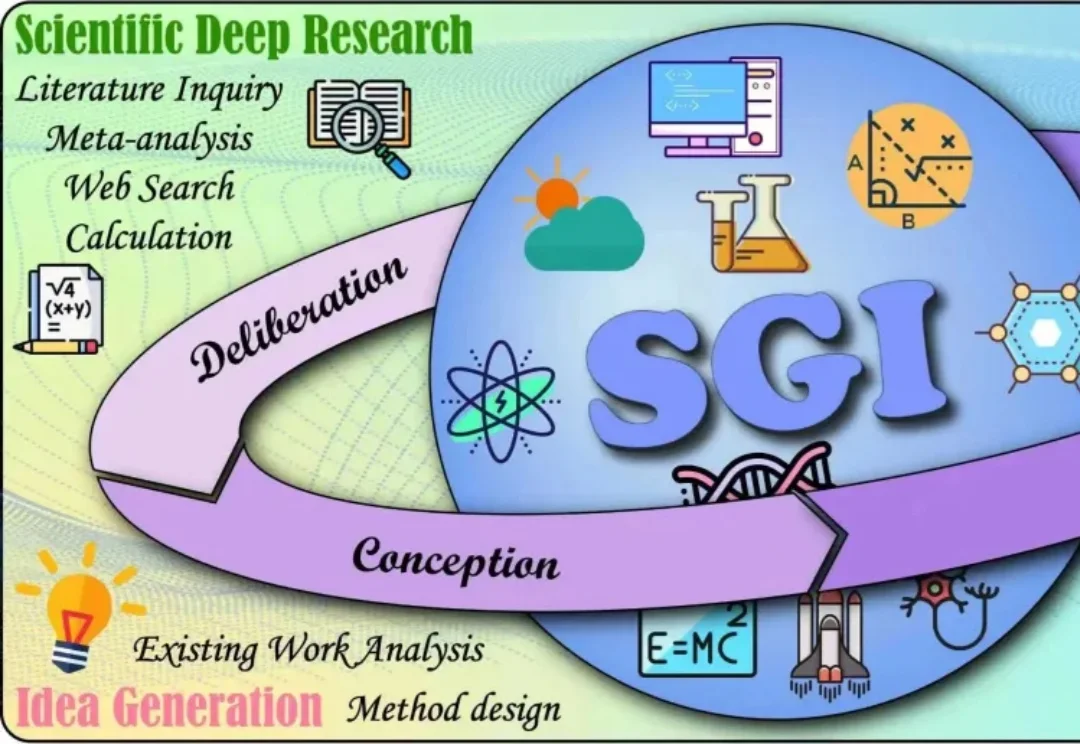
如今,大模型在理解、推理、编程等方面表现突出,但AI的“科学通用能力”(SGI)尚无统一标准。
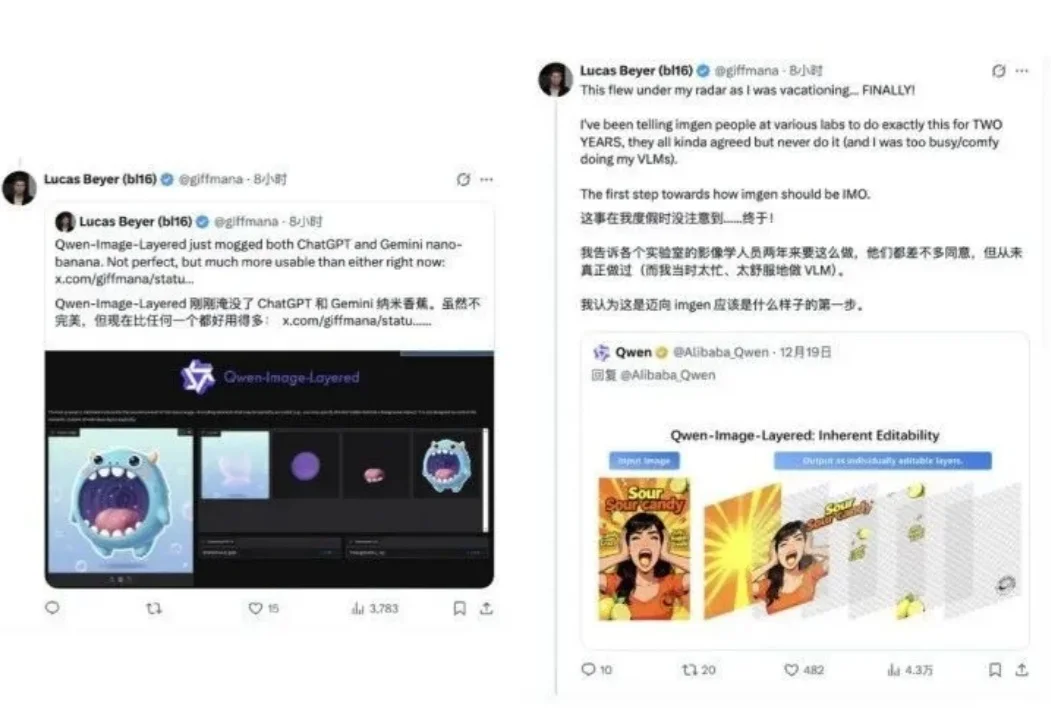
太香了太香了,妥妥完爆ChatGPT和Nano Banana!
网易云的年度听歌报告出来了,你的 2025 听歌关键词是什么。
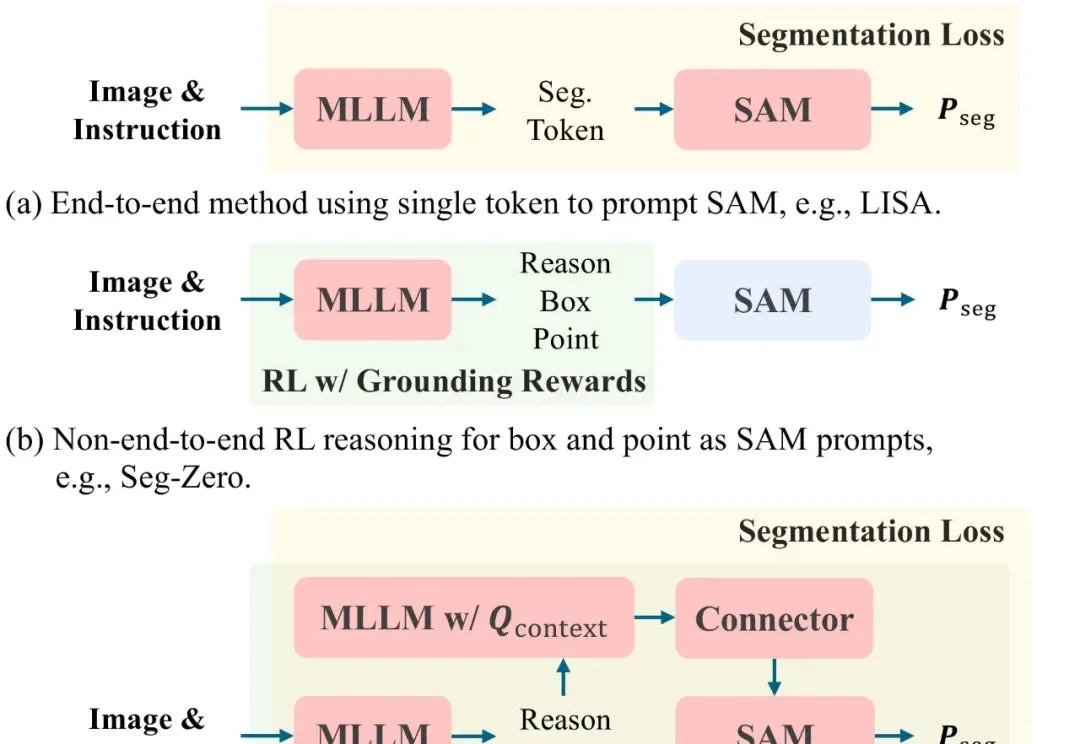
文本提示图像分割(Text-prompted image segmentation)是实现精细化视觉理解的关键技术,在人机交互、具身智能及机器人等前沿领域具有重大的战略意义。这项技术使机器能够根据自然语言指令,在复杂的视觉场景中定位并分割出任意目标。
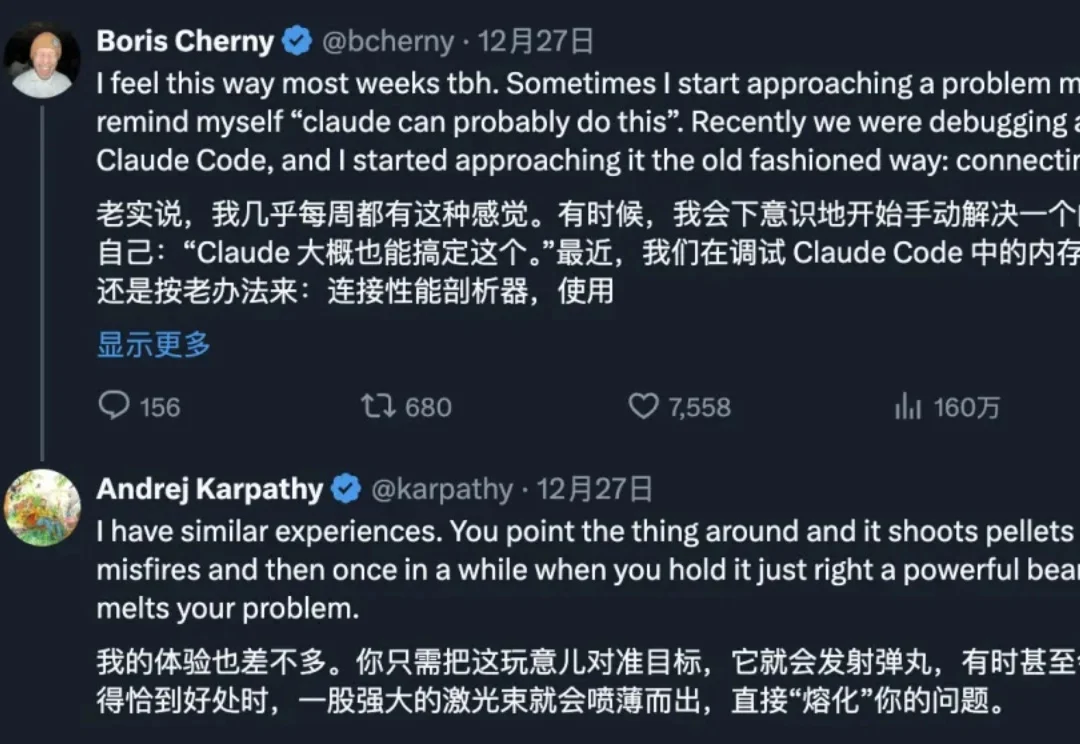
两个月以来,我一直想写一篇给小白的 CC 入门指南,今天终于可以写了。
我们经常在一些对比 AI 性能的测试中,看到宣称基础模型在自然语言理解、推理或编程任务等性能超人类的相关报道。
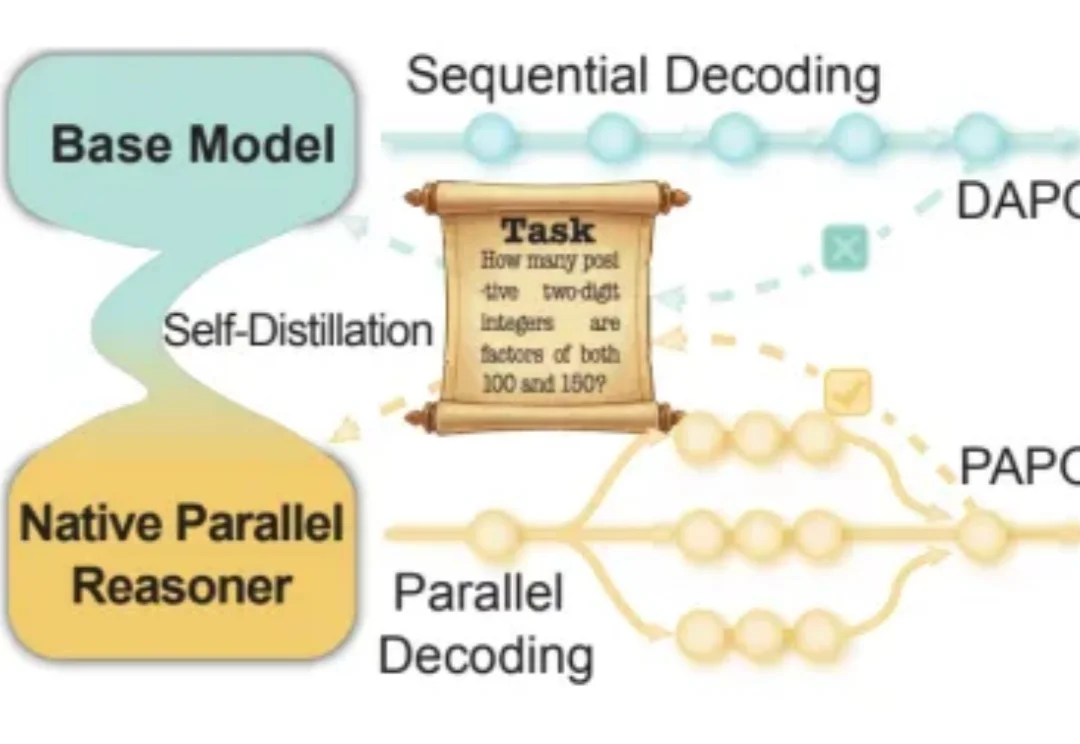
近年来,大语言模型在「写得长、写得顺」这件事上进步飞快。但当任务升级到真正复杂的推理场景 —— 需要兵分多路探索、需要自我反思与相互印证、需要在多条线索之间做汇总与取舍时,传统的链式思维(Chain-of-Thought)往往就开始「吃力」:容易被早期判断带偏、发散不足、自我纠错弱,而且顺序生成的效率天然受限。