AI资讯新闻榜单内容搜索-模型

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: 模型
GlobalGPT 李焕之:零融资、套壳产品千万美金ARR后,我找到了创业的mission

GlobalGPT 李焕之:零融资、套壳产品千万美金ARR后,我找到了创业的mission

GlobalGPT 李焕之:零融资、套壳产品千万美金ARR后,我找到了创业的mission

GlobalGPT 是一款很典型的 AI 套壳产品,一份订阅访问市面上几乎所有主流 AI 模型,目前全球累计用户超过 300 万,ARR 做到 1000 万美金。创始人李焕之,律师出身,2022 年开始连续创业,经历了 LegalDAO(Web3 法律社区)、LegalNow(AI 法律产品)的两次pivot后,在 2024 年初团队现金流只剩 1 个月时做出了 GlobalGPT。

来自主题: AI资讯
9669 点击    2026-06-17 16:22
18.42万亿Token!中国AI大模型周调用量连续七周领跑:MiniMax M3升至第二

18.42万亿Token!中国AI大模型周调用量连续七周领跑:MiniMax M3升至第二

18.42万亿Token!中国AI大模型周调用量连续七周领跑:MiniMax M3升至第二

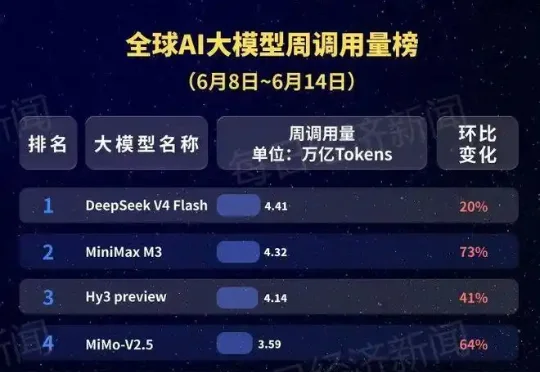
根据OpenRouter最新数据测算,上周(6月8日至14日)全球AI大模型总调用量为44.6万亿Token,较此前一周增长23.5%,连续八周上涨,大模型调用需求仍在持续释放。

来自主题: AI资讯
10254 点击    2026-06-17 15:26
李飞飞刚立规矩才13天,国产卡上「真物理」就来了!

李飞飞刚立规矩才13天,国产卡上「真物理」就来了!

李飞飞刚立规矩才13天,国产卡上「真物理」就来了!

被算力荒逼出来的硬核奇迹!腾讯米哈游老兵组成的「草根」团队,硬在国产芯片上炼出了超10分钟的绝对物理一致性。画面可以糙,物理绝不能假,这就是通往AGI的真正基石。

来自主题: AI技术研报
8624 点击    2026-06-17 15:05
达摩院发布世界模型评测基准,自家模型一个都没上榜......

达摩院发布世界模型评测基准,自家模型一个都没上榜......

达摩院发布世界模型评测基准,自家模型一个都没上榜......

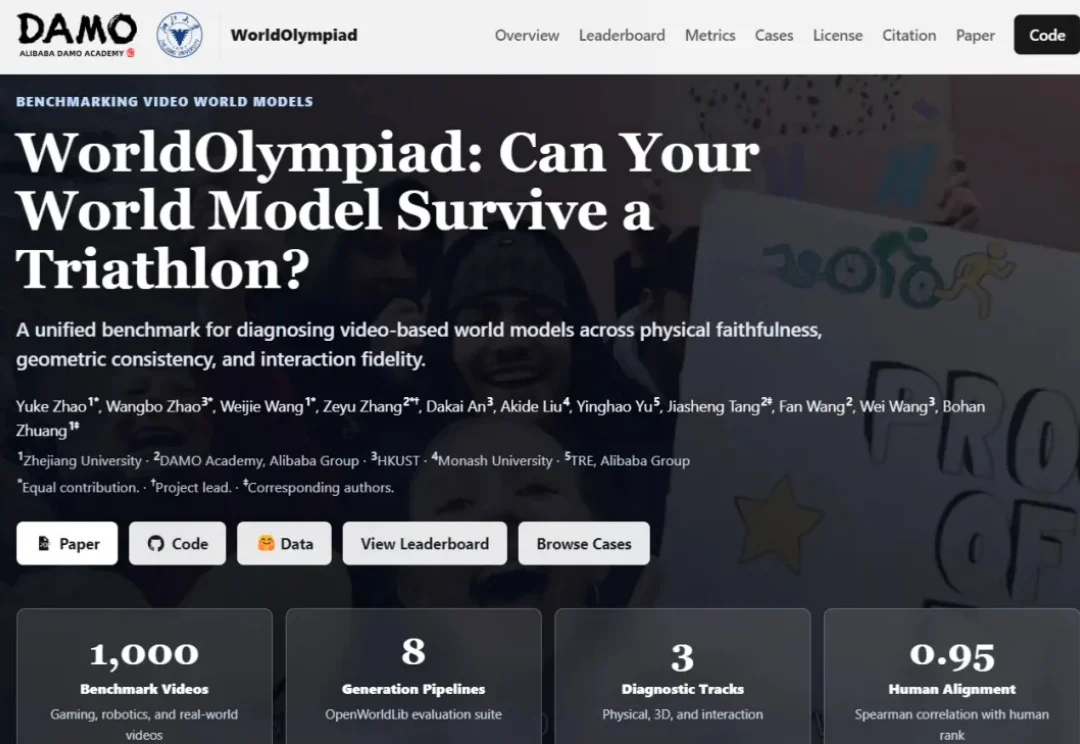
达摩院联合高校推出WorldOlympiad评测基准,跳出传统视频“唯画质”的评价逻辑,以物理真实性、三维几何一致性、长时序交互保真度三大维度,搭配游戏、机器人、通用实景三大场景,打造一套全方位的视频世界模型评测体系。

来自主题: AI技术研报
10169 点击    2026-06-17 14:28
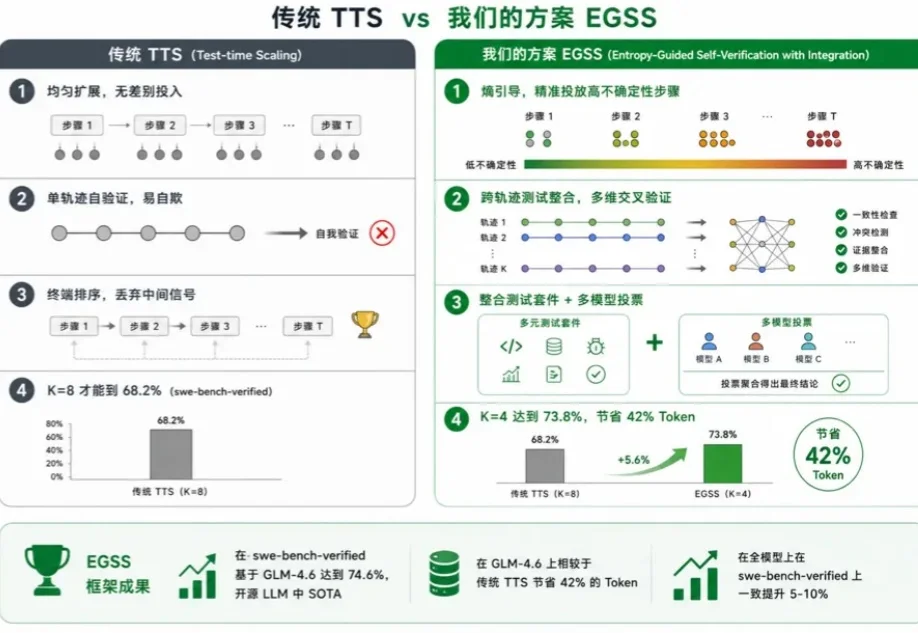
蚂蚁EGSS算法破解Test Time Scaling困局 | ACL 2026

蚂蚁EGSS算法破解Test Time Scaling困局 | ACL 2026

蚂蚁EGSS算法破解Test Time Scaling困局 | ACL 2026

更聪明的计算远比更多的计算更有效。

来自主题: AI技术研报
7438 点击    2026-06-17 14:06
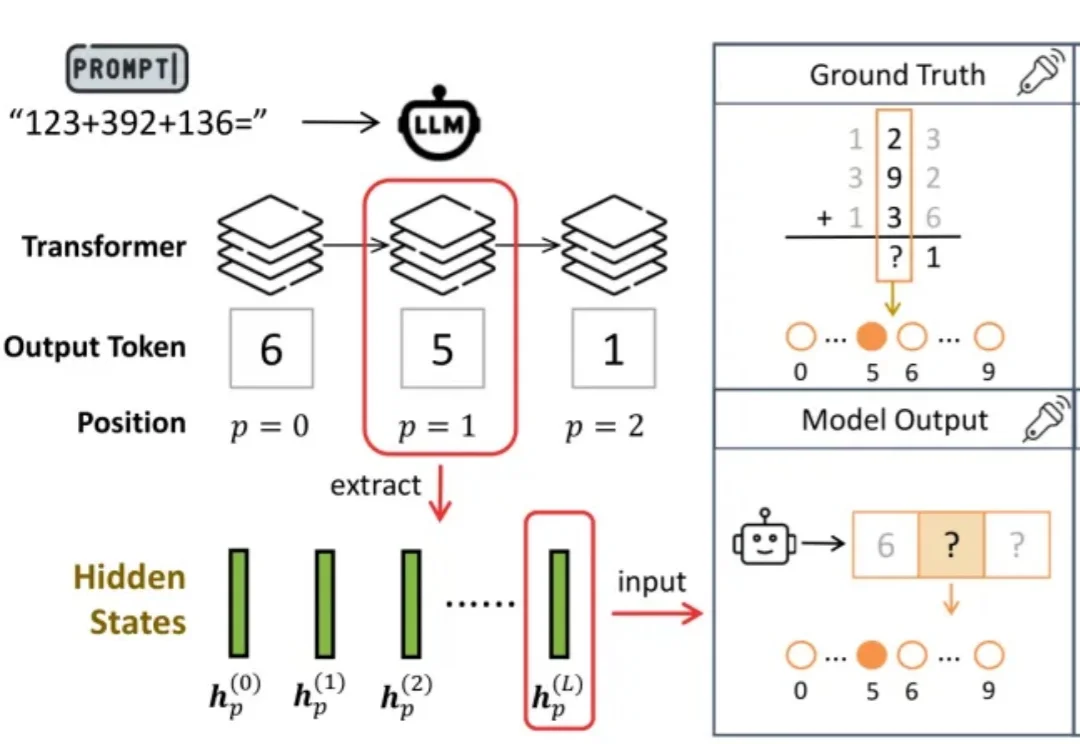
ICML 2026 | 大模型为什么算不对加法?南大团队提出等本位和轨迹,揭示LLM算术错误的几何机制

ICML 2026 | 大模型为什么算不对加法?南大团队提出等本位和轨迹,揭示LLM算术错误的几何机制

ICML 2026 | 大模型为什么算不对加法?南大团队提出等本位和轨迹,揭示LLM算术错误的几何机制

尽管大语言模型(Large Language Models, LLMs)在复杂数学推理、代码生成和知识问答上表现突出,但它们仍常在多位数加法这类基础算术任务上犯错。

来自主题: AI技术研报
8184 点击    2026-06-17 14:05
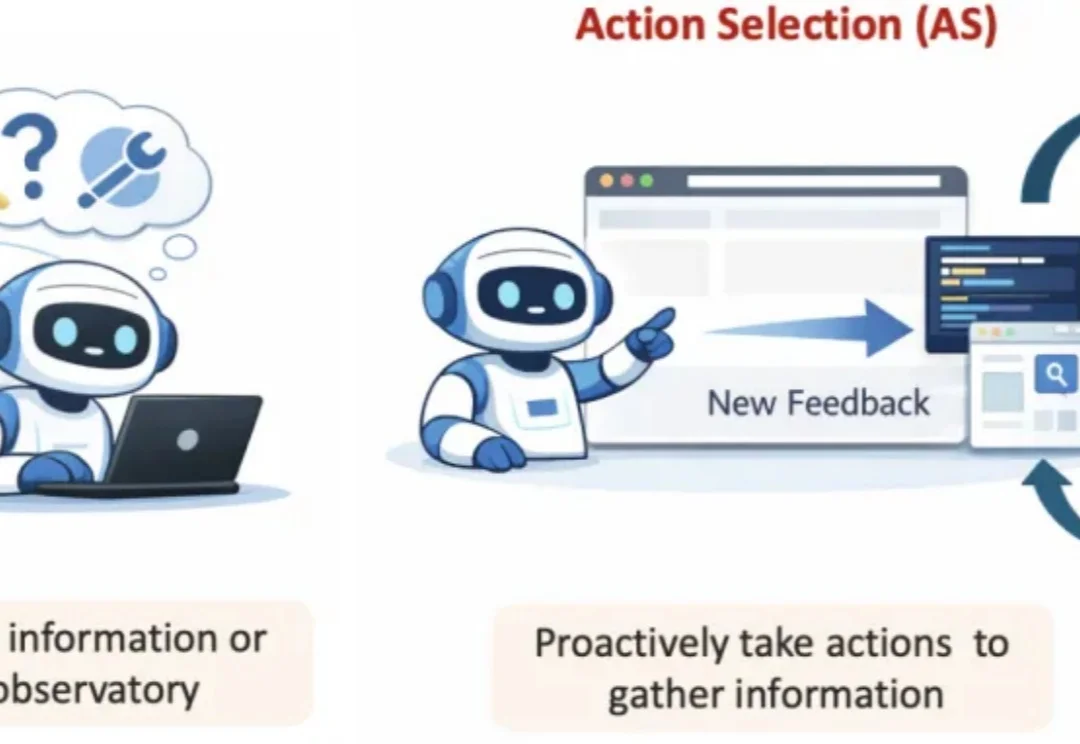
ICML 2026 | Agentic强化学习训练的信息自锁问题

ICML 2026 | Agentic强化学习训练的信息自锁问题

ICML 2026 | Agentic强化学习训练的信息自锁问题

随着大语言模型逐步从「单轮问答」走向「真实环境中的持续交互」,LLM agents 正在被用于越来越复杂的 agentic applications:deep research、coding、computer use、customer service、medical inquiry、troubleshooting 等等。

来自主题: AI技术研报
6985 点击    2026-06-17 14:05
葬AI基准测试发布:GLM 5.2第一,超越Opus 4.8

葬AI基准测试发布:GLM 5.2第一,超越Opus 4.8

葬AI基准测试发布:GLM 5.2第一,超越Opus 4.8

这是葬AI起号以来工作量最大的一篇文章。为了严肃评测国产模型的能力,我自研了一个Benchmark,完整测试了智谱、Qwen、Kimi、Minimax、Deepseek这些最新国产模型,还引入了境外势力Claude作对照组。

来自主题: AI资讯
10124 点击    2026-06-17 13:30