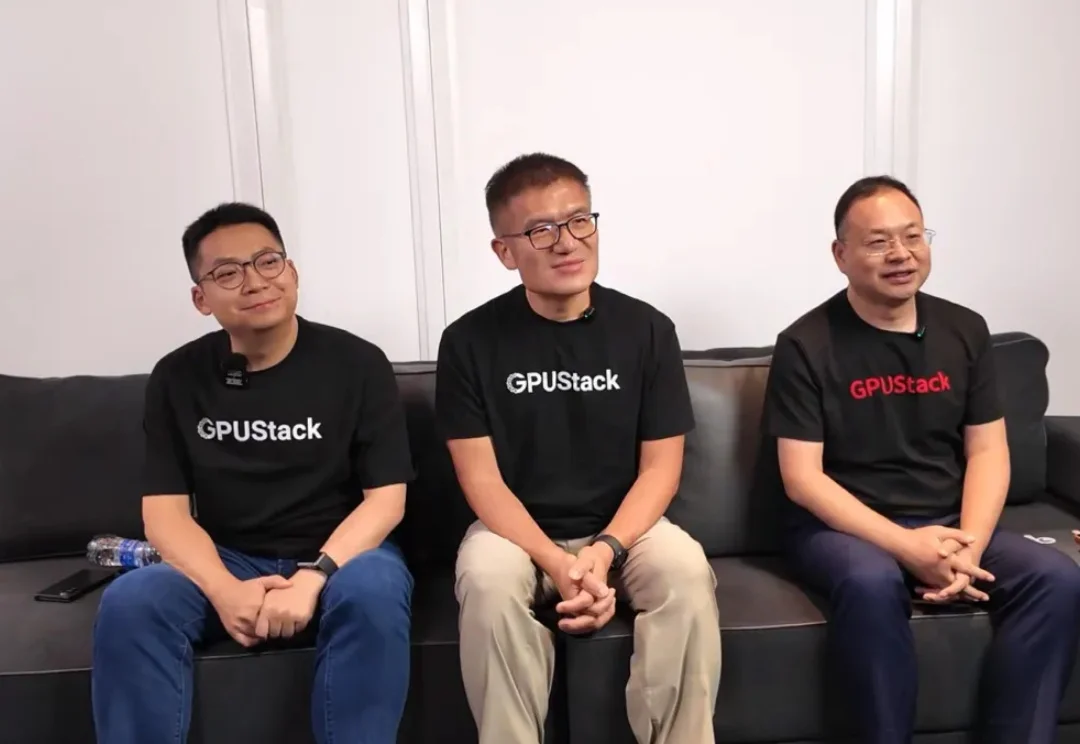
AI 不需要 K8s?专访 GPUStack:一场会议后,他们放弃了数百万营收,转向 AI Infra
AI 不需要 K8s?专访 GPUStack:一场会议后,他们放弃了数百万营收,转向 AI Infra四年前,法国举办的一场 CNCF 大会上,主持人向台下的大模型创业者抛出一个常规问题:“Kubernetes 能为 AI 带来什么?”
来自主题: AI资讯
9340 点击 2026-09-10 09:56

 搜索
四年前,法国举办的一场 CNCF 大会上,主持人向台下的大模型创业者抛出一个常规问题:“Kubernetes 能为 AI 带来什么?”
多模态模型的空间推理,有一种很反直觉的现象:它能看懂图里有什么,也能回答简单的左右上下,却会在换视角、判断方位、推理前后关系时突然失灵。
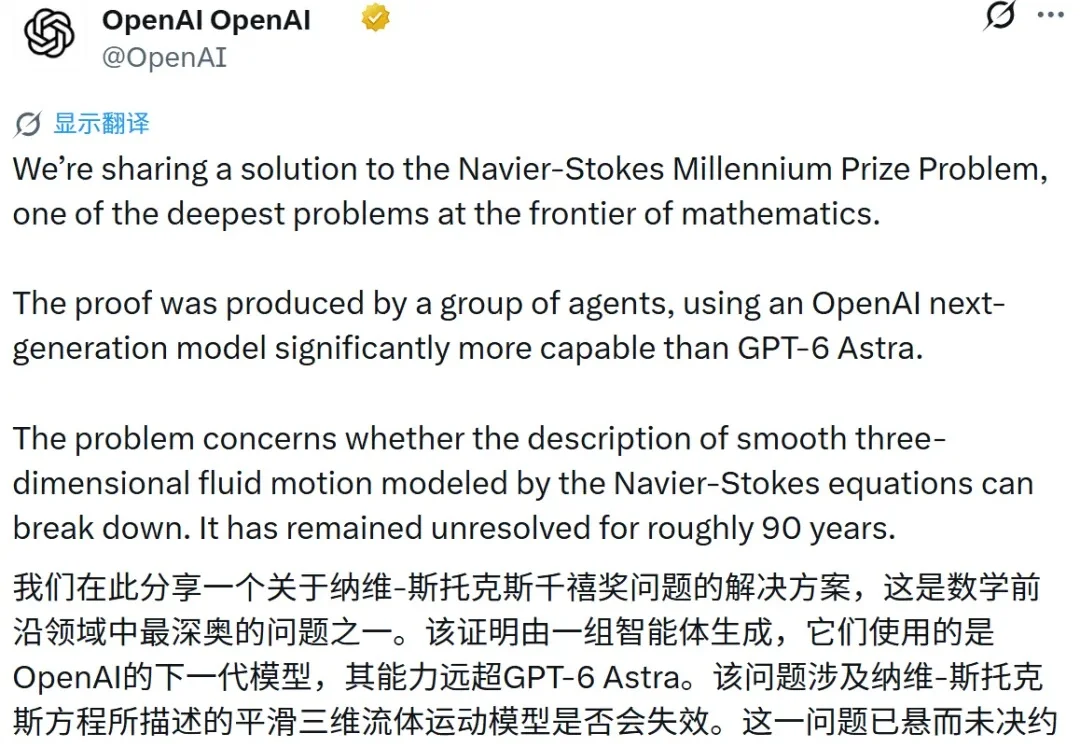
刚刚,OpenAI 发文投下一颗重磅新闻,称他们使用一种比 GPT-6 Astra 更强大的、未公开的下一代前沿大模型,联合约 10000 个并发协作的 AI Agent,仅耗时 88 个小时,便攻克了克雷数学研究所设立的七大千禧年难题之一 —— 纳维 - 斯托克斯方程(Navier-Stokes Equation)的存在性与光滑性问题。
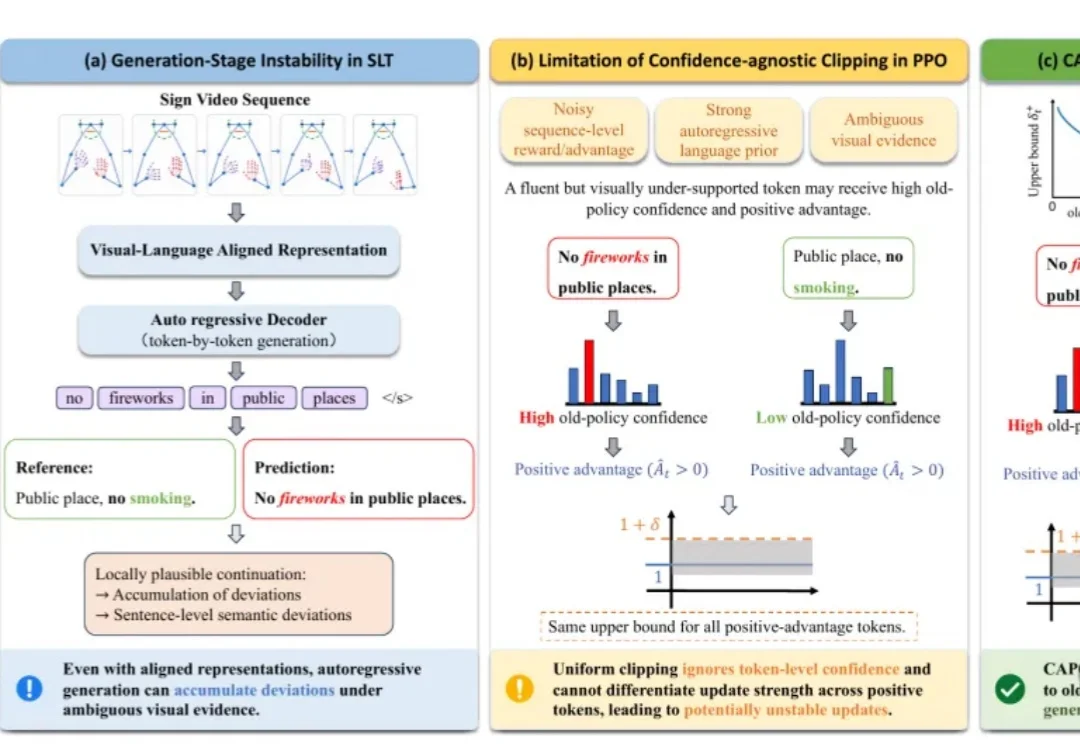
自动手语翻译中,一直存在一个隐蔽难题:模型即使已经较好地对齐了视觉与文本,也可能在逐词生成时,被某个局部合理、却缺少视觉证据支持的词带偏。
9月8日,DeepSeek Harness团队负责人崔添翼在社交平台放出约150个招聘名额,岗位涉及大模型研究平台方向、Agent框架组件方向、研发效率基建方向、数据工程方向等工程师。
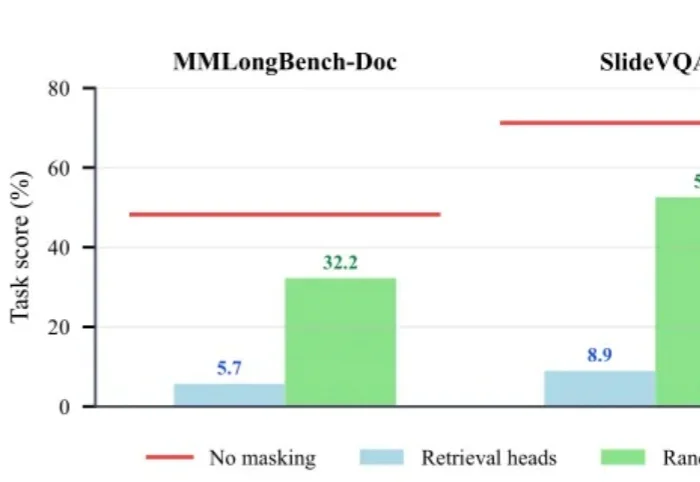
随着Office AI和文档智能体的发展,大模型开始直接处理财报、合同、研究报告等长篇图文材料。
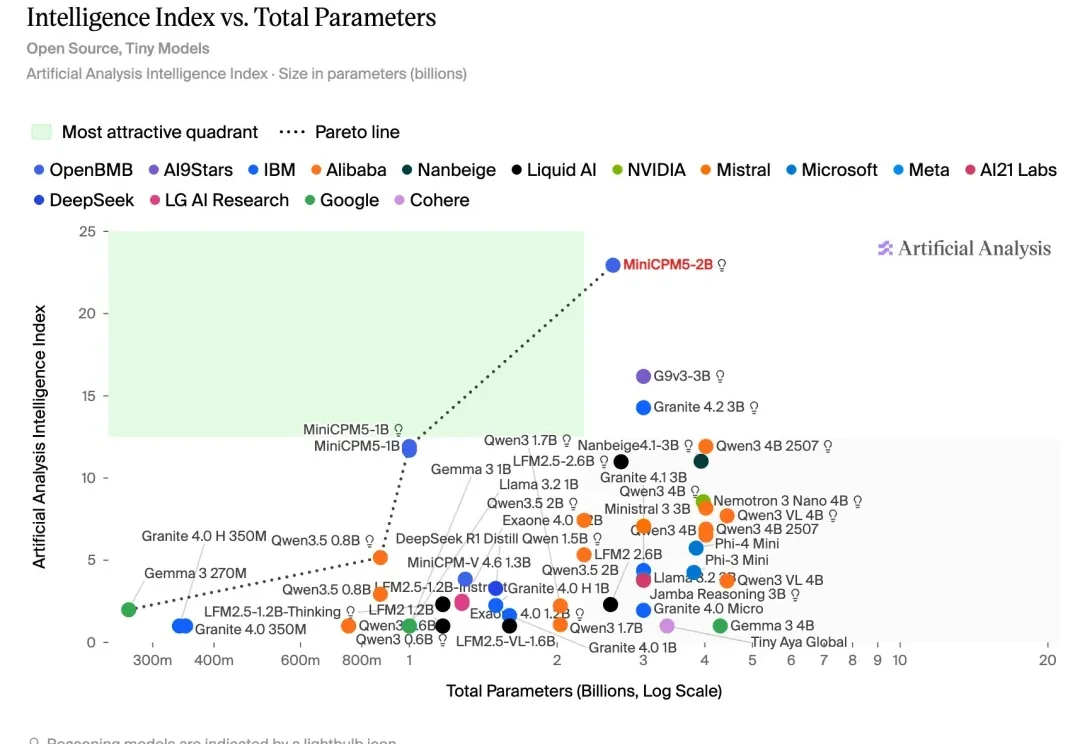
过去几年,端侧大模型一直在不断突破能力边界。
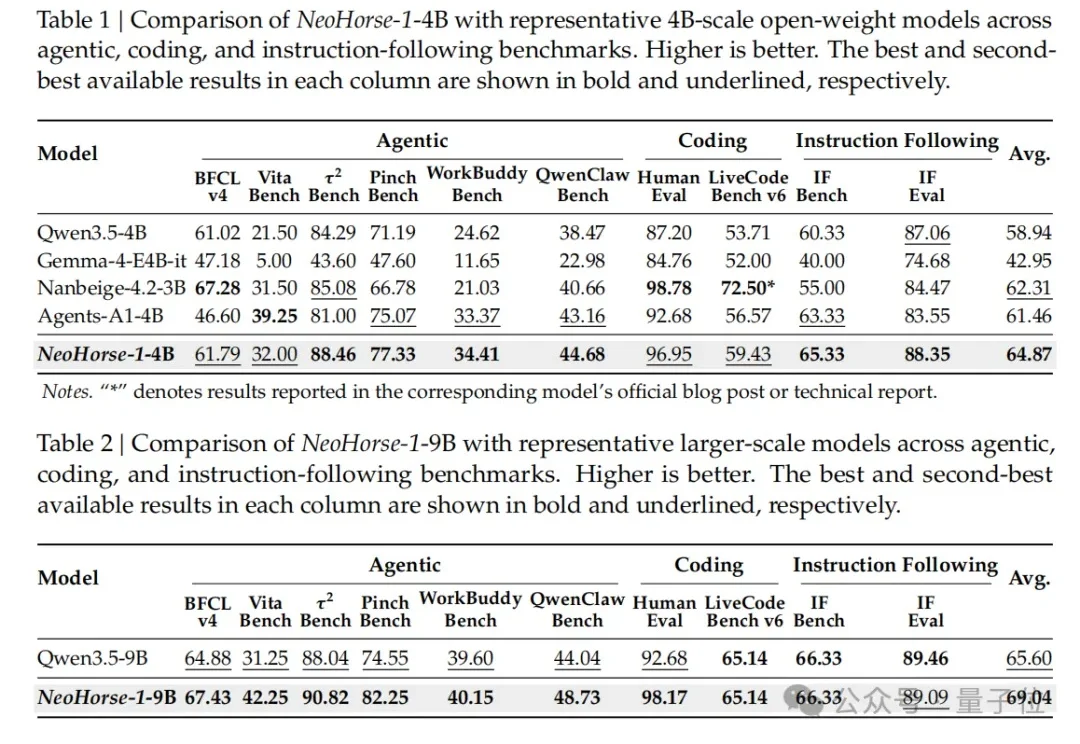
王云鹤创业后,首次交卷了大模型成果。
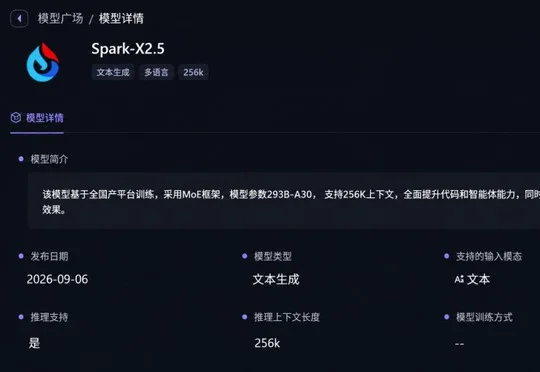
科大讯飞基于全国产算力发布2930亿参数的星火X2.5大模型,在代码、智能体、数学及理解等能力上有所提升,智东西通过游戏开发、3D创作、网页前端、数学推理和小说写作五项任务对其展开实测。
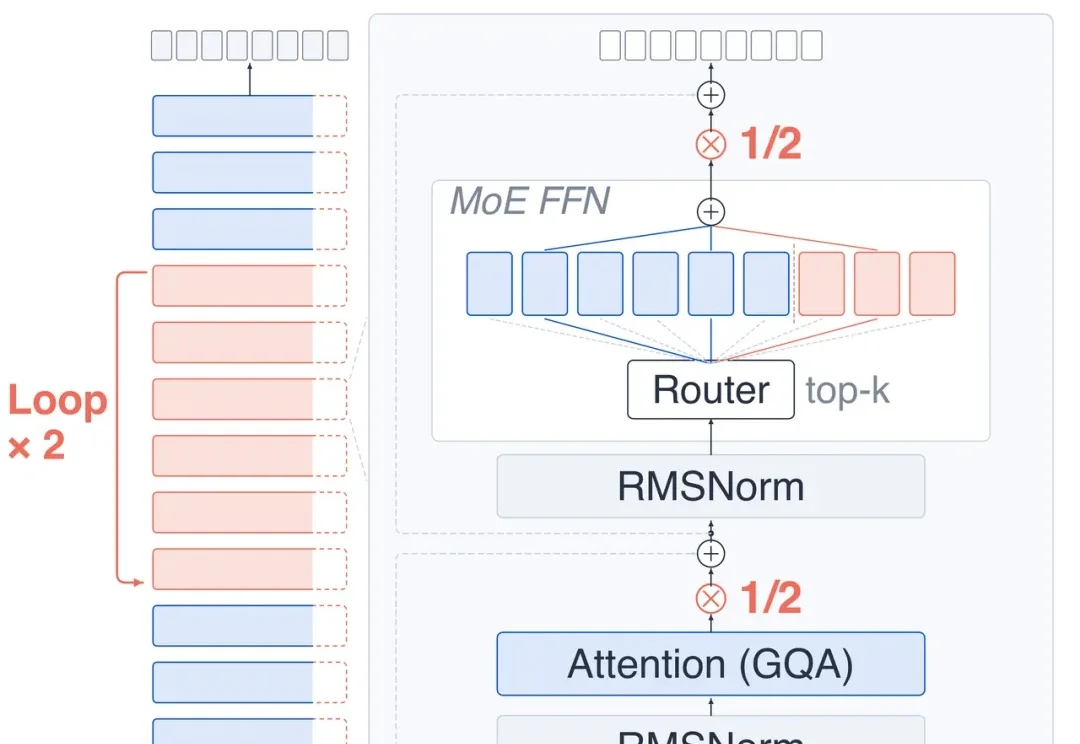
在大模型的发展中,提升能力的主要手段一直是 "做大"—— 更多参数、更多数据、更多算力。如今,另一条思路开始受到关注:与其不断堆叠新的层,不如让已有的层再跑一遍。这就是 Looped Transformer。普通 Transformer 的每一层只执行一次,而 Looped Transformer 会把其中一部分层重复执行,让模型在不增加参数的情况下获得更深的计算。