AI资讯新闻榜单内容搜索-不

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: 不
深度|沃顿商学院研究:万亿AI投资背后,企业如何衡量AI的真实回报

深度|沃顿商学院研究:万亿AI投资背后,企业如何衡量AI的真实回报

深度|沃顿商学院研究:万亿AI投资背后,企业如何衡量AI的真实回报

AI热潮中的万亿美元之问是:企业在这项技术上的投入能否获得回报。然而,衡量这种回报往往存在不确定性,令人困惑,或者并不完整。因为,AI需要一段时间才能带来可以体现在公司利润表上的ROI。
来自主题: AI资讯
9075 点击    2026-10-16 11:43
大模型下个范式:文本生成先写提纲,速度能快31倍

大模型下个范式:文本生成先写提纲,速度能快31倍

大模型下个范式:文本生成先写提纲,速度能快31倍

如今的大模型再聪明,输出内容也是一个字一个字往外蹦。有没有一种可能:真正的 AGI 不是这样?
来自主题: AI技术研报
10524 点击    2026-10-16 11:27
小团队也能预训练!普罗2B:RTX5090训练成本不到5090美元

小团队也能预训练!普罗2B:RTX5090训练成本不到5090美元

小团队也能预训练!普罗2B:RTX5090训练成本不到5090美元

训不起2.8T的K3,玩够了124M的nanoGPT,想试试十亿参数、万亿token的预训练,门槛有多高?
来自主题: AI技术研报
10654 点击    2026-10-16 11:26
EMNLP 2026 | 大模型推理如何再快一步?SpecTr-GBV统一多草稿与块验证,加速推测解码

EMNLP 2026 | 大模型推理如何再快一步?SpecTr-GBV统一多草稿与块验证,加速推测解码

EMNLP 2026 | 大模型推理如何再快一步?SpecTr-GBV统一多草稿与块验证,加速推测解码

大语言模型的生成过程天然具有自回归特性,即模型基于已有上下文逐 token 预测并生成后续内容。随着模型规模不断增大,单步前向计算的开销也随之增加,使得自回归解码面临较高的推理延迟。
来自主题: AI技术研报
8932 点击    2026-10-15 13:56
当视频模型回到原点,它还认得这里吗?Honeycomb用恒定大小记忆守住长视频的一致性

当视频模型回到原点,它还认得这里吗?Honeycomb用恒定大小记忆守住长视频的一致性

当视频模型回到原点,它还认得这里吗?Honeycomb用恒定大小记忆守住长视频的一致性

让视频生成模型沿着相机轨迹不断探索一个场景,并不算最难。真正困难的是:当镜头绕了一圈再次回到原点,房间的布局、家具的位置和墙面的纹理,是否还与最初一样?
来自主题: AI技术研报
10369 点击    2026-10-15 12:04
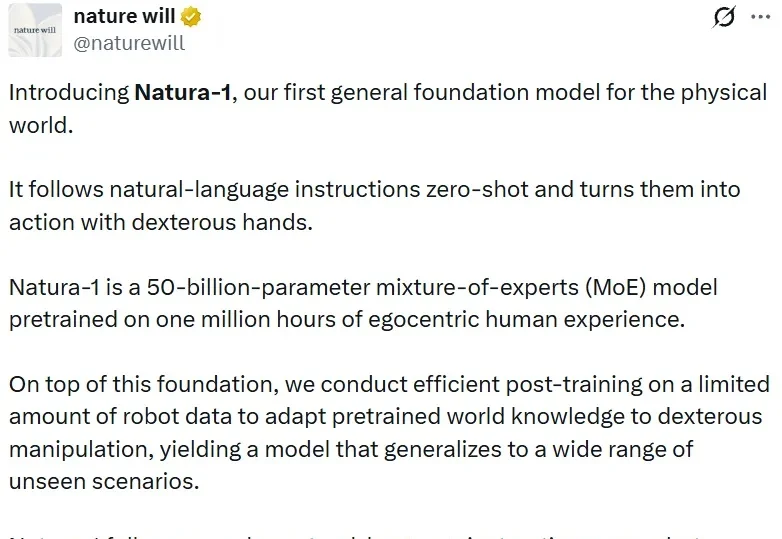
Natura-1发布:从百万小时人类经验中学会零样本泛化与灵巧操作

Natura-1发布:从百万小时人类经验中学会零样本泛化与灵巧操作

Natura-1发布:从百万小时人类经验中学会零样本泛化与灵巧操作

包馄饨,对大多数人来说很简单:一手托皮,一手挑馅,对折,捏边,收口。很少有人意识到,这个过程里手掌始终在承托一张随时会变形的面皮,手指在不断感受馅料和面皮的回弹,两只手还要在恰当的时机交接。

来自主题: AI技术研报
7484 点击    2026-10-15 11:27