华人学生立大功!新王Mamba-3直击Transformer死穴,推理效率碾压7倍
华人学生立大功!新王Mamba-3直击Transformer死穴,推理效率碾压7倍Transformer不保?今天,CMU普林斯顿原班人马杀回,新一代开源架构Mamba-3震撼降临。15亿参数战力爆表,性能比Transformer飙升4%。
来自主题: AI技术研报
9810 点击 2026-03-19 17:36

 搜索
Transformer不保?今天,CMU普林斯顿原班人马杀回,新一代开源架构Mamba-3震撼降临。15亿参数战力爆表,性能比Transformer飙升4%。
xAI华人高管潮水般离开时,所有人以为它要凉,结果Grok Imagine突然三杀登顶!
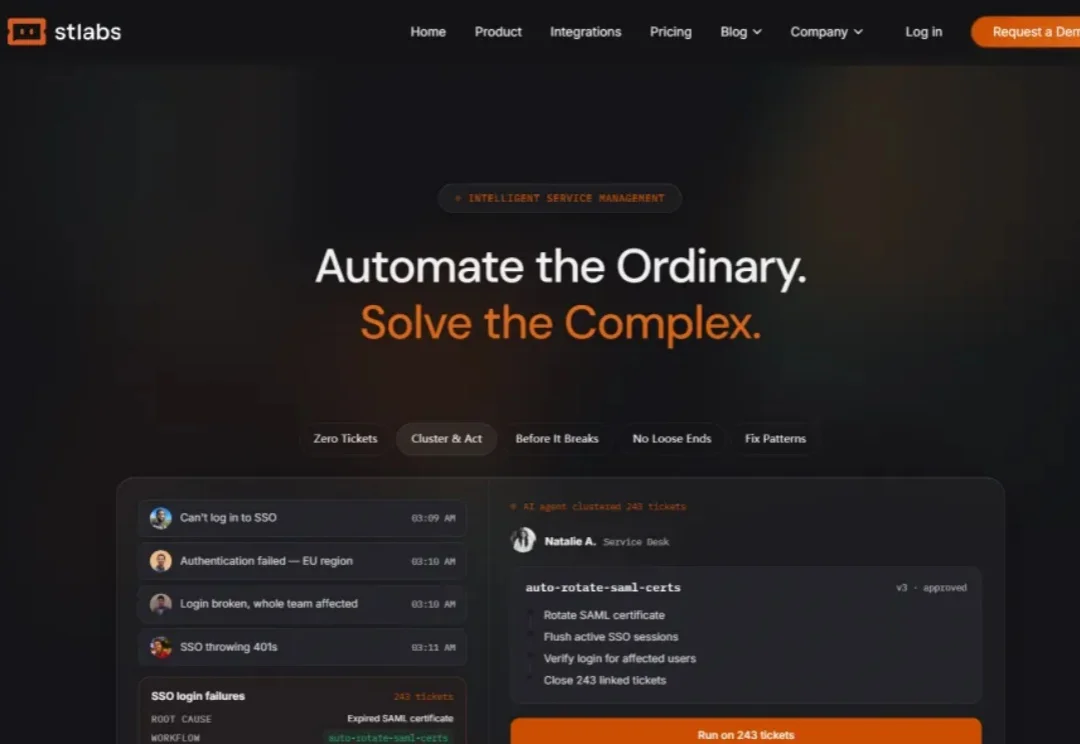
由 Datadog 前总裁阿米特·阿加瓦尔创立的 Standard Template Labs 已完成首轮 4900 万美元融资,旨在重塑大型企业内部信息技术服务的运作方式。
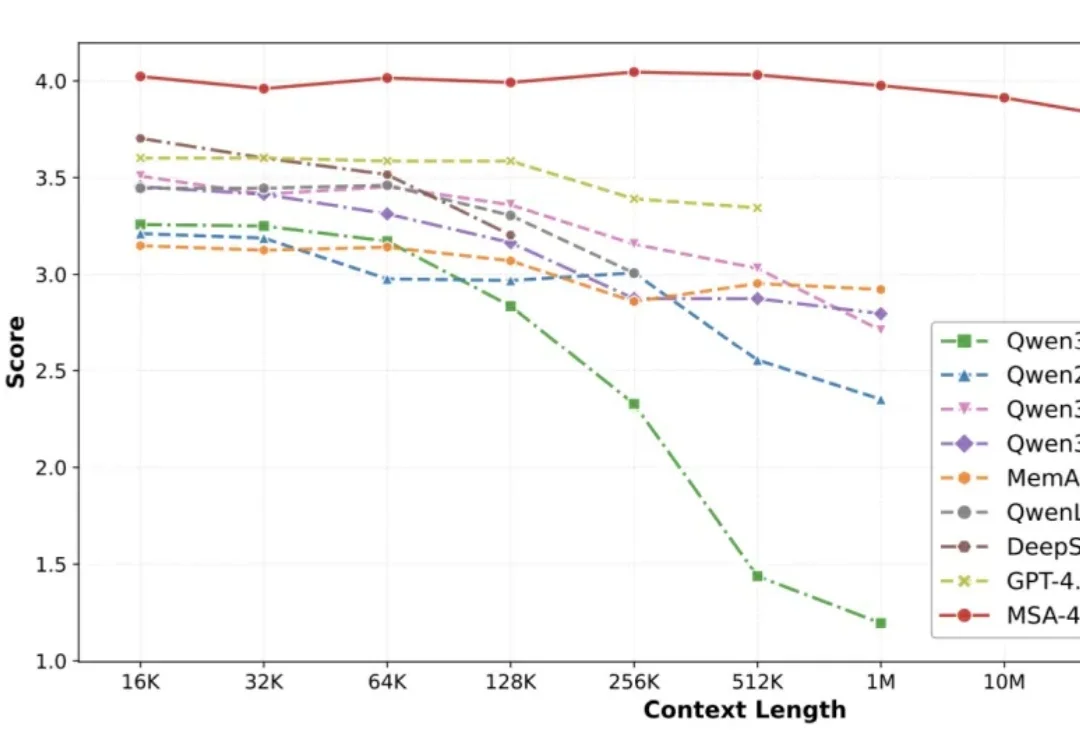
人的智能能力主要由推理能力和长期记忆能力构成。近年来,大模型的推理能力一直处于快速发展过程,但大模型的长期记忆能力一直受限于上下文长度,无法取得突破。在历史上,曾经有多种路线进行尝试,但都无法突破扩展性(Scalability)、精度(Precision)和效率(Efficiency)的不可能三角。
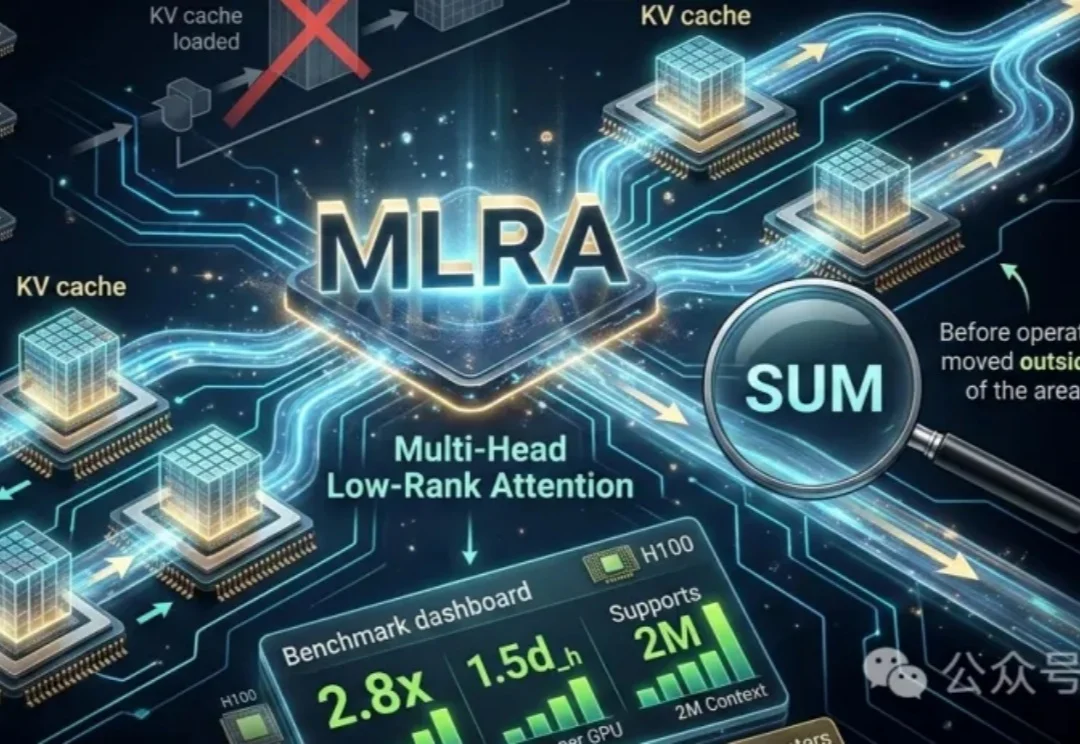
MLRA通过拆分KV缓存为四个并行分支,显著降低显存占用并实现4路张量并行。推理速度比MLA最高快2.8倍,支持百万级上下文,且模型质量更优。无需牺牲性能,即可高效扩展长文本处理能力。
谷歌DeepMind刚刚为Gemini API放了一个大招:内置工具和自定义函数终于可以在同一次调用里混着用了。再加上跨工具的「上下文环流」和Google Maps原生接入,Agent开发的编排噩梦正在终结。
OpenAI 发起全新挑战:你,准备好迎战了吗?
上周,除了 OpenClaw,AI 圈还有个词越来越火🔥。
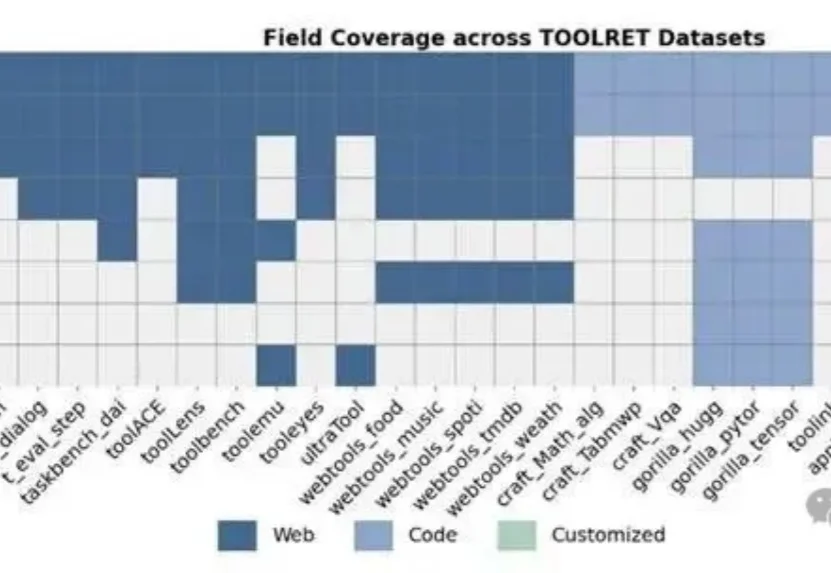
在大模型时代,Tool-Use已经成为智能体能力的核心组成部分。
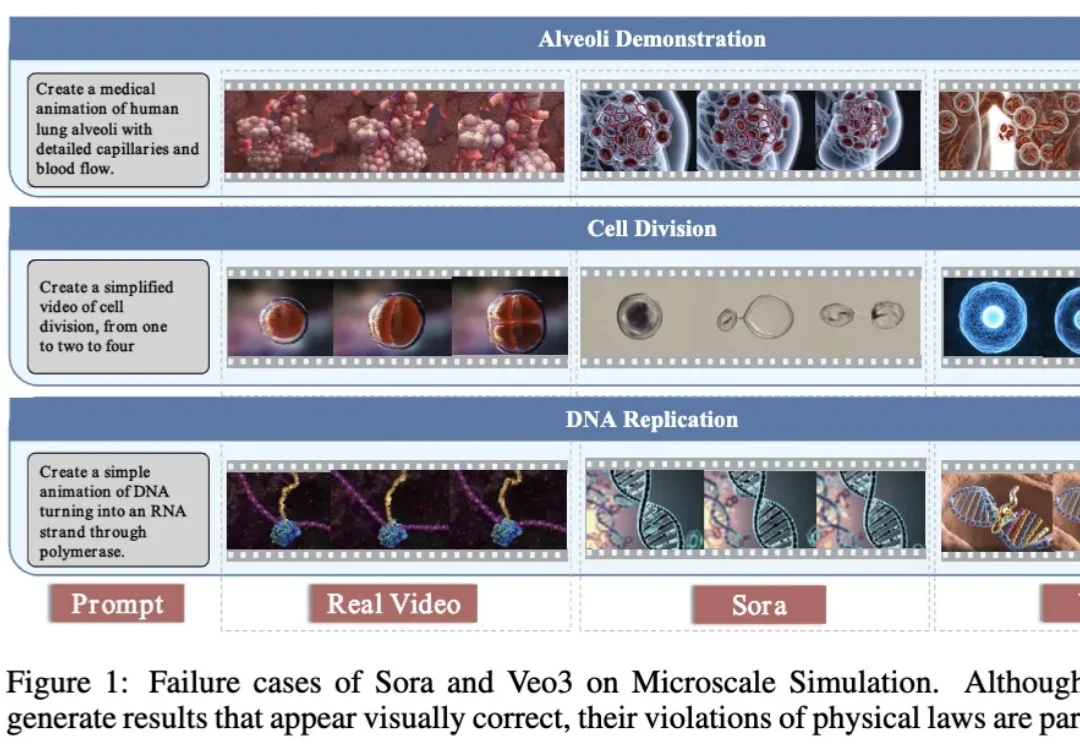
过去两年,世界模型(World Model)正在成为大模型演进的重要方向。