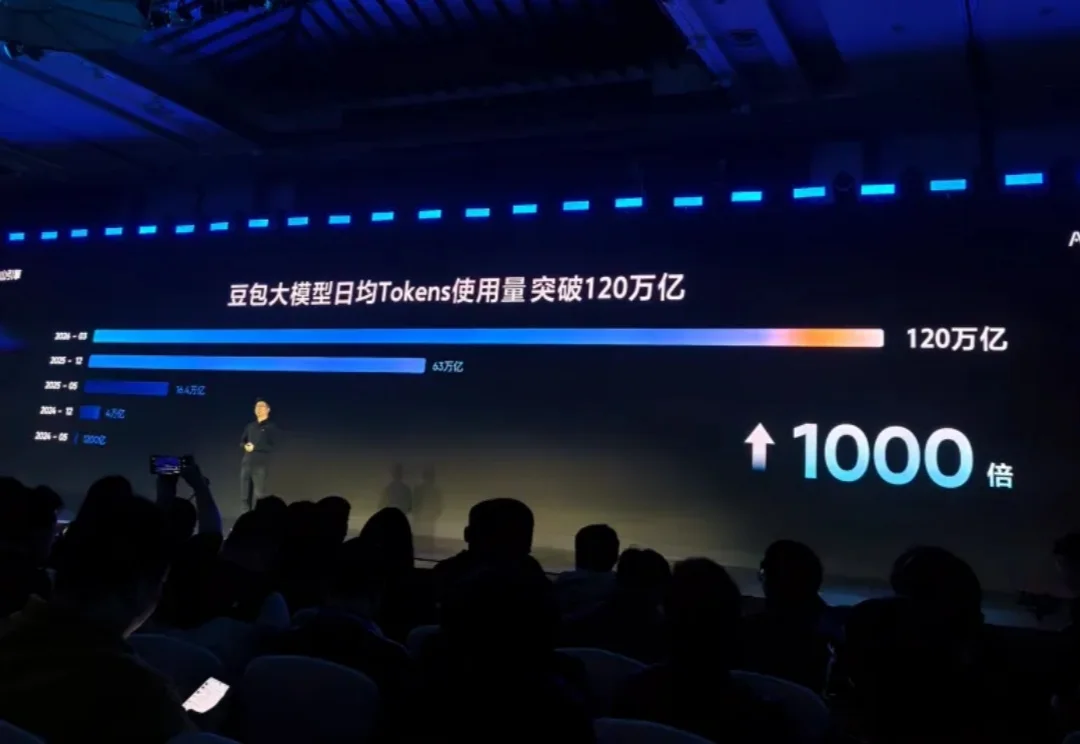
每天120万亿Tokens:Seedance 2.0和ArkClaw龙虾,让豆包大模型调用量炸了
每天120万亿Tokens:Seedance 2.0和ArkClaw龙虾,让豆包大模型调用量炸了每天 120 万亿 Tokens,这就是今天上午火山引擎 AI 创新巡展上,豆包大模型亮出的最新成绩单。
来自主题: AI资讯
8490 点击 2026-04-02 16:23

 搜索
每天 120 万亿 Tokens,这就是今天上午火山引擎 AI 创新巡展上,豆包大模型亮出的最新成绩单。
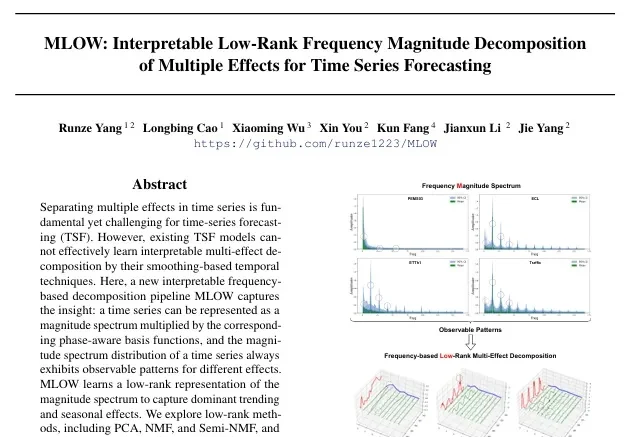
在时间序列预测领域,深度模型如iTransformer、PatchTST虽然性能强劲,却长期困于“黑盒”困境——预测准,但说不出为什么。
104位开发者联手,全球最火开源AI助手OpenClaw再出重磅更新,第一次给AI Agent装上「操作系统」级的任务控制面板:让AI能够自己管理自己,会排任务也会说不:Agent竞赛的下半场来了。
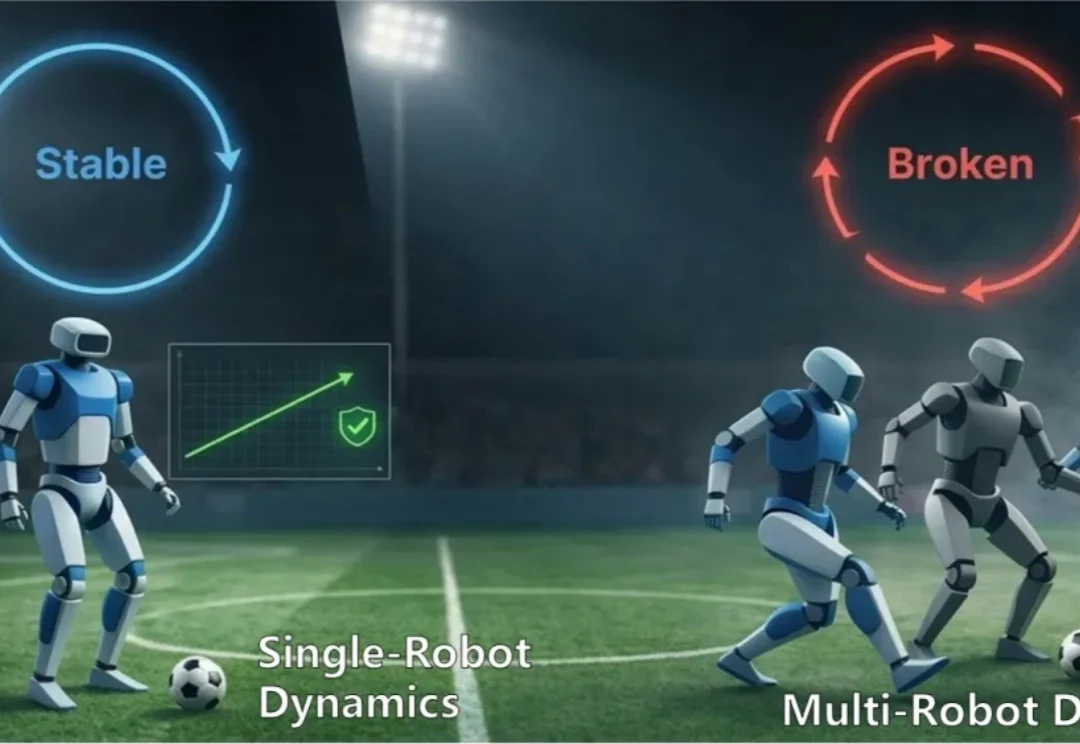
近年来,Decision-Coupled World Model 与 Model-based RL 在机器人领域取得了显著成功。通过学习环境动力学模型,智能体能够在内部模拟未来,从而进行规划与决策。但当系统从单机器人扩展到多机器人时,问题开始变得棘手。
甲骨文凌晨突发裁员,不是愚人节玩笑。
谁能想到,OpenAI核心团队出来创业,竟被21家顶级VC拒之门外?结果5年后,这帮人为了抢一张入场券,不惜支付300倍溢价。复盘这场闹剧,我们只看到了一个词:活该!
相似度超越Seed-TTS、MiniMax-Speech等知名模型。昨晚,美团LongCat团队发布了文本转语音模型LongCat-AudioDiT,并开源1B、3.5B参数量的版本。这一模型的最大特点,是彻底抛弃了梅尔谱等中间表示,直接在波形潜空间进行基于扩散模型的文本转语音。通俗地说,这一模型直接根据声音本身的规律进行生成,“雕刻”出最原始的声音波形,从根源阻断数据转换的级联误差。
大概一周前,我拿到了ColaOS(以下简称Cola)的内测。当时我手里有Claude、Gemini和GPT最新的模型。在Cola出现之前,这几个工具已经足够覆盖我所有的工作场景了。还有什么能比Claude好用?
今天,《人物》杂志发表了一篇报道: 「卧底」Kimi的100小时 文章中提到,Kimi 这群人,很会起名字,起名字的时候很有品味。 在 2025 年的 9 月,公司内部启动了一个小项目,名为「Enso
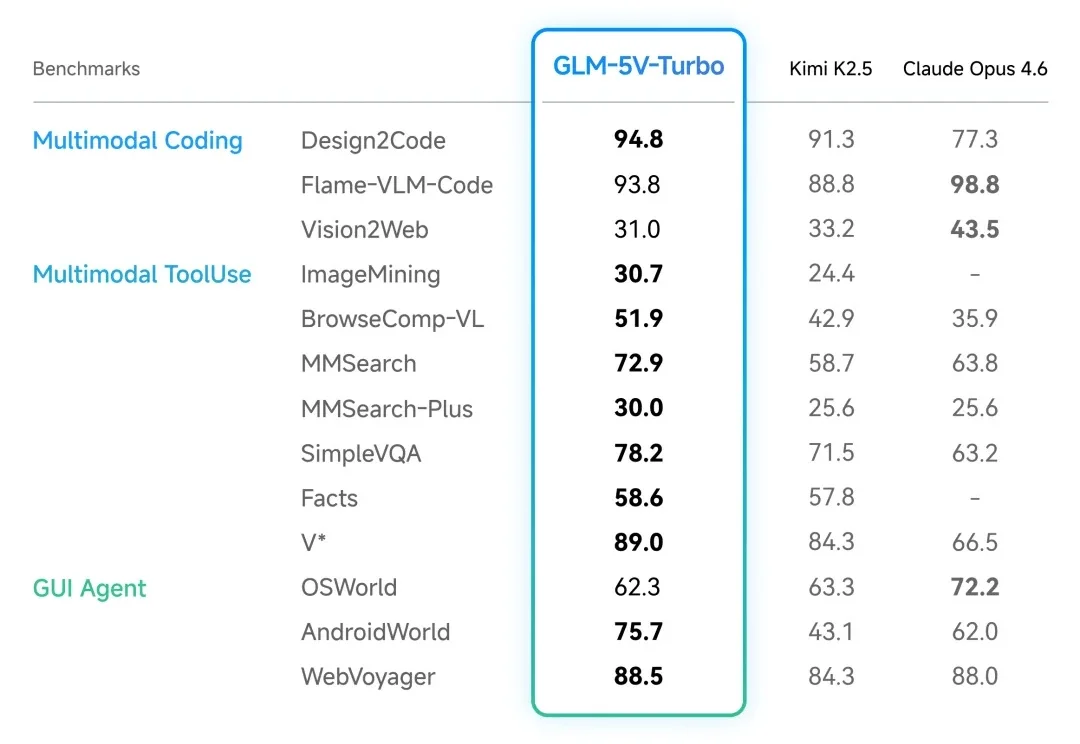
今天,智谱发布 GLM-5V-Turbo,定位「面向视觉编程的多模态 Coding 基座模型」。一句话概括:在 GLM-5-Turbo 的编程和龙虾能力基座上,加入了原生的视觉理解和推理能力