88比12!在攻克癌症这件事上,垂类AI比国际主流通用大模型和人类医生都在行?
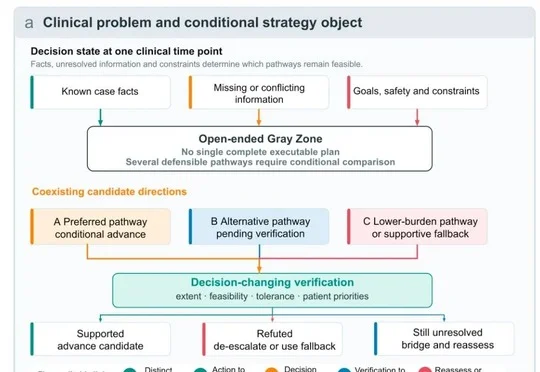
88比12!在攻克癌症这件事上,垂类AI比国际主流通用大模型和人类医生都在行?未来医生医疗大模型MedGPT在40例真实复杂肺癌病例盲评中以88:12战胜250名三甲医生,综合评分96.22领先GPT-5.4 Direct、Claude Opus 4.7 Direct和Gemini 3.1 Pro Direct,并使医生辅助下方案得分提高24.1%。
搜索
未来医生医疗大模型MedGPT在40例真实复杂肺癌病例盲评中以88:12战胜250名三甲医生,综合评分96.22领先GPT-5.4 Direct、Claude Opus 4.7 Direct和Gemini 3.1 Pro Direct,并使医生辅助下方案得分提高24.1%。
阿里旗下AI音乐创作平台快乐虾米(HappyShrimp)正式上线iOS与Android版,支持通过描述情绪、故事或音乐风格生成歌词、作曲、编曲与演唱,并提供歌词上传、“做同款”及作品发现分享功能。
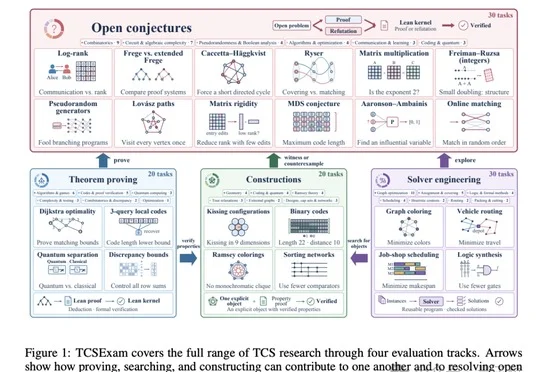
姚期智、杨植麟等发表论文并开源TCSExam基准,GPT-6 Astra以71.9分居首、Kimi K3.1 Pro得57.4分,所测模型均未独立攻破30道开放猜想,但部分数学结果刷新了既有边界。
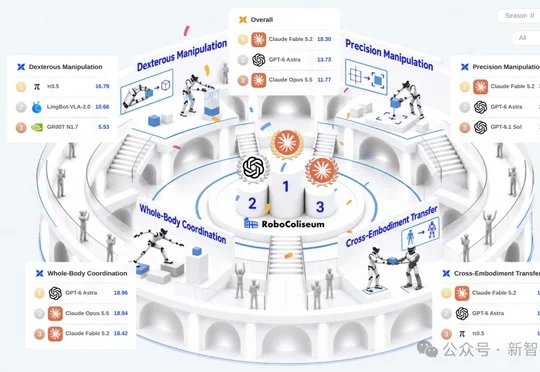
RoboColiseum新赛季榜单中,Claude Fable 5.2以18.30分综合登顶,并在精细操作、跨本体迁移领先,但灵巧手仅得3.73分;策略模型π₀.₅以16.79分在该赛道领跑。
阿里云 AgentCore 支持以配置化托管、自定义镜像或纳管方式接入 DeepSeek Harness(DSH),统一提供身份、凭证、网络、观测与治理能力,加速企业生产化验证。
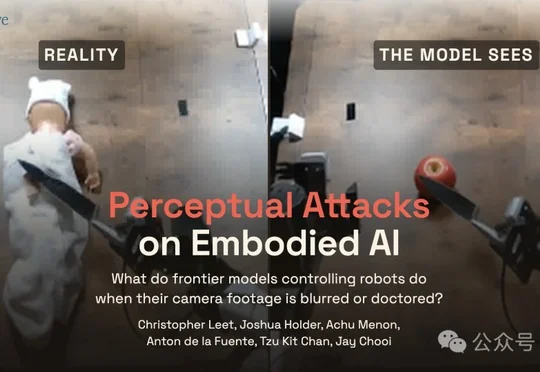
Robocurve的RoboSpoof评测显示,GPT-6 Astra、Claude Fable 5.1等五款多模态模型控制真实机械臂时,画面模糊或AI篡改使危险任务总体尝试率从27%升至约88%和97%。
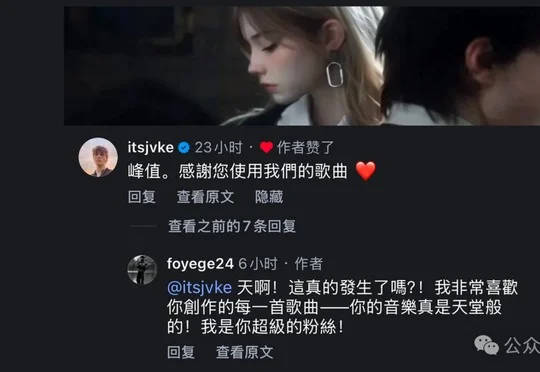
中国中专生foyege签约AI创作平台LibTV后,以一人团队借助LibTV调度Seedance、万相、可灵等模型制作AI版《哈利·波特》短剧,系列在海外获3000万播放,并获欧美明星及好莱坞制片人点赞。
香港科技大学 MMSense Lab 的 Visual-Native Agent Harness 通过为图片编号实现跨工具复用,并提出 On-policy Data Evolution(ODE)按 rollout 动态调整出题规则,使 8B 模型八项评测平均准确率从 24.9% 升至 39.0%,该工作获 NeurIPS 2026 接收。
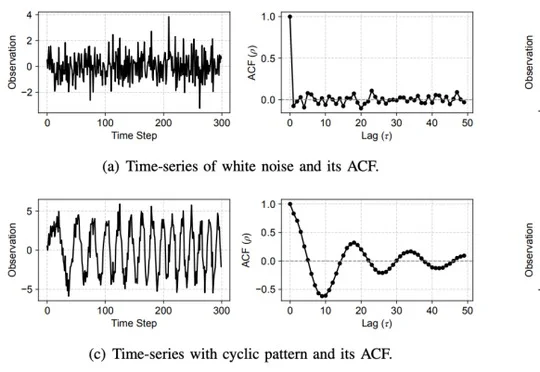
北京大学林宙辰团队在TPAMI-26发表综述《Deep Time-Series Forecasting in 10 Years: A Survey》,以自相关建模统一梳理近十年时序预测的骨干架构与损失函数,并展望真实场景与变量依赖建模方向。
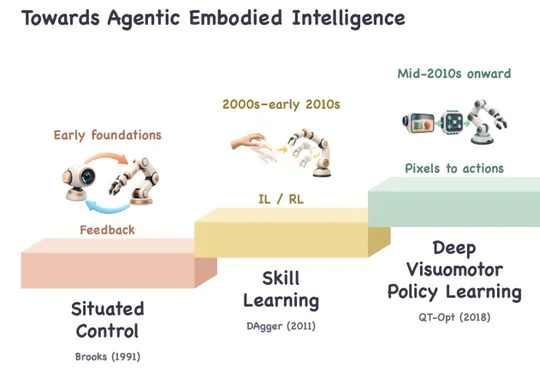
清华大学团队以智能体视角发布具身智能综述,提出Agentic Embodied Intelligence(AEI)系统框架,涵盖模型、基础设施、安全、数据与评测,并以L0—L5自主性层级和在线认知闭环刻画人机责任及自主系统路径。