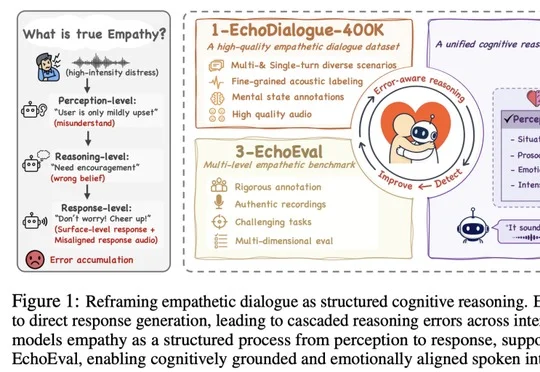
NeurIPS'26 | 如何减少共情推理中的错误传播?
NeurIPS'26 | 如何减少共情推理中的错误传播?香港中文大学与微软团队提出EchoChat,将感知、心理状态推断与语音回复生成纳入统一优化框架,通过级联门控、SDCA步骤级信用分配和AAA声学注意力约束减少共情推理中的错误传播,相关成果发表于NeurIPS 2026,并发布EchoDialogue-400K数据集与EchoEval评测。
来自主题: AI技术研报
10270 点击 2026-11-07 14:46

 搜索
香港中文大学与微软团队提出EchoChat,将感知、心理状态推断与语音回复生成纳入统一优化框架,通过级联门控、SDCA步骤级信用分配和AAA声学注意力约束减少共情推理中的错误传播,相关成果发表于NeurIPS 2026,并发布EchoDialogue-400K数据集与EchoEval评测。
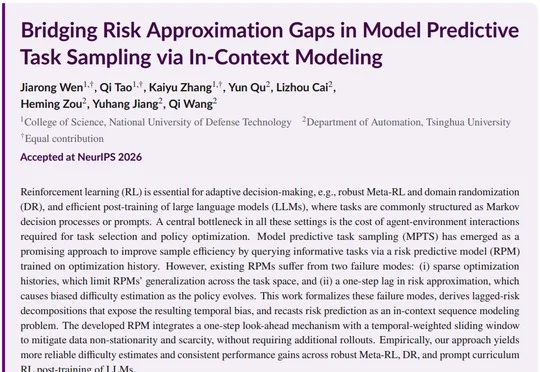
国防科技大学与清华大学团队提出ICRPM(In-Context Risk Predictive Model),利用近期任务—风险记录预测策略更新后的风险,在无需额外rollout或环境交互的情况下提升大模型RLVR、Meta-RL及鲁棒控制中的任务排序与训练效果。
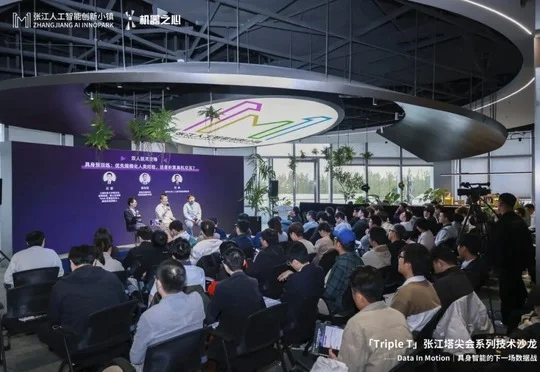
Triple T张江塔尖会技术沙龙聚焦具身智能数据战,嘉宾围绕人类视频、真机交互与仿真数据的选择组合、多模态采集、配方评测及规模化降本展开讨论,强调数据投入应匹配任务与训练阶段并以持续评测验证机器人能力收益。
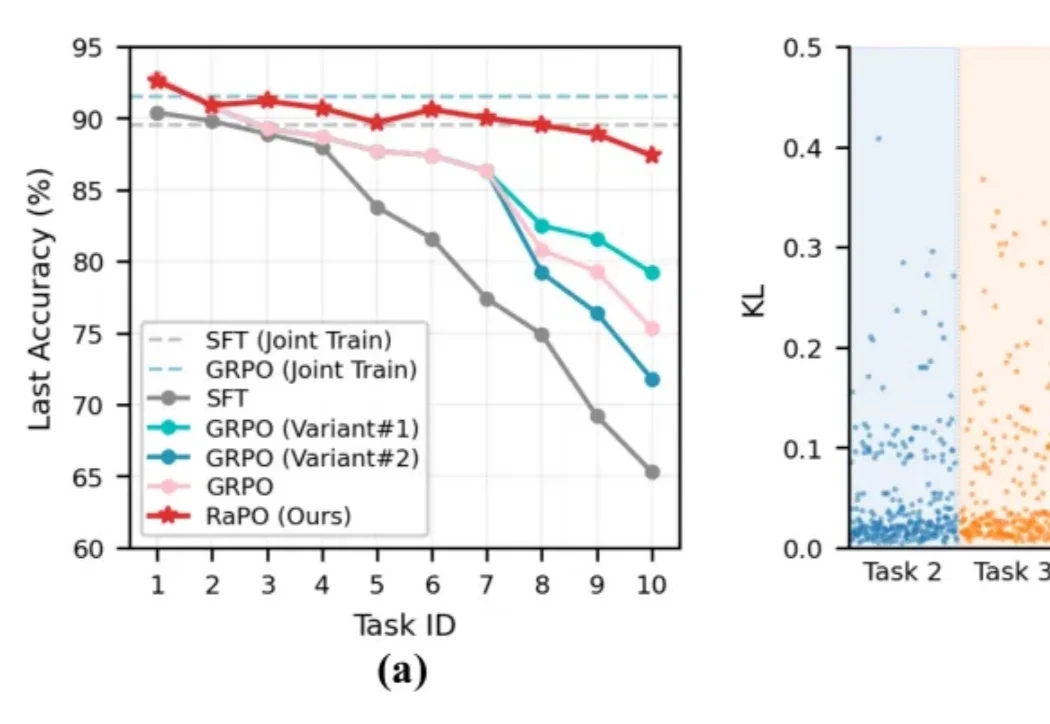
在 LLM/MLLM 领域,基于 verifier 奖励的强化微调(Reinforcement Fine-Tuning, RFT,如 GRPO)在激发复杂推理能力方面展现出显著优势。由于 On-policy 优化的特性,很多研究指出 RFT 相比传统的监督微调(SFT)天然具备更强的抗遗忘能力。
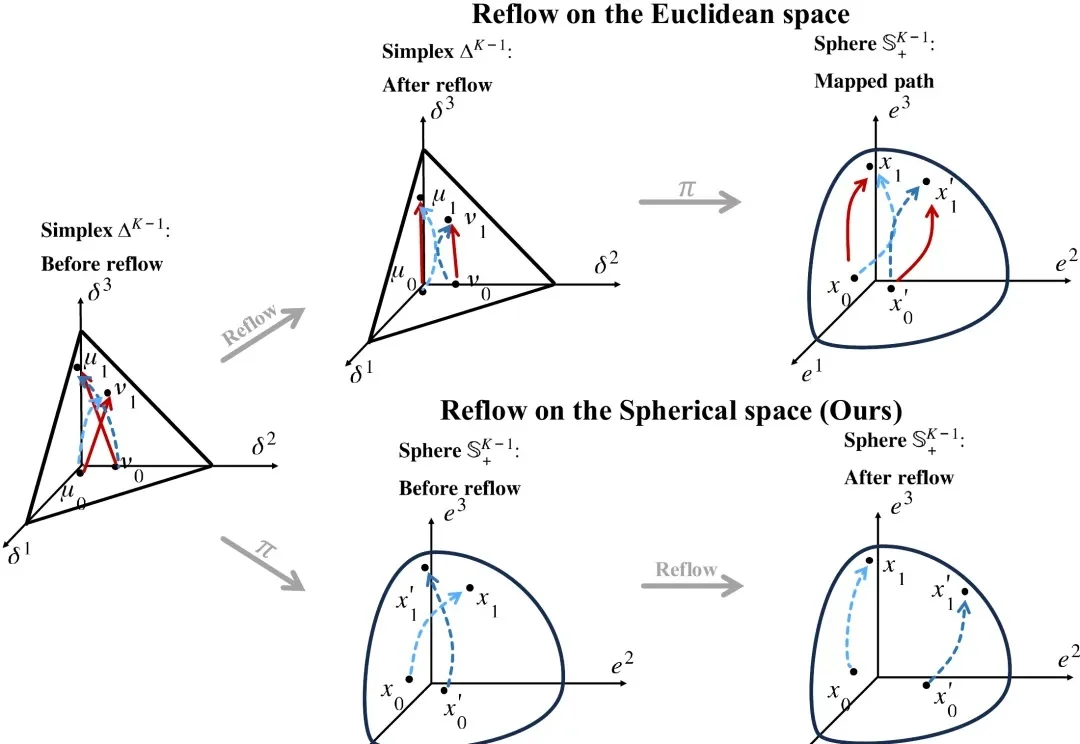
用流匹配(Flow Matching)或扩散模型(Diffusion Models)生成一张手写数字图像、一段 DNA 序列,通常需要从噪声出发,经过多步采样才能得到结果。每一步都要调用模型,生成质量逐渐改善,计算开销也随之增加。
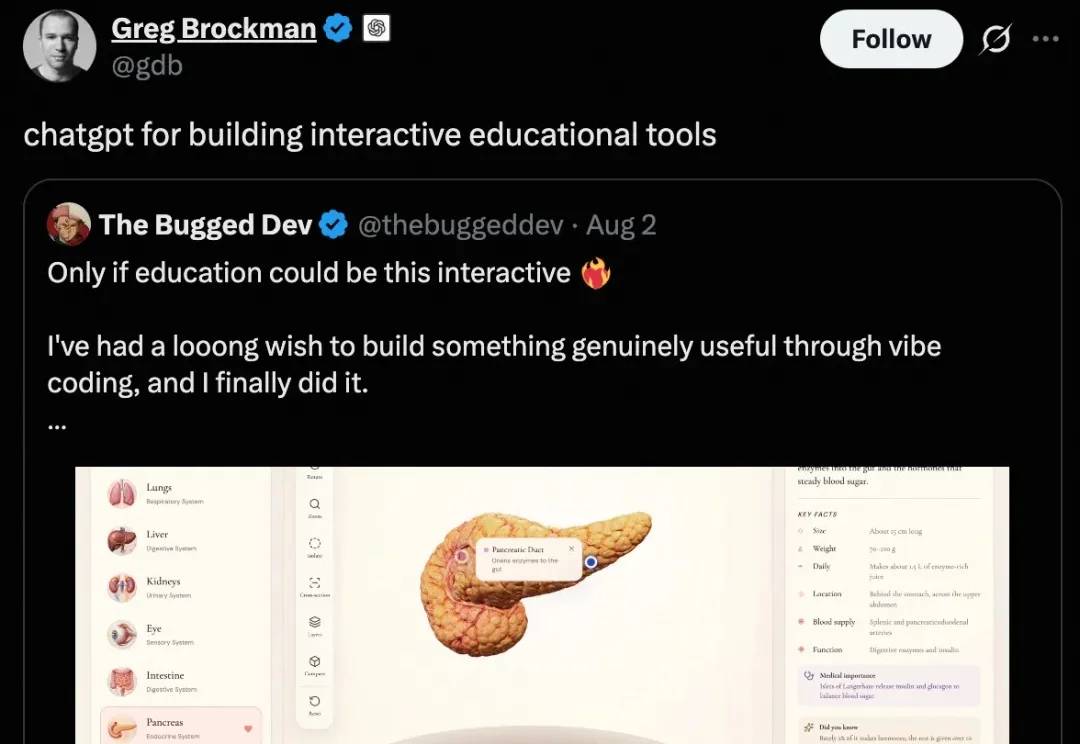
2026年8月,OpenAI联合创始人兼总裁Greg Brockman使用X,转发了一件主题为“人体器官教学”的3D交互网页作品。
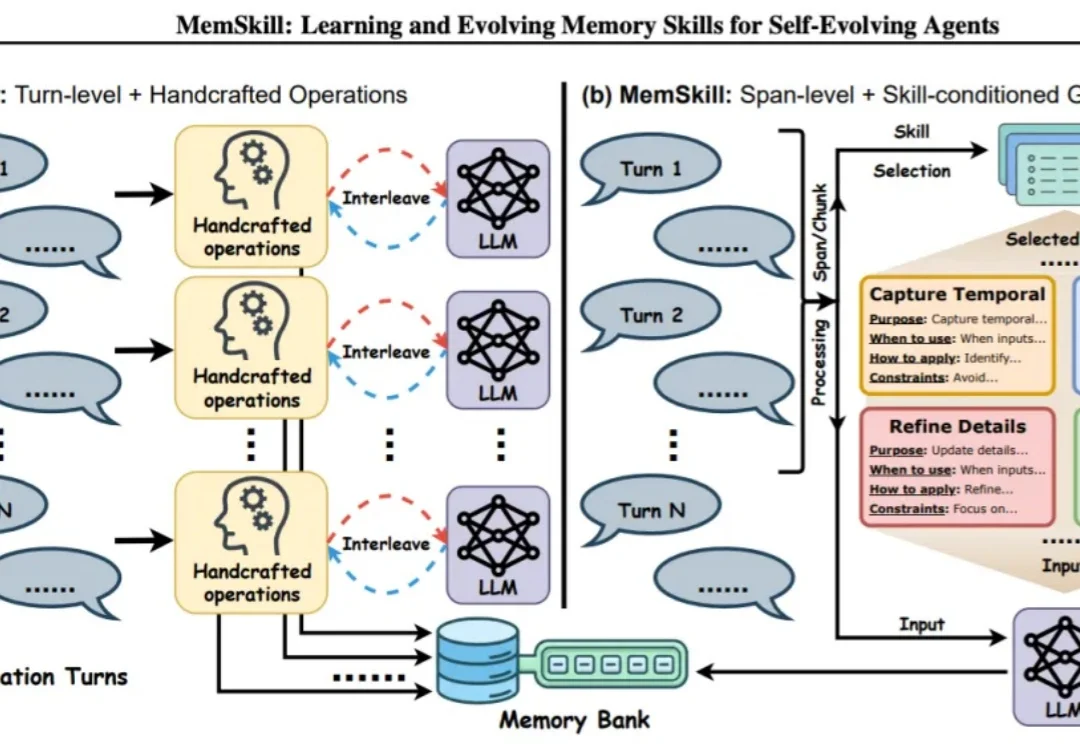
随着递归自我改进(Recursive Self-Improvement,RSI)受到关注,智能体如何从交互经验中持续改进自身成为研究热点。智能体记忆机制影响着这些经验能否被有效保留和利用。
国内大语言模型炒作的重点已经聚焦于3D生成领域,凡更新必展示结合Three.js炮制的4A大作。
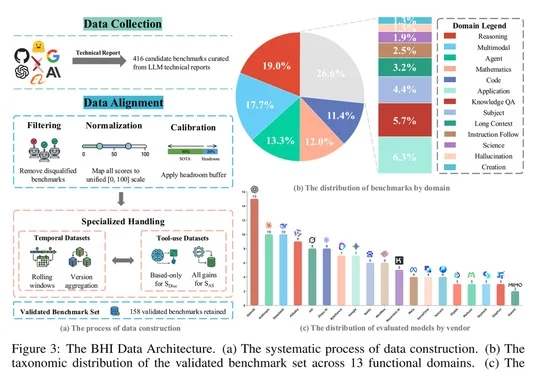
阿里数据团队基于117个模型技术报告筛选158个评测基准,提出基准健康指数(BHI),按能力区分度、抗饱和度和影响力诊断基准,论文获NeurIPS 2026 Evaluations and Datasets Track(Oral)录用,Humanity's Last Exam(HLE)综合第一。
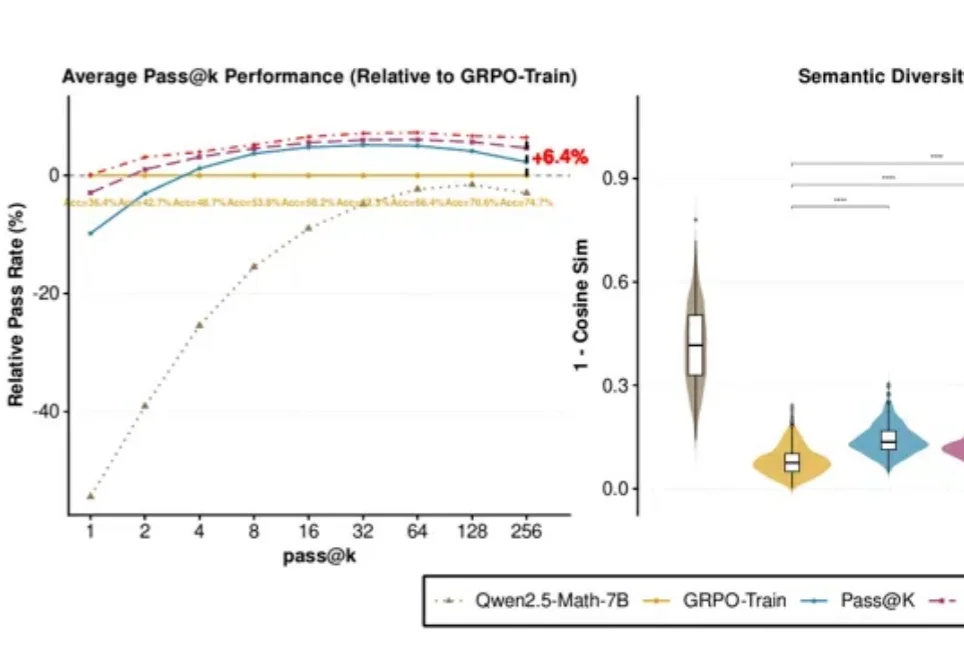
DeepSeek-R1等模型让人们看到了强化学习的潜力。但已有研究发现,模型答得更准,未必意味着能解出的题目更多。