
3分钟上手AI万用插头MCP,一键安装的平价方案,Manus们的工具能力不再受限
3分钟上手AI万用插头MCP,一键安装的平价方案,Manus们的工具能力不再受限终于到了适合跟大家介绍大模型的万能接口 MCP(Model Context Protocol)的时候了!
来自主题: AI资讯
9229 点击 2025-03-19 14:39

 搜索
终于到了适合跟大家介绍大模型的万能接口 MCP(Model Context Protocol)的时候了!
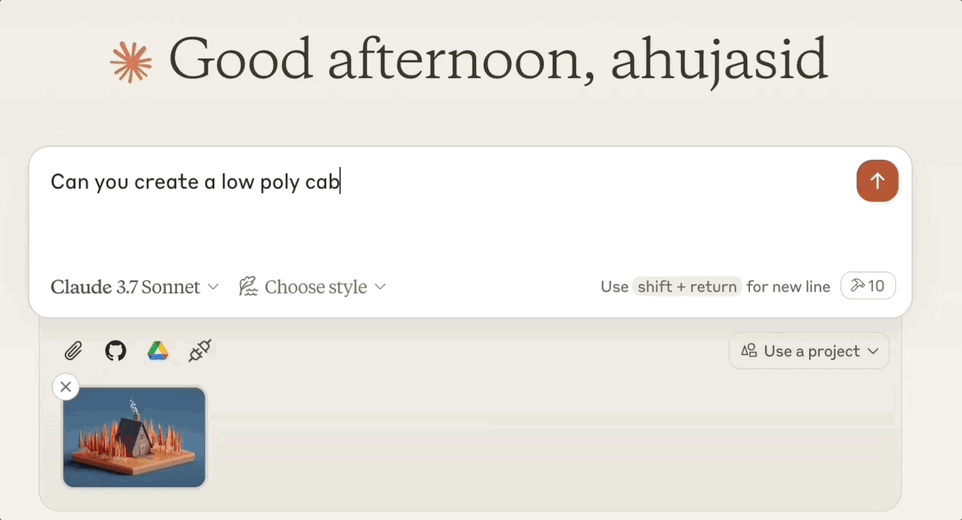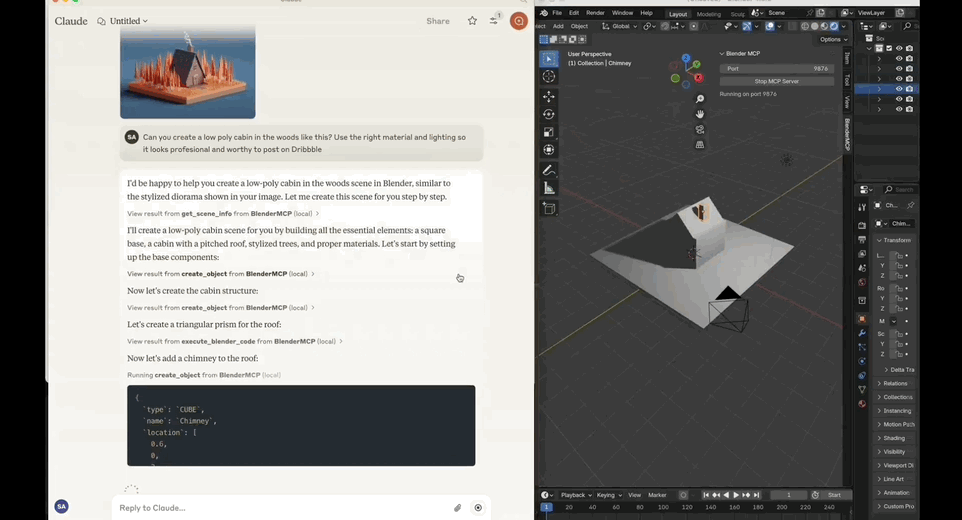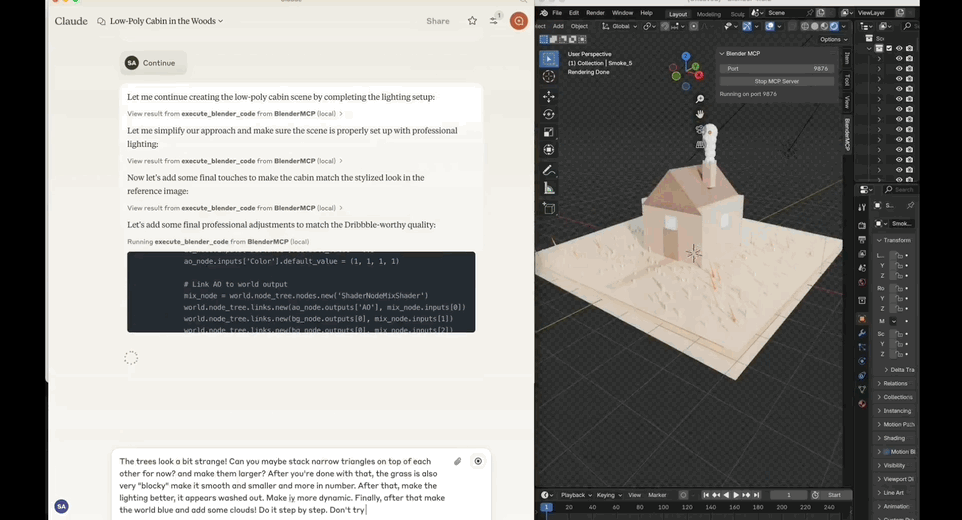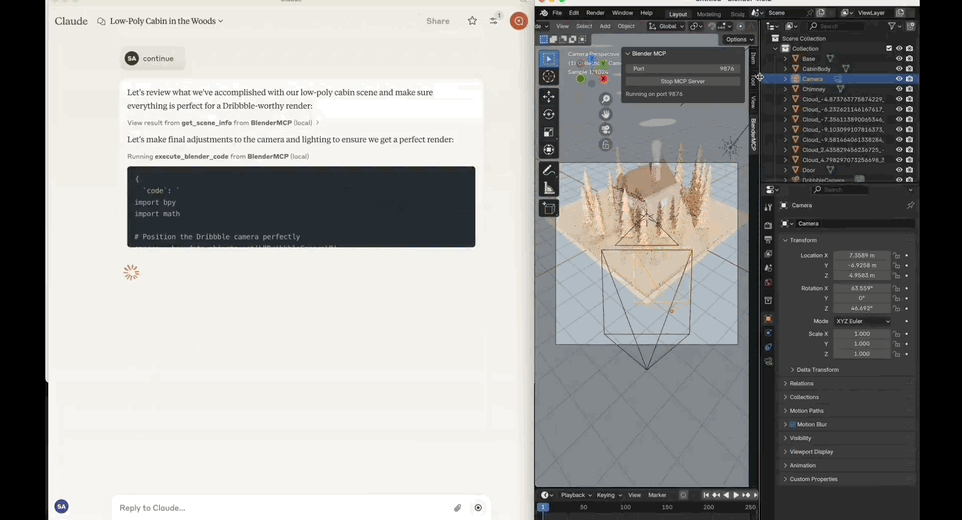
一句话提示,Claude自动化打开Blender将2D图片转为3D建模。背后关键还是最近大火的MCP(Model Context Protocol)——复刻Manus的重要诀窍。将这套协议和Blender打通,即可获得如上效果。该开源项目BlenderMCP,上线短短3天,GitHub标星已达3.8k。

3月11日的The CEO Speaker series论坛上,Dario Amodei分享了从AI即将编写几乎所有代码,到可能取代50%的工作岗位,再到DeepSeek的崛起和给AI一个「躺平」按钮等等看法。看起来兴奋又忧心忡忡。
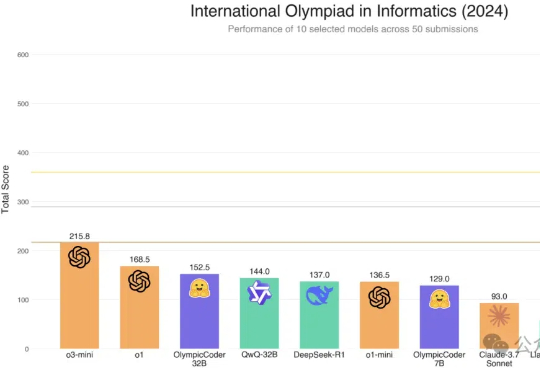
Hugging Face的Open R1重磅升级,7B击败Claude 3.7 Sonnet等一众前沿模型。凭借CodeForces-CoTs数据集的10万高质量样本、IOI难题的严苛测试,以及模拟真实竞赛的提交策略优化,这款模型展现了惊艳的性能。
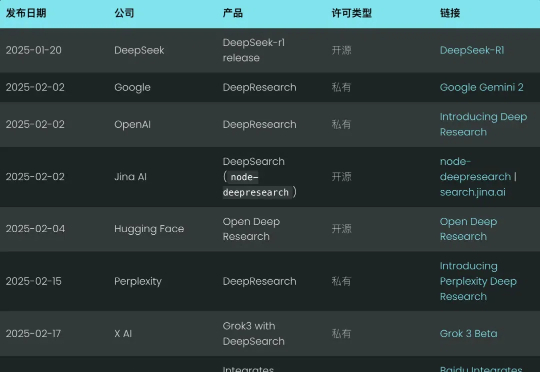
这才 2 月份,深度搜索(Deep Search)就已经隐隐成为 2025 年的新搜索标准了。像谷歌和 OpenAI 这样的巨头,纷纷亮出自己的“Deep Research”产品,努力抢占这波技术浪潮的先机。(我们也很自豪,在同一天也发布了开源的node-deepresearch)。
ChatGPT 平地一声雷,打乱了很多人、很多行业的轨迹和节奏。这两年模型发布的数量更是数不胜数,其中文本大模型就占据了 AIGC 赛道的半壁江山。关注我的家人们永远都是抢占 AI 高地的冲锋者。

哥大的大二学生Roy Lee,靠AI作弊顺利取得亚马逊、Meta、TikTok等大厂的offer!被告发后,哥大在11日将举行听证会,但小哥表示,自己已经买了单程票,到时自己并不会在学校,甚至可能退学。如今,小哥已经成了网红,AI作弊神器Interview Coder卖60美元一个月,公司收入快破百万了。
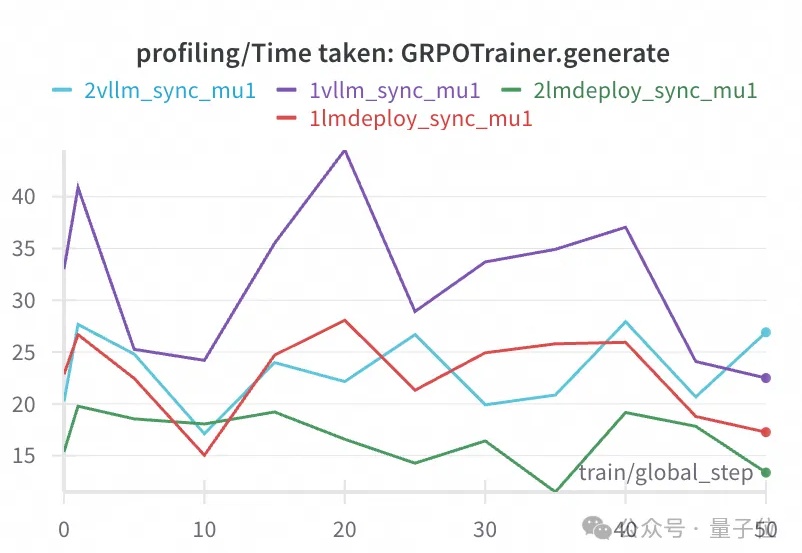
GRPO训练又有新的工具链可以用,这次来自于ModelScope魔搭社区。
回顾 AGI 的爆发,从最初的 pre-training (model/data) scaling,到 post-training (SFT/RLHF) scaling,再到 reasoning (RL) scaling,找到正确的 scaling 维度始终是问题的本质。

DeepSeek R1 催化了 reasoning model 的竞争:在过去的一个月里,头部 AI labs 已经发布了三个 SOTA reasoning models:OpenAI 的 o3-mini 和deep research, xAI 的 Grok 3 和 Anthropic 的 Claude 3.7 Sonnet。