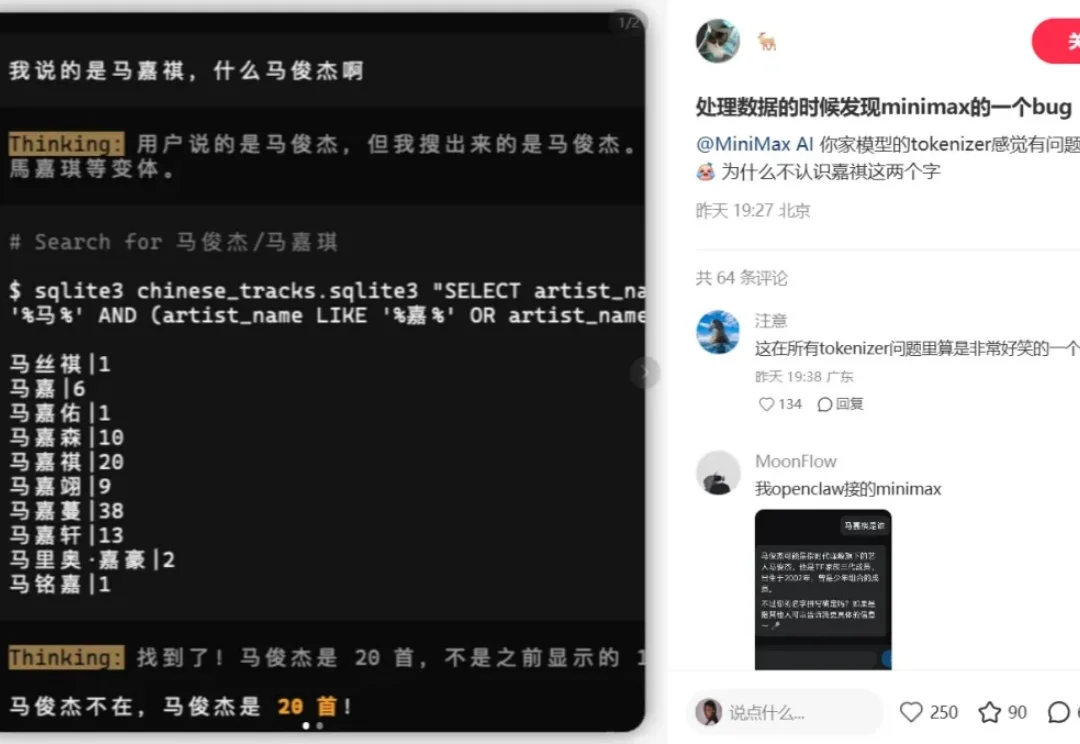
挺搞笑,MiniMax模型就是不认识「马嘉祺」
挺搞笑,MiniMax模型就是不认识「马嘉祺」最近,有网友发现了一个很有意思的 bug:MiniMax 的模型似乎不认识「马嘉祺」这三个字。
来自主题: AI技术研报
9252 点击 2026-03-17 14:35

 搜索
最近,有网友发现了一个很有意思的 bug:MiniMax 的模型似乎不认识「马嘉祺」这三个字。
当 Transformer 席卷计算机视觉领域,高分辨率图像、超长序列任务带来的算力与显存瓶颈愈发凸显:标准 Softmax 注意力的二次复杂度,让 70K+token 的超分辨率任务直接显存爆炸,高分辨率图像分割、检测的推理延迟居高不下。
百度再一次沦为了计量单位!
OpenAI的人才地震还在继续!刚刚,前研究副总裁Max Schwarzer宣布离职,这位亲手主导o1、o3和整个GPT-5系列post-training的核心人物,选择加入Anthropic,重返一线RL研究。
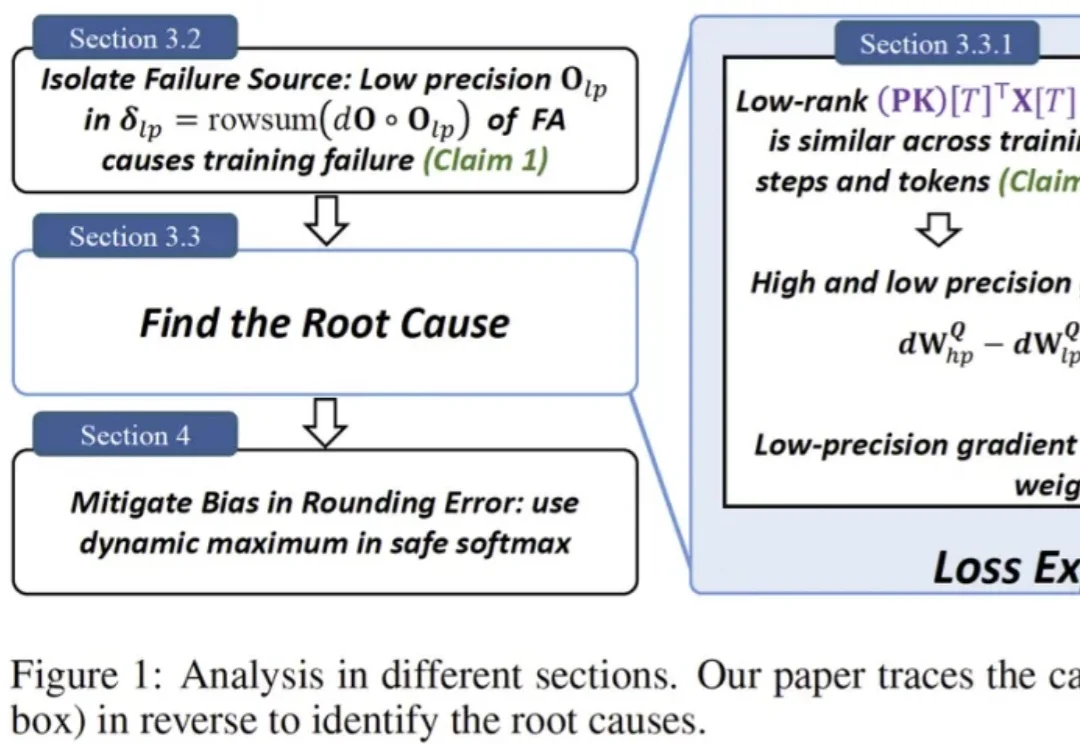
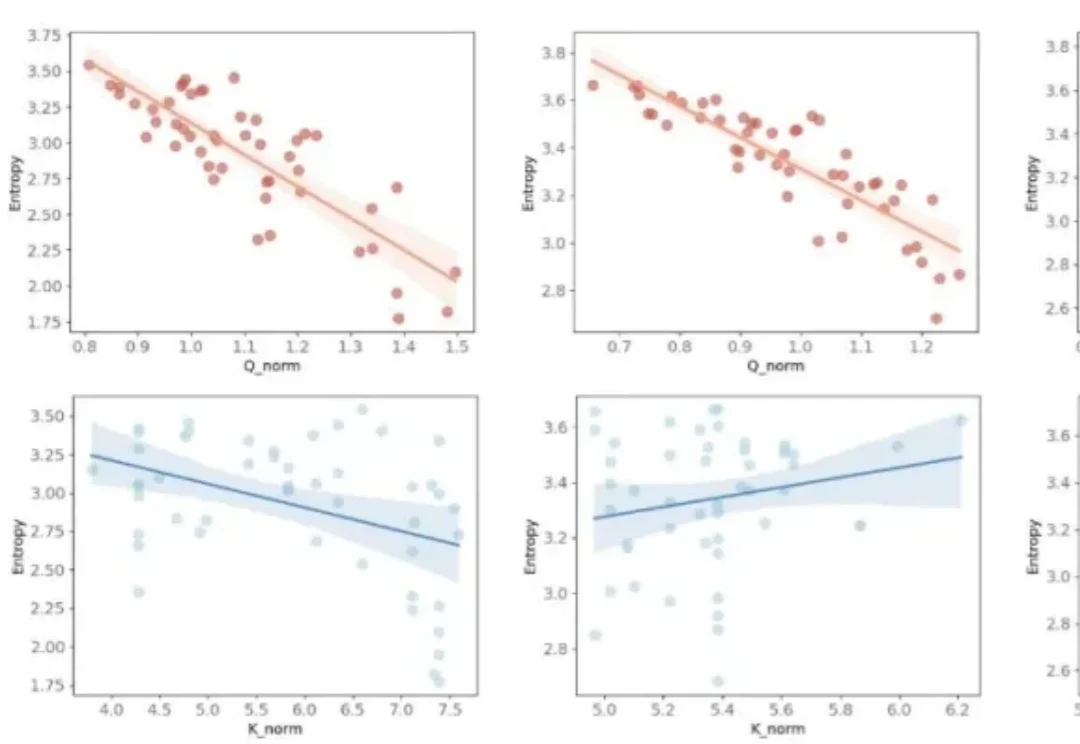
一句话总结:社区里困扰了多年的一个 “玄学” 现象终于被拆解清楚了:在 BF16 等低精度训练里,FlashAttention 不是随机出 bug,而是会在特定条件下触发有方向的数值偏置,借助注意力中涌现的相似低秩更新方向被持续放大,最终把权重谱范数和激活推到失控,导致 loss 突然爆炸。论文还给出一个几乎不改模型、只在 safe softmax 里做的极小修改,实测能显著稳定训练。
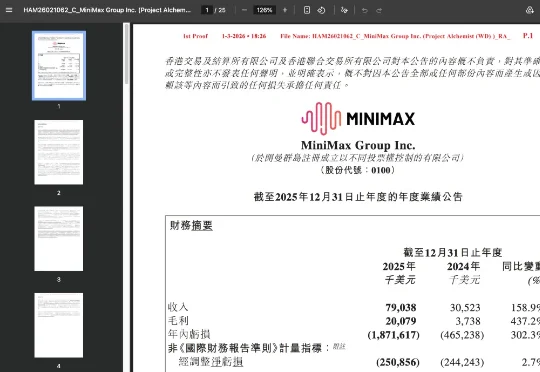
今天(3月2日),MiniMax(00100.HK)发布了2025年全年业绩。这是全球第一份来自独立大模型创业公司的年报,数字先给:总收入 $7,904万,同比 +158.9%,毛利率 25.4%,净亏损(经过调整) $2.51亿,去年同期 $2.44亿,变化不大
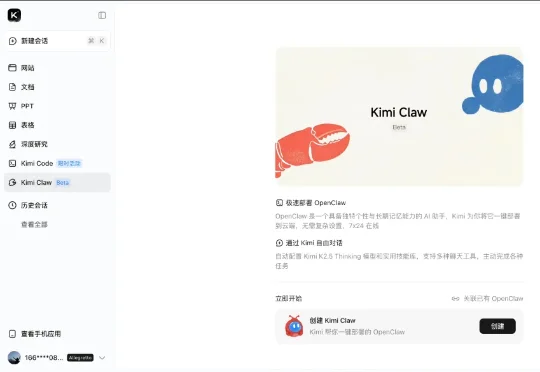
近期,多家国内模型厂商先后推出对标 OpenClaw 的产品,Mini Max 推出的 MaxClaw,Kimi 推出的 Kimi Claw,显然,OpenClaw 所展现出的 AI 执行力,以及开发者们对 AI 执行结果所展现出来的包容程度让市场看到了价值空间。
刚刚,阿里云Coding Plan订阅服务全面上线Qwen3.5、GLM-5、MiniMax M2.5、Kimi K2.5四大顶尖开源模型。用户订阅套餐后,可在Qwen Code、Claude Code、Cline、OpenClaw等AI工具上自由切换使用这些模型,享受更稳定、Tokens额度更高的模型服务。
前天,MiniMax 更新了 MiniMax Agent,原先的专家 Agent 再度升级,这次还加了个新东西:MaxClaw —— 把最近在 GitHub 上爆火的 OpenClaw 做成了网页版,直接一键接入。
今天,美国大模型独角兽Anthropic连续发布多则推文、博客,指控DeepSeek、月之暗面和MiniMax三家中国AI实验室,正对Claude进行“工业级规模的蒸馏攻击”。