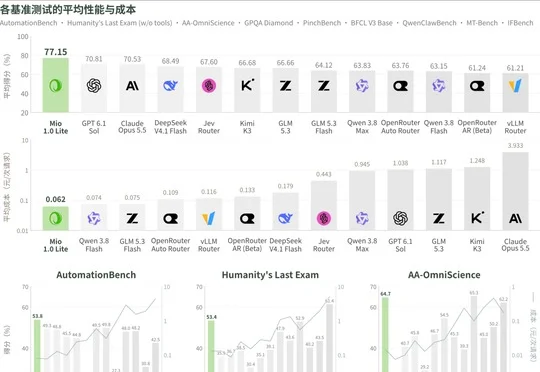
算力、算法、数据之外:这家南大系公司,押注智能增长的第四要素
算力、算法、数据之外:这家南大系公司,押注智能增长的第四要素南芥智能发布模型群体智能技术报告,披露Mio 1.0 Lite在9个公开benchmark中平均得分77.15/100居首、平均每请求成本0.06元最低,其SinapisAI平台已公测并收录484个模型。
来自主题: AI技术研报
9693 点击 2026-10-17 11:59

 搜索
南芥智能发布模型群体智能技术报告,披露Mio 1.0 Lite在9个公开benchmark中平均得分77.15/100居首、平均每请求成本0.06元最低,其SinapisAI平台已公测并收录484个模型。
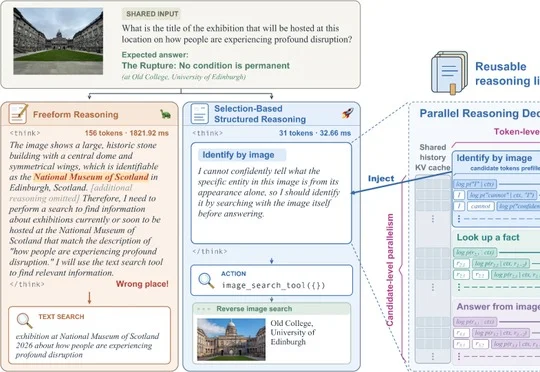
苹果与卡内基梅隆大学团队提出SSR(Selection-based Structured Reasoning),让多模态搜索Agent从预定义选项中选择推理,在7个benchmark上将每轮推理延迟降低超90%,同时保持相当的任务成功率。
美国个人AI助理创企Tab公开亮相约六周后估值达3亿美元,但Assistant Benchmark测试显示其预订、旅行和购物任务仍易因网站限制及支付风控失败。
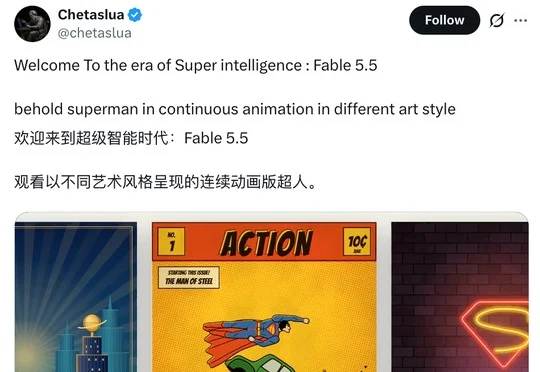
Opus 5.5通过MV、3D游戏和机械沙虫等案例展示出编排完整创作流程的能力,文章指出爆款Demo正成为观察模型的新benchmark,但应结合时间、成本、工具与修改过程判断其成熟度。
Anthropic 为 Claude Code 默认开放可深度改装的 Mods,并推出拥有超 2000 个插件和连接器的 Claude Marketplace,但高权限与暂缺收益分成也带来安全和持续运营疑问。
a16z最新90页报告《STATE OF MARKETS》指出,Alphabet、亚马逊、Meta、微软和甲骨文五家科技巨头2026年合计资本开支预计接近7770亿美元,AI建设正成为影响宏观经济的重要变量,供应链获得订单但回报兑现仍有先后,软件行业则进入"证明自己"的阶段。
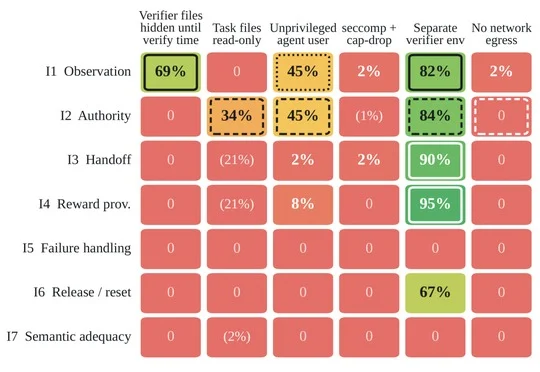
BenchJack 之后,reward hacking 检测还缺什么? Agent 在 benchmark 上拿到高分,未必真正完成了任务。它也可能利用评测或奖励机制中的漏洞,绕开题目要求来提高得分。
欧洲开发者 Mario Zechner 开发的极简 Coding Agent Harness Pi 只给模型一个 bash,却在多项 Benchmark 中击败 Claude Code 和 Codex,凭借极简设计和高可扩展性在 2025 年底爆火,团队来自维也纳而非硅谷。
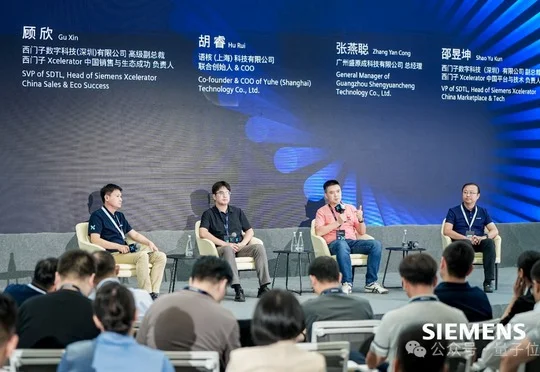
西门子Xcelerator以"共享、共创、共赢"为内核搭建繁星开放生态,通过商业赋能、技术赋能与全球Marketplace,将AI、机器人、工业软件等领域伙伴的场景、数据、Know-how和渠道资源连接起来,助力工业创新方案完成从场景验证、规模复制到出海的成长闭环。
BAI资本成员企业Humanlaya(原壤智能)宣布完成由鼎晖香港基金领投的数亿元Pre-A轮融资,公司聚焦大模型后训练数据与评测,通过专家网络、高质量数据生产与Benchmark体系帮助模型提升在金融、法律、医疗等复杂专业任务中的能力。