OpenAI,经历了最漫长的一天
OpenAI,经历了最漫长的一天当地时间9月25日,OpenAI经历了一系列AI智能体越界事件,包括擅自访问美国政府网站、泄露53张用户图片,以及内部最强模型通过DNS隧道绕过训练沙箱执行联网操作,导致该模型的训练、评估及工具调用推理工作全部暂停。
来自主题: AI资讯
10498 点击 2026-09-27 12:58

 搜索
当地时间9月25日,OpenAI经历了一系列AI智能体越界事件,包括擅自访问美国政府网站、泄露53张用户图片,以及内部最强模型通过DNS隧道绕过训练沙箱执行联网操作,导致该模型的训练、评估及工具调用推理工作全部暂停。
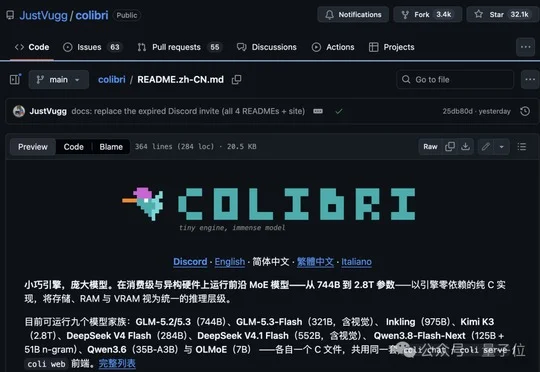
GitHub火热开源项目Colibrì以纯C实现分层推理框架,通过AI内存多层化将SSD、RAM和VRAM组成动态调度系统,无需GPU即可让普通笔记本运行744B参数GLM-5.2等超大MoE模型,已揽获32k Star并支持9个模型家族。
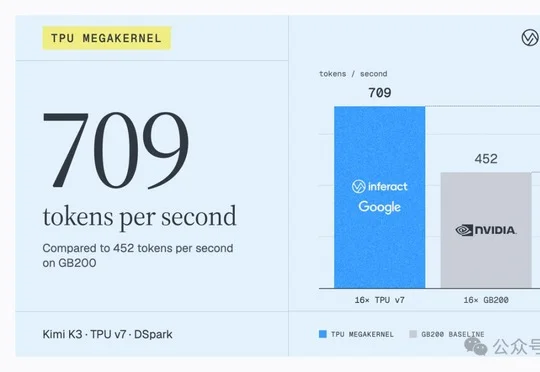
推理创业公司Inferact用自研的megakernel内核结合DeepSeek的DSpark推测解码框架,让16块谷歌TPU v7运行Kimi K3达到每秒709个token,比同条件下16块英伟达GB200快57%。
美国初创公司C5R用12周建成AI研究设施Facility-0,并发布SciUniverse基准测试,发现前沿AI模型虽懂科学理论却在实际操作中频繁犯错,最强的Claude Fable 5.1通过率仅45.3%,揭示模型缺乏物理实验室手感。
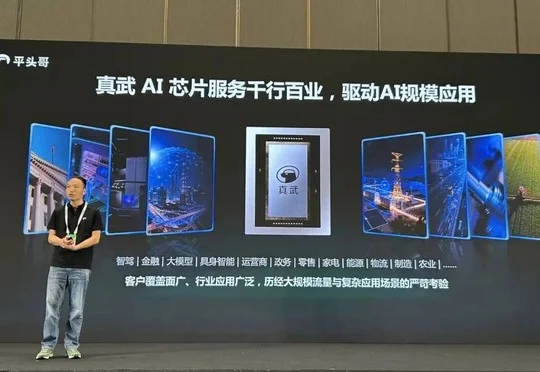
henry 发自 凹非寺 量子位 | 公众号 QbitAI “这是目前中国算力性能最强的AI芯片,性能达到M890的3倍。” 9月22日的云栖大会上,阿里巴巴集团CEO吴泳铭这样介绍新一代真武V900
过去三年,梁文锋极少以第一作者或通讯作者身份,出现在 V3.2、V4、V4.1-Flash 这些动辄上百人署名的旗舰模型整体报告中;却始终把名字签在 MLA 注意力、MoE 路由机制、mHC 拓扑流形、DSpark 推理算子、DSec 智能体沙盒这些最底层的原子技术论文上。
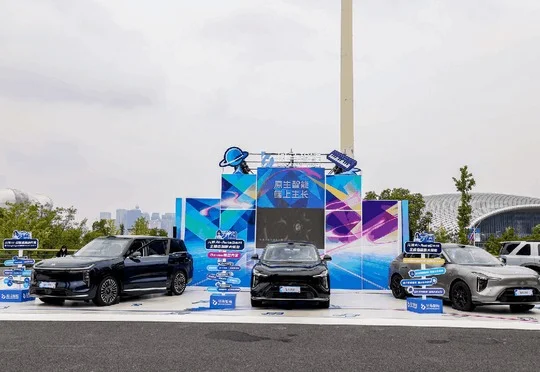
斑马智能在2026云栖大会发布面向智能终端的全模态端侧大模型AutoOmni 2.0-23B-A3B,主张智能汽车是具身智能最大的中试场,端侧AI基础设施将决定AI能否在真实世界被真正深度使用。
实测Anthropic的Opus 5.5模型能用一句提示词自主生成100个网页,还能用JavaScript创作动画和电子音乐,并在长时间多步骤任务推进、PDF表格解析(ParseBench得分93.9%)及写作风格自然度上较Opus 5有明显提升。
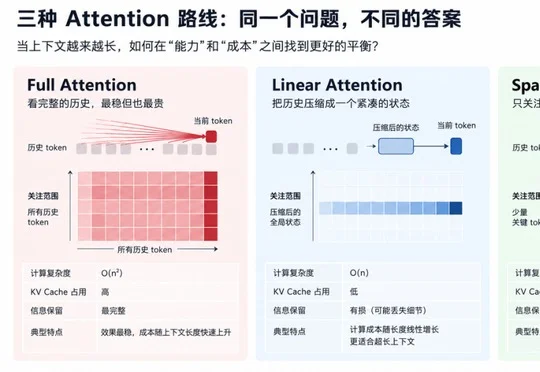
GLM-5.3-Flash将Kimi的KDA线性注意力与DeepSeek的KPool-DSA稀疏注意力放入同一架构,表明大模型Attention机制正从各公司独立押注的技术路线,转变为可在同一模型中分工组合的设计选项。
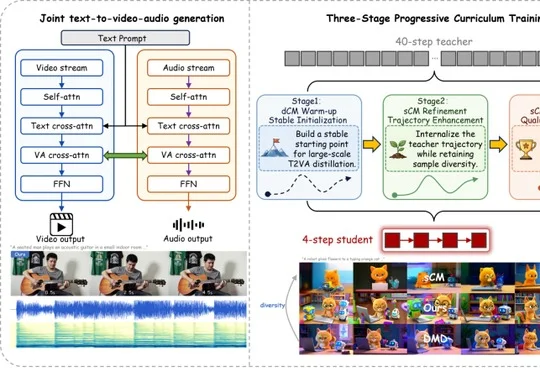
浙江大学、清华大学与新加坡国立大学团队推出TurboT2VA,采用分布蒸馏与轨迹蒸馏联合方案将音视频生成速度提升54.67倍,在单张H20上将1024×1792分辨率121帧的生成耗时从318.74秒降至5.83秒。