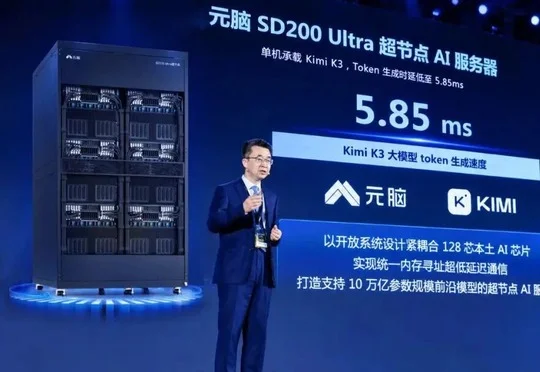
硅谷扔出“巨内核”,中国团队祭出“超级算子”,万亿参数模型效率战打响!
硅谷扔出“巨内核”,中国团队祭出“超级算子”,万亿参数模型效率战打响!浪潮信息在AICC 2026发布搭载128芯本土AI芯片的元脑SD200 Ultra超节点AI服务器,通过超级算子融合技术将2.8万亿参数Kimi K3的Token生成时延降至5.85毫秒,与海外Inferact以"巨内核"路线共同打响万亿参数模型推理效率战。
来自主题: AI资讯
9077 点击 2026-10-01 13:15

 搜索
浪潮信息在AICC 2026发布搭载128芯本土AI芯片的元脑SD200 Ultra超节点AI服务器,通过超级算子融合技术将2.8万亿参数Kimi K3的Token生成时延降至5.85毫秒,与海外Inferact以"巨内核"路线共同打响万亿参数模型推理效率战。
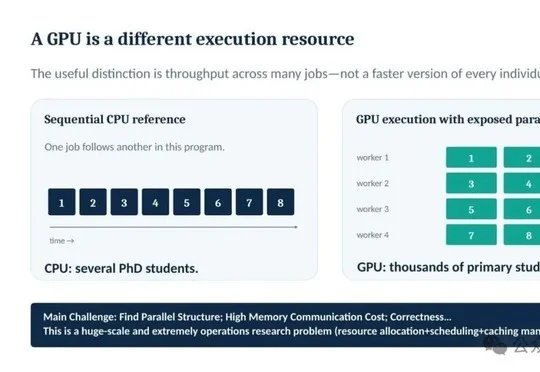
港科大团队在NeurIPS 2026上提出AccelEval基准,覆盖6个领域42项任务和43类CUDA优化策略,评测大模型能否从可信CPU程序生成端到端更快的GPU实现,其中Gemini 3.1 Pro在中规模通过正确性验证的任务上取得71.2倍几何平均加速比。
MiniMax于9月27日上线Flash级别模型M3.1-Flash-Preview,本文通过试衣间项目改造、机器人视频拆解、北京夜光可视化和A股市场观测台四个实测任务,将其与DeepSeek V4.1 Flash和GLM-5.3-Flash对比,结果显示M3.1速度仅次于DeepSeek但成本最低,成为Flash赛道上DeepSeek的新对手。
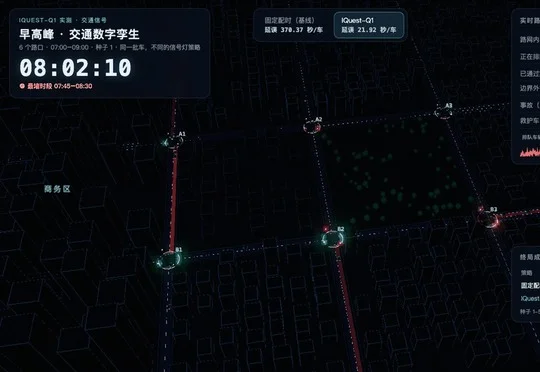
至知创新研究院开源320B大模型IQuest-Q1,该模型在代码生成、安全漏洞挖掘等评测中表现优异,并能自主排查训练Bug,在交通调度、仓库管理、电梯调度等真实场景中展现出强大的任务解决能力。
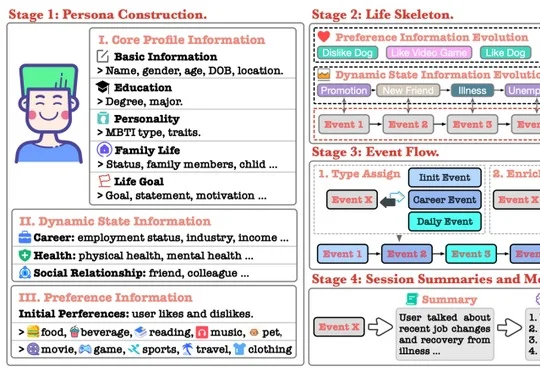
中国电信研究院与MemTensor等机构提出首个面向智能体记忆系统的操作级幻觉评测基准HaluMem,已被EMNLP 2026主会接收,该基准分别对记忆提取、更新和问答三个环节进行检查,并对Mem0、MemOS等六套系统实测,发现高召回率可能伴随虚假信息写入、低更新幻觉率背后存在大量遗漏、上游记忆问题最终会影响回答等核心现象。
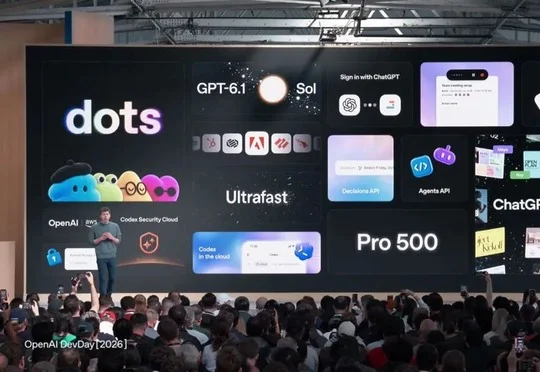
OpenAI在第四届DevDay开发者大会上发布25项更新,包括Dots个人agent、ChatGPT Space协作空间、GPT-6.1 Sol模型、Ultrafast极速档及Codex全面上云等,涵盖模型、搭建工具与分发三大板块。
Google面向符合条件的大学生推出免费领取一整年Google AI Pro或Google AI Plus的学生活动,美国学生可获原价约240美元的Pro方案,140多个国家和地区学生可获原价约60美元的Plus方案,活动通过gemini.google/students官方页面领取,有效期至2026年12月31日。
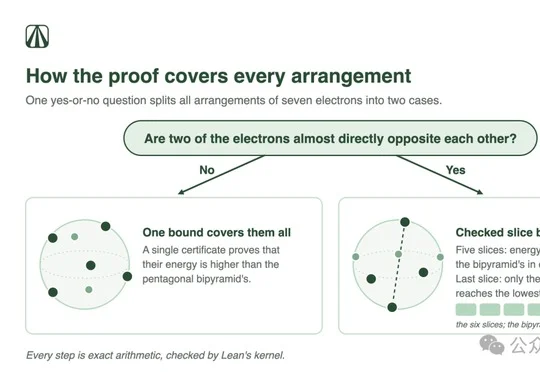
10个Claude Sonnet 5.5智能体通宵15小时、互发1270条消息并写出17895行Lean代码,在无人类介入的情况下完成悬置122年的汤姆逊问题N=7形式化证明,且通过Lean内核与nanoda双重验证。
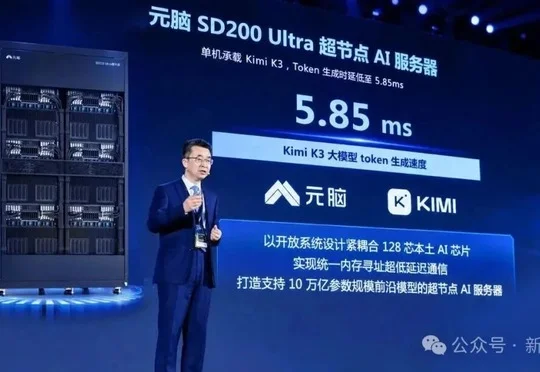
Inferact开源TPU巨型算子与浪潮信息发布元脑SD200 Ultra超节点服务器,两家公司分别用谷歌TPU v7和128颗本土AI芯片,通过算子融合让Kimi K3推理性能提升3倍以上,且浪潮信息让K3自主编写超级算子。
RunningHub基于MiniMax H3开源基座发布增强版H3 RH Enhanced,2000组实测显示其多镜头长时叙事能力显著优于Seedance 2.0,16镜以上角色崩坏率降低超60%,生成成本低至0.1元/秒。