
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
吴恩达:过去常常是我们给Coding Agent做质量检查。现在,它已经能自己完成更多检查。
吴恩达:熟练的AI工程师仍然紧缺。尤其难找的,是能处理那些没有唯一答案的判断任务的人。
吴恩达:懂AI工程的人不只是照着需求写代码,还要参与决定做什么、怎样把它做出来。
最近,在Neo4j的NODES 2026中,联合创始人兼CEO Emil Eifrem作为主持人问吴恩达:过去一年Coding Agent变化这么大,AI工程师到底还需要学什么?
吴恩达给出的答案,并不是再学一款新工具。
他说,团队研究了超过2万份招聘描述,又做了访谈,把AI工程相关工作归成四类:构建和部署AI应用、软件工程基础、使用Coding Agent,以及参与决定产品要做什么。
这张能力地图也不是只给职位名称叫“AI工程师”的人,软件开发者、数据科学家和运维工程师同样会碰到其中的工作。
问题在于,Agent已经能写代码、跑一部分检查,却不能替一个团队回答所有没有标准答案的问题。

吴恩达回顾Coding Agent开始自行完成更多质量检查
以下根据原访谈翻译整理。
吴恩达认为,模型在容易验证结果的任务上进步很快。代码能编译、测试能通过,数学题有答案;Coding Agent因此能把“写完—检查—修正”的循环往前推进。可在企业里,许多决定无法靠一个测试判定对错。
吴恩达:AI很擅长结果可以验证的任务,比如编程和数学。需要判断的问题通常有多个好答案,也有多个不太好的答案;我们很难为它们建出同样清楚的奖励和测试环境。
吴恩达把AI工程师的短缺与这类工作联系起来:Coding Agent提高了开发速度,团队仍需要人判断需求、数据和结果是否符合业务。“短缺”是他在访谈中的观察,不是那2万份招聘描述得出的岗位缺口统计。
吴恩达谈Coding Agent提高效率后,熟练AI工程师仍然紧缺
吴恩达说,团队研究了超过2万份招聘描述,并结合访谈和调查,才把相关任务整理成四组。它们不是四道独立的考试,而是一个应用从想法走到上线会反复用到的能力。
吴恩达:四组工作分别是构建和部署AI应用、软件工程基础、使用Coding Agent,以及参与决定要构建什么。擅长AI工程的人不只是按规格实现,也会参与推动开发过程。
构建和部署AI应用,是把一个能演示的原型变成能持续运行的产品。模型要接入工具和数据,出错时要能被发现,运行情况也要有人跟踪。
软件工程基础决定这个产品能不能稳定地用下去。开发者仍要理解系统架构、接口、测试和安全;这些问题不会因为代码由Agent生成就消失。
使用Coding Agent,也不只是让它多写代码。开发者要交代清楚目标和上下文,看懂它做了哪些改动,并检查结果是否符合要求。
参与决定要构建什么,则发生在动手之前,也贯穿开发过程:用户的问题是什么,哪些需求值得做,AI应该做到哪一步。这些判断若没想清楚,开发速度再快,也可能只是更快地做出一个没人需要的东西。
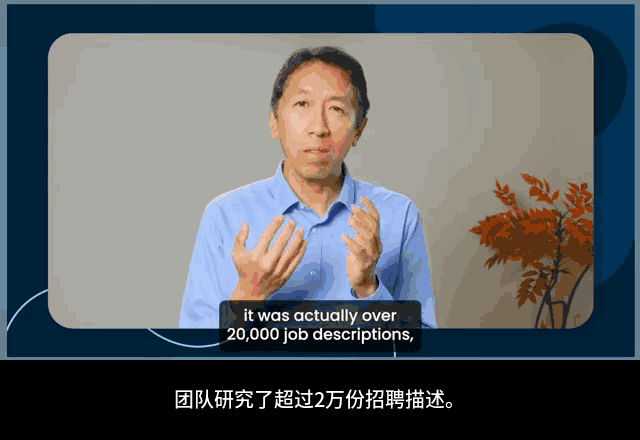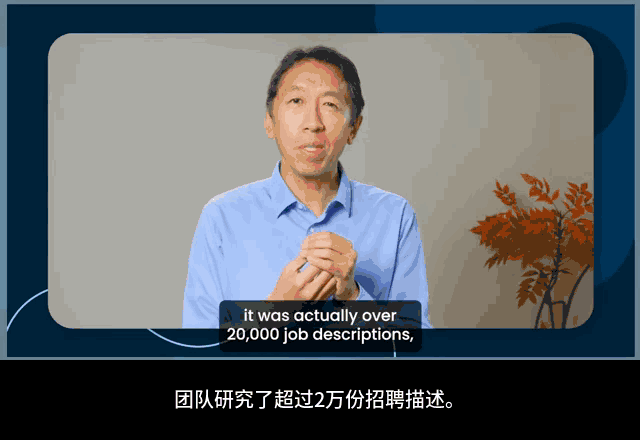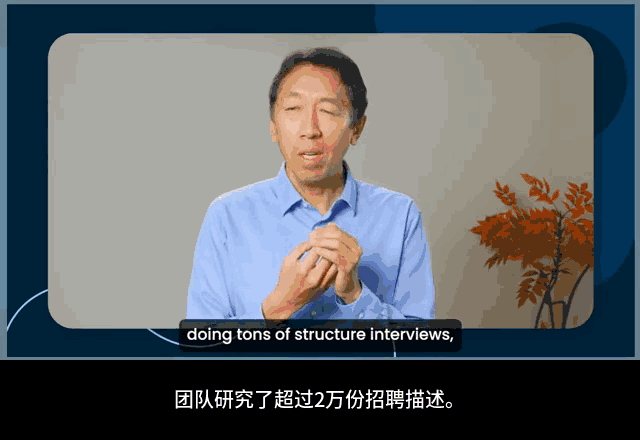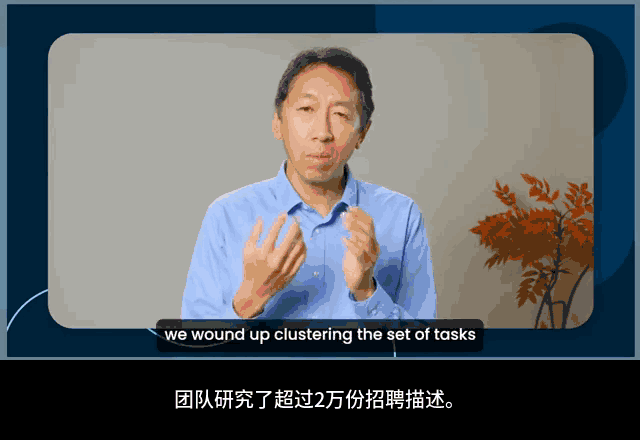
吴恩达介绍团队查看超过2万份招聘描述后整理AI工程能力
主持人问了一个问题:既然Agent会写代码,开发者为什么还要学计算机基础?吴恩达的回答落在“取舍”上。
吴恩达:不了解基础却让Coding Agent写程序,有时等于让它替你在成本、延迟、可靠性和安全之间作选择;你甚至不知道这里存在一个选择。
Agent写出的代码能运行,测试也通过了,方案却可能不适合上线。缓存时间设得太长,用户可能看到旧数据;接口权限放得太宽,可能暴露不该访问的信息;并发处理不当,同一操作可能执行两次。开发者得理解这些问题,才能看出Agent做了哪些取舍,判断哪里需要改。
吴恩达也没要求开发者把所有旧知识背下来。
他说,自己越来越少手写某些语法,Coding Agent处理这部分工作很方便。差别在于:面对要求不高的一页小工具,Agent随手选个可用方案也许足够;面对权限、可靠性要求更高的企业应用,开发者若看不懂底层选择,就很难把它引向合适的实现。
吴恩达解释不理解基础时,开发者可能看不见Agent作出的工程取舍
对谈后半段,主持人问到“本体”。
这个词听着抽象,简单说,它是给业务概念和它们之间的关系定一套清楚的说法:系统里的“客户”指个人还是公司?订单和合同怎样关联?不同系统里同名的“状态”,含义是否一样?
这些问题不说清,Agent即使读到了数据,也可能把字段理解错、把不该关联的信息连在一起。
吴恩达认为,人手里有大量模型没有拿到的背景。他举了一个细节:和客户聊天时,对方听到某项功能露出的表情,可能让你知道这项功能究竟受不受欢迎。类似信息不一定进入需求文档,却会影响产品和数据如何组织。
吴恩达:做应用的人掌握了大量上下文,Coding Agent并没有。我们知道自己的业务、数据从哪里来、哪些数据好用,甚至会忘记把这些告诉它。
吴恩达谈开发者拥有模型未必能取得的业务背景
他并不反对让AI帮忙建立业务概念和关系;他的团队自己也在研究这件事。但按他的观察,完全自动生成目前不如有人参与引导。他做数据科学项目时,见过AI从底层数据一路推导,最后对数据作出明显错误的假设;直到把上层概念纠正后,结果才开始像样。
吴恩达:自动整理这些关系是值得继续研究的方向,但目前有人参与、引导Agent建立结构,效果仍然更好。AI有时会对数据作出实质性错误的假设。
吴恩达谈AI自动整理业务关系时可能误解数据
主持人把企业内部的人、项目、数据、业务规则之间的联系称作一种“企业世界模型”。
吴恩达接着谈到大型企业经常提出的要求:原来供人和数据分析师使用的数据架构,要怎样改到Agent能用?
吴恩达:让企业数据变得适合Agent使用,涉及权限、治理、安全,也涉及整个组织的数据架构。图数据、结构化和非结构化数据,以及业务交易系统的数据,往往需要放在一起考虑。
吴恩达谈企业把现有数据架构调整为Agent可用时,需要考虑权限、治理与多种数据形态
他也不认为解决办法是让一家供应商拿走企业全部数据。大型组织的订单、合同、客服记录分散在不同系统里,访问权限各不相同;与其说“全倒进一个库”,不如先弄清每份数据从哪里来、谁能用、出错时如何回查。
吴恩达:每家数据厂商都想说“把所有数据交给我,我来清理”,可大企业不会把全部数据交给一家厂商。需要想清楚不同的数据架构怎样组合起来。
吴恩达谈企业数据不可能全部交由一家供应商整理
吴恩达提到,他接触的一些企业项目,大量时间耗在清理和接通数据上。数据底座逐渐理顺后,后面的项目才有机会做得更快。这是他的项目经验,不是对所有企业都成立的效率测量。
回到那位要查订单、判断退款的客服Agent。代码能写、测试能跑,只说明一部分工作完成了。上线前,团队仍得确认退款规则由谁定义、订单状态以哪个系统为准、Agent能看哪些客户信息、什么情形必须转给人工。出错时,还要能找到它依据了哪份数据。
吴恩达列出的四组能力,放到这样一个项目里才有分量:有人用Agent推进开发,有人看懂工程取舍,有人把AI应用接入真实服务,也有人决定它究竟被允许替用户做什么。AI工程师的工作并没有随着代码生成提速而消失;难度转移到了这些需要一起说清、一起验收的地方。
参考链接:
https://www.youtube.com/watch?v=Q9SFGkVO8mo
文章来自于“51CTO技术栈”,作者“姜篇”。

【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
