
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
“全栈自主可控大模型是AI安全性和极致性价比的必然选择。”
智东西10月22日报道,今日,科大讯飞发布数个大模型及AI应用新成果,包括端云一体大模型讯飞星火X2.6、语音基座模型SparkAudio 1.0、WinWork数字员工平台、超级AI教师助手讯飞星光等。
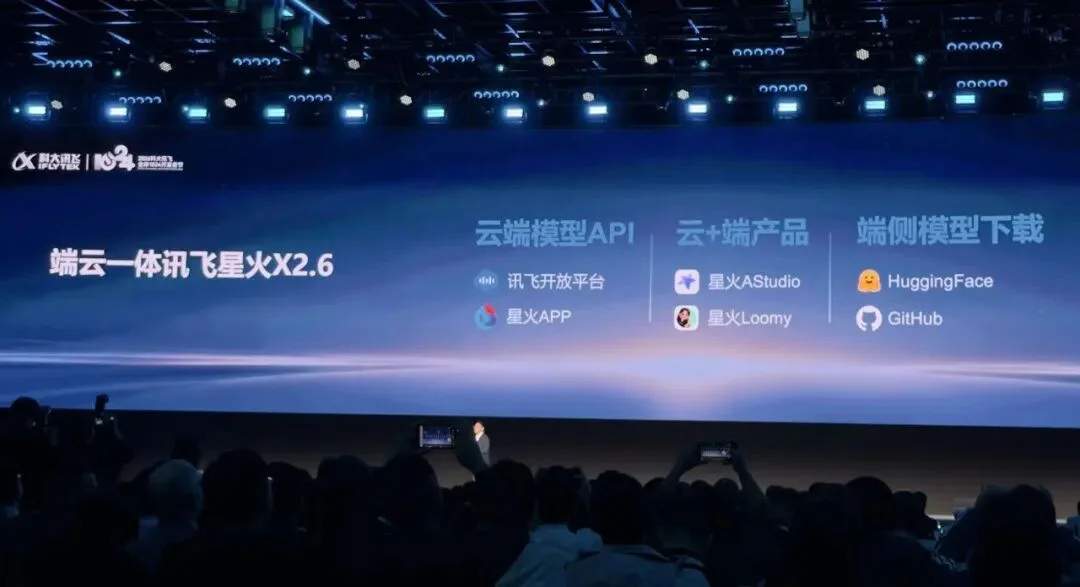
其端云一体讯飞星火X2.6基座模型基于全国产算力完成能力升级,包含云端的293-A30B模型及端侧的X2.6-4B模型,后一模型已开源。
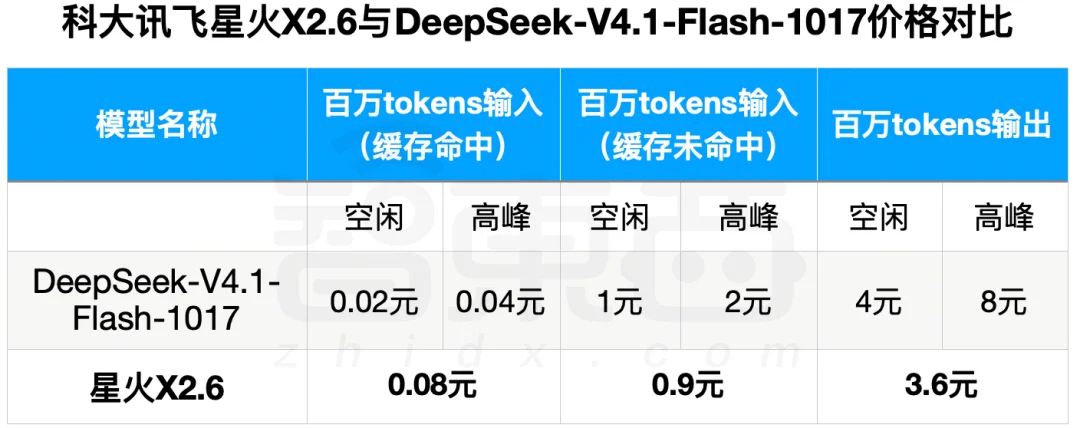
云端模型293-A30B支持百万token上下文,输入价格为0.9元/百万tokens,输入缓存命中价格为0.08元/百万tokens,输出价格为3.6元/百万tokens。输入缓存未命中、输出价格比DeepSeek-V4.1-Flash-1017更低。
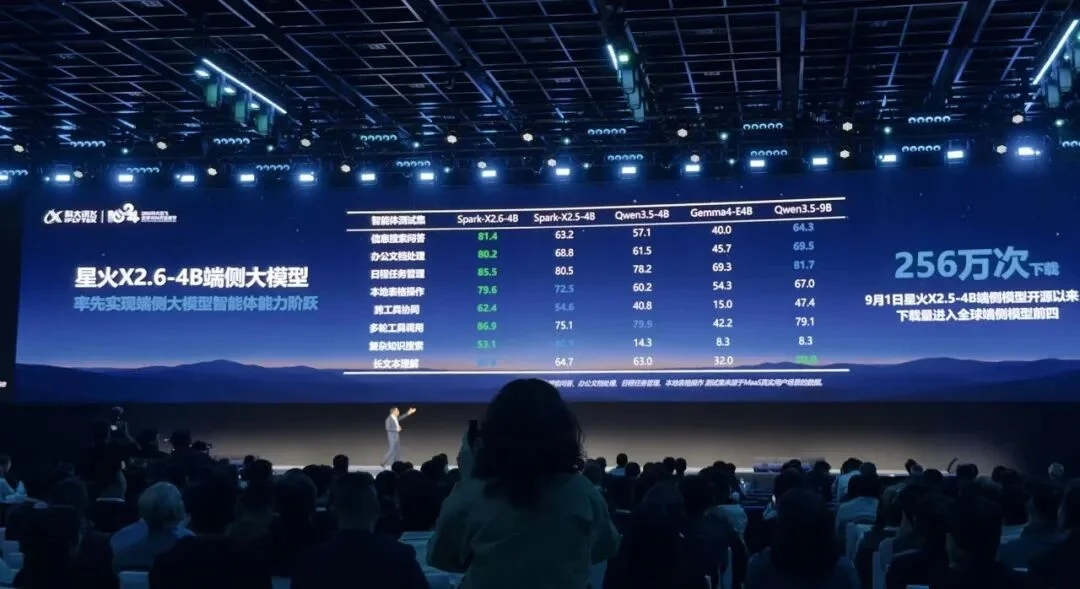
根据科大讯飞公布的测试结果,星火X2.6-4B模型在信息搜索问答、办公文档处理、日程任务管理、本地表格操作、跨工具协同、多轮工具调用、复杂知识搜索上均超越了其上一代Spark-X2.5-4B以及Qwen3.5-4B、Gemma4-E4B、Qwen3.5-9B模型。
此外科大讯飞还集中亮相了数个AI硬件,如讯飞AI录音环、讯飞AI眼镜、讯飞AI PC系列等产品。其中灵机N9000 AIPC笔记本最高具备160 TOPS本地AI算力;星火办公一体机提供2240 TOPS AI算力,支持大模型私有化部署。
目前,科大讯飞的产品矩阵已经以讯飞星火基座大模型为底座,在教育、医疗、教育、法律、汽车、机器人等领域实现应用。
科大讯飞创始人、董事长刘庆峰称,今天的AI正成为人类历史上有史以来最具颠覆性的技术革命和产业革命,没有之一。
他认为,全栈自主可控大模型是AI安全性和极致性价比的必然选择,这就需要全栈自主可控的端云一体大模型来解决。未来会有60%的任务在本地跑,30%的任务通过云端协同处理,10%的任务在云端独立处理,这也是科大讯飞此次推出端云一体大模型X2.6的关键原因。
X2.6-4B模型开源地址:
https://huggingface.co/collections/abenzerps/spark-x26
基于全国产算力训练
首发端云一体大模型
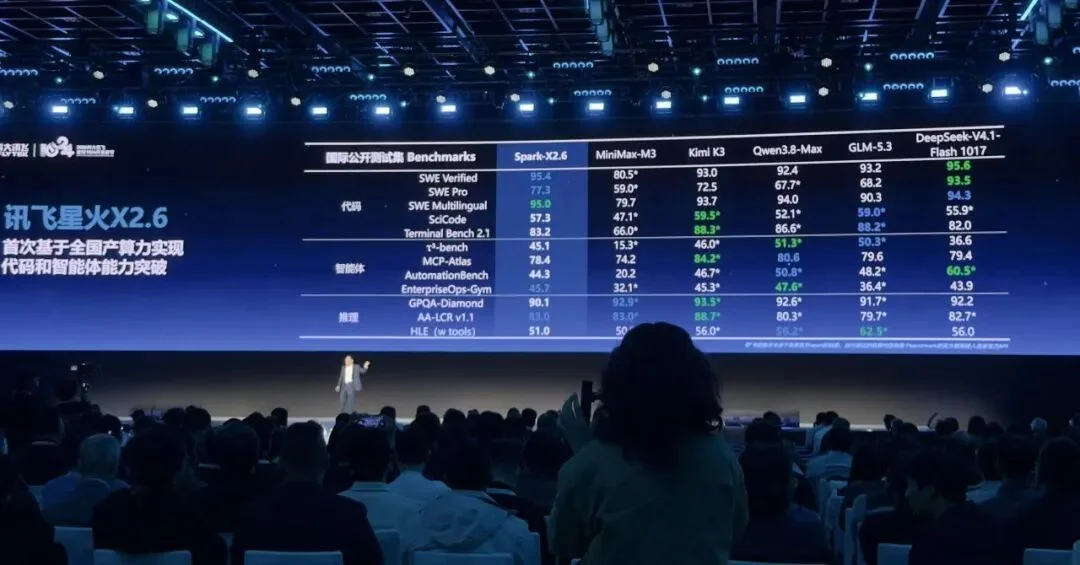
在科大讯飞公开的基准测试结果中,代码能力方面,星火X2.6在SWE Pro、SWE Multilingual两项测试集中拿下第一,SWE Verified测试集中仅次于DeepSeek-V4.1-Flash 1017;智能体赛道上,其在企业运维类Agent和通用工具调用MCP-Atlas中,都处于第一梯队;在推理能力方面,星火X2.6在AA-LCR v1.1测试集中与MiniMax M3持平。
在训练侧,该模型突破了国产芯片长程任务训练瓶颈,以国产超大规模智算平台飞星二号万卡训练2000B 256K长度数据时间为例,训练时间由4.5个月缩短至1.2个月,超长上下文训练效率提升至原来的4倍。刘庆峰称,星火X2.6就是在过去2-3个月训练出来的。
推理层面,科大讯飞基于国产异构算力的分布式推理技术、首个全国产硬件的四层KV Cache架构,攻克了长上下文场景下容量不足、推理时延高、缓存命中率低等难题,飞星二号国产芯片推理效率达到优化前的4.5倍,KV Cache命中率由63%提升至95.7%。
在端侧模型方面,科大讯飞打造了星火X2.6-4B模型。刘庆峰称,这是因为4B大小是非常适合在机器人、汽车平台、AI PC上部署使用的。其上一代星火X2.5-4B端侧模型从9月1日开源至今,下载量达到256万次,位列全球端侧模型前四。
为提升端侧模型能力,科大讯飞采用了端云一体训练技术。星火采用端侧模型能力感知的自适应迭代后训练算法,根据端侧能力动态选择教师模型、调整训练比重。
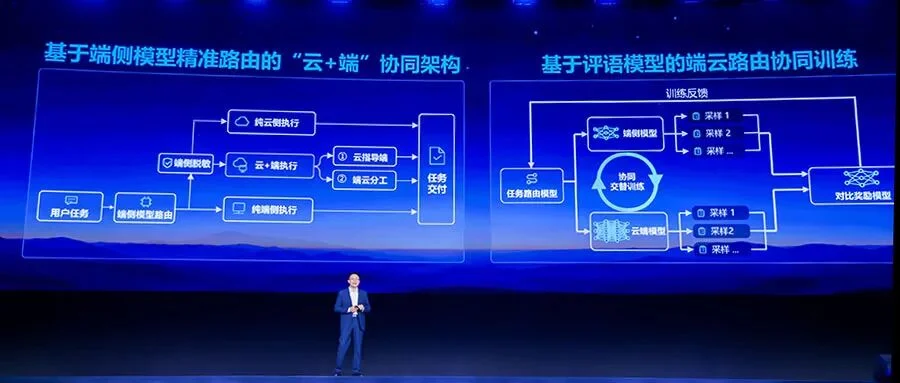
基于端侧模型精准路由的“云+端”协同架构,先由端侧模型判断任务交给哪种方式完成:纯端办、纯云办、还是由端云协办。这之中的一个关键问题就是端云路由是否准确,科大讯飞引入基于评语模型的端云路由协同训练机制,将端云路由准确率由81.2%提升至96.1%。
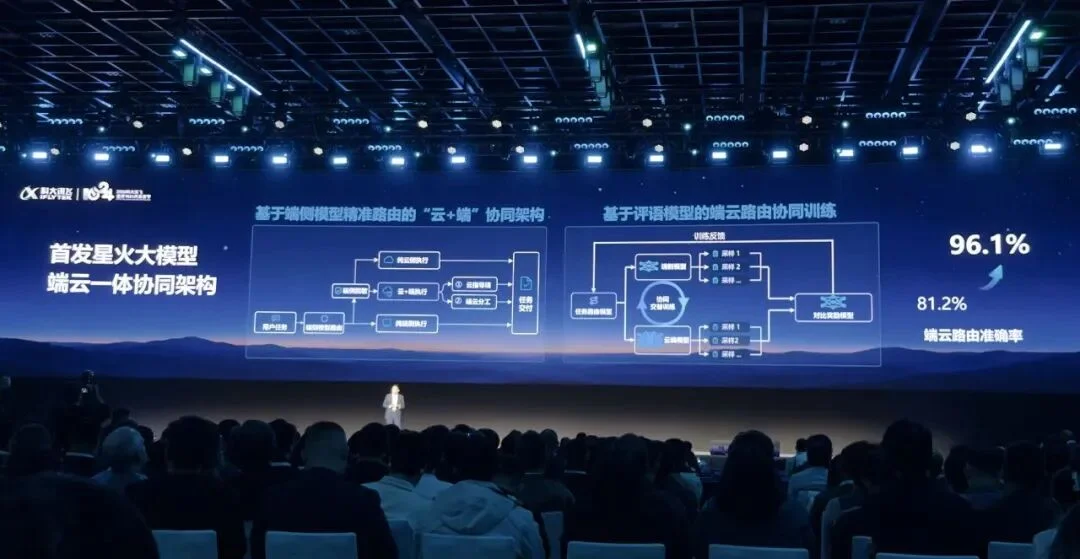
在端云一体的星火X2.6模型之上,科大讯飞推出了两款产品:星火Loomy面向日常办公,帮助用户写报告、做PPT、分析数据,让日常工作轻松完成;星火AStudio面向专业办公,帮助用户写代码、搞研究,让复杂工作自主推进。
现场演示人员扮演一个创业公司的总经理,让星火AStudio可以在不联网的情况下,帮用户查看最近各大区的周报、邮件,然后分析经营情况并进行整理。模型在检索内容后,会生成可视化表格、三项待办事项、风险等,还会提供相应的对应邮件链接。
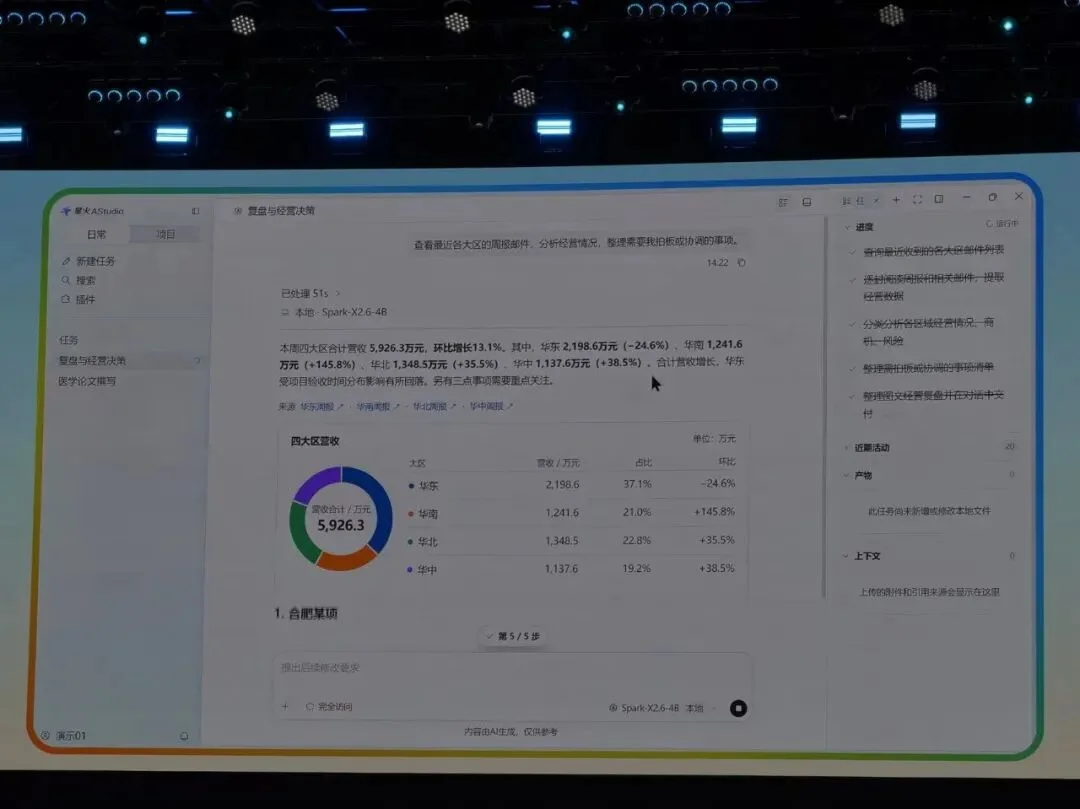
在和云端模型协作的任务中,模型会先对本地数据进行梳理,有需要云端协作任务时,再发起协作申请。在这之前,本地模型会对数据进行脱敏处理。云端处理完后,本地模型会将之前的脱敏信息在此处理,生成完整的内容。
语音基座大模型能分析复杂音频
讯飞AI录音环一点就能随时录音、整理
在让AI从数字世界进入物理世界方面,科大讯飞发布了星火语音基座大模型SparkAudio 1.0以及新款AI硬件讯飞AI录音环等。
星火语音基座大模型SparkAudio 1.0,基于全国产算力训练。现场SparkAudio 1.0分析出了一段复杂音频中的背景音乐、男性声音、机械运转声、自行车铃声等诸多声音。
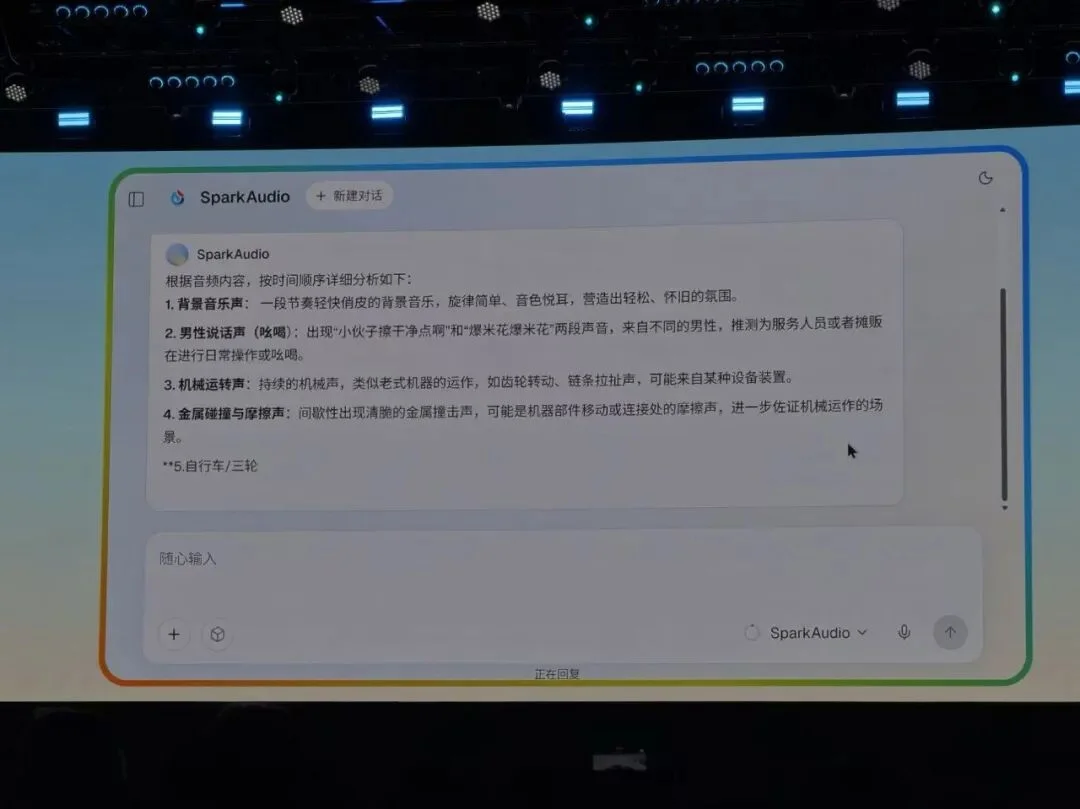
这一模型背后有三项技术创新,分别为半监督音频编码器带来20%的效果提升,动态分段端到端建模使响应时间降低15%,双范式协同解码使成本降低60%。
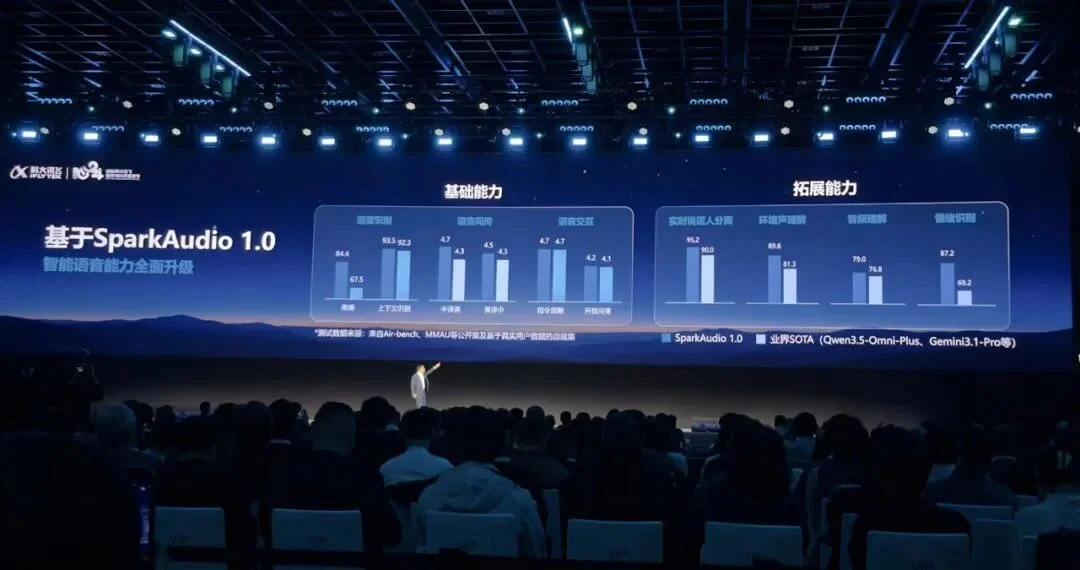
该模型已经在讯飞输入法16.0、讯飞听见、讯飞智能办公本、讯飞翻译机等产品中上线。其中,讯飞智能办公本升级后,支持手写标注说话人姓名,后续发言自动对应;抢话、多人交叠发言时也能区分说话人;识别中英混合、专业术语。
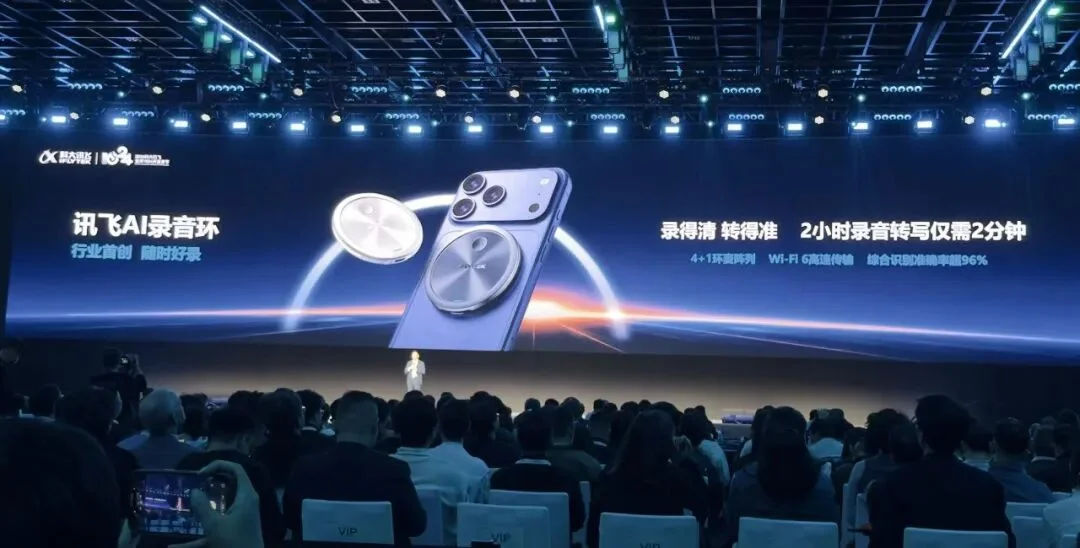
科大讯飞还展示了一款新AI硬件讯飞AI录音环,重量为35g,贴合手机磁吸设计。用户只需点击录音环上的录音按钮,就是随时随地记录。录音结束后,其会通过WiFi 6高速传输,2小时录音约10秒传至手机、2分钟转成文字,还能智能区分说话人、生成AI会议纪要、提炼重点及待办事项,并支持多语种同声转译。
该设备目前已在电商平台开售,售价1299元。
在多模态交互方面,科大讯飞主要提升了座舱、眼镜等智能终端理解需求的能力。
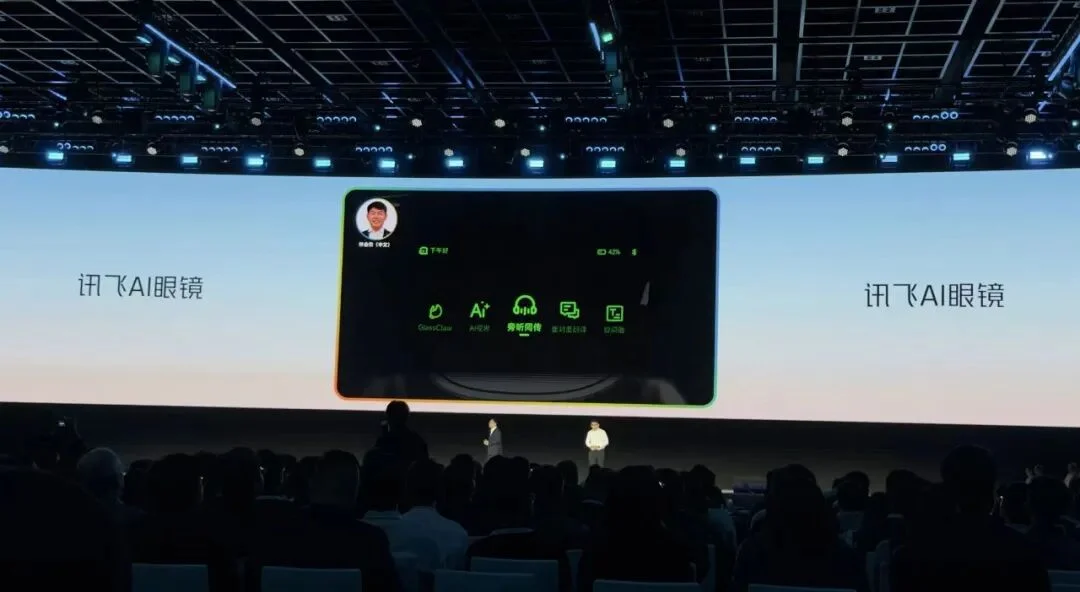
讯飞AI眼镜具备显示能力,重量为40g,支持90dB展会噪声抑制,8米远距拾音。这一设备能翻译120+语种,可以连接PC与云端智能体,支持远程指挥电脑端办公工作。该设备售价为4299元起。
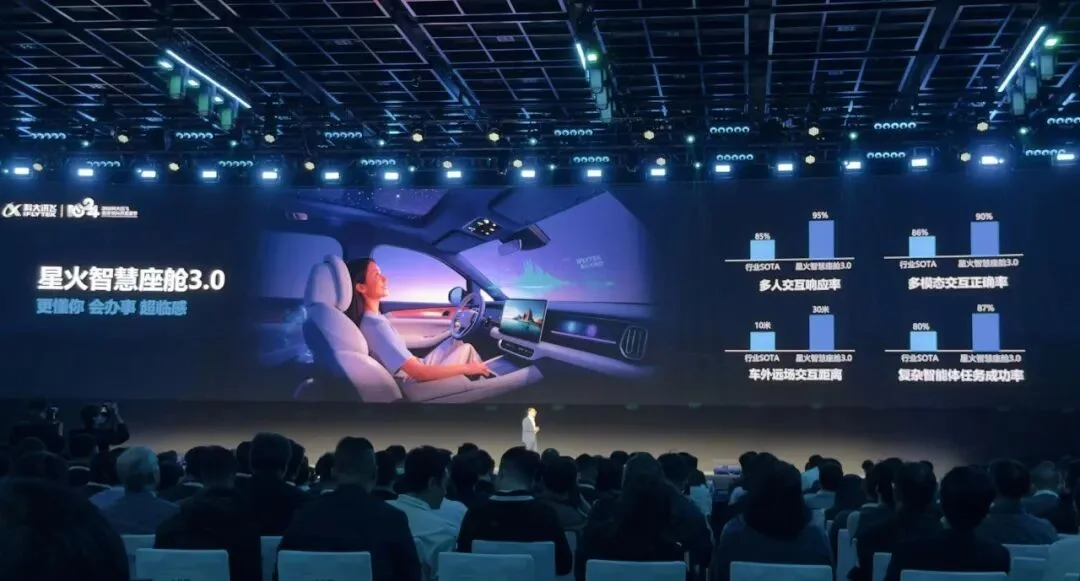
讯飞星火智慧座舱SparkAuto Space 3.0的多人交互响应率、多么题啊交互正确率、车外远场交互距离、复杂智能体任务成功率等都大幅提升。
机器人的具身多模态交互会面临开放空间机器人移动降噪识别、多人交互声源及视觉时空对齐、多模态交互及动作联动协同等难题。
基于此,科大讯飞发布了机器人超脑平台V3.0,能实现复杂空间的动态降噪、多目标人的交互意图识别、语音与动作统一的规划与执行、视觉触发的主动交互。
在“7×24小时”AI无人超市场景中,机器人可以结合语音、视觉与位置信息,识别不同顾客的需求,在多人插话或者用户需求反复变化时,也能完成取货、递送与扫码结账等任务。
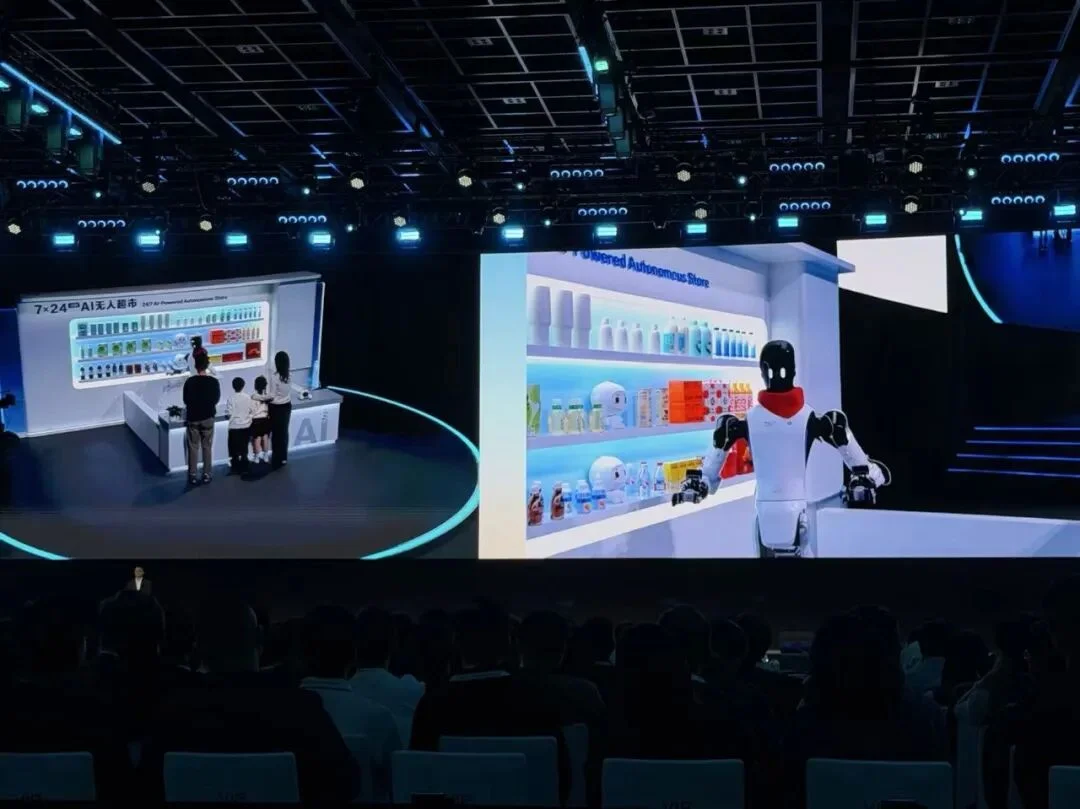
机器人超脑平台V3.0将向开发者开放,包括星火超脑板、多模态交互模组、具身智能开发套件及具身多模交互Harness。
在为组织提效方面,AI要完成从个人提效到组织提效的跨越,核心在于读懂业务、嵌入业务流程,实现人、数字员工协同作业。
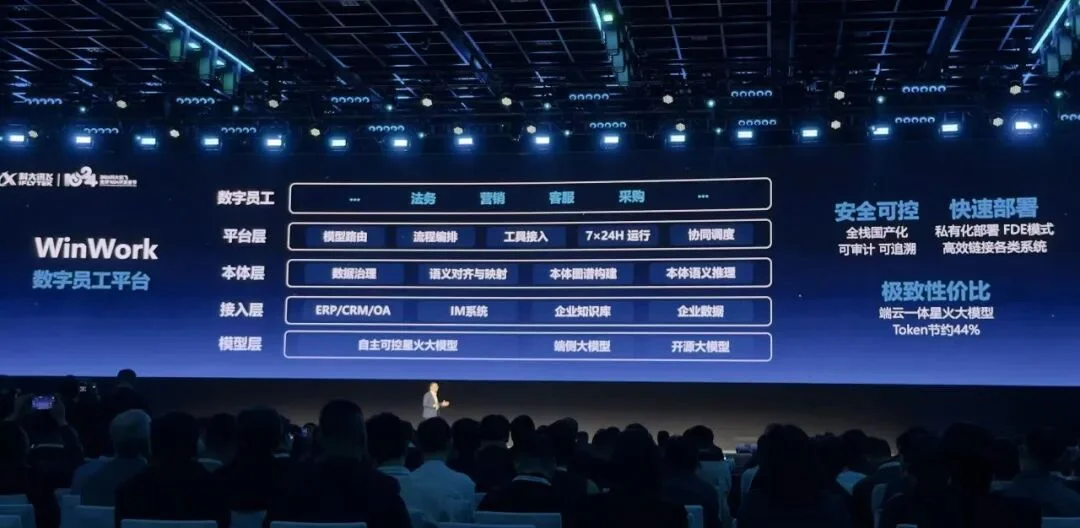
讯飞推出讯飞星帆WinWork平台。该平台可以通过搭建企业业务本体的方式,沉淀企业的业务规程、业务数据与专家知识库,让数字员工更理解业务;WinWork还能嵌入企业业务流程,支撑数字员工参与完整工作闭环,从自主识别任务、拆解规划、智能分发,到联动各类业务系统执行。
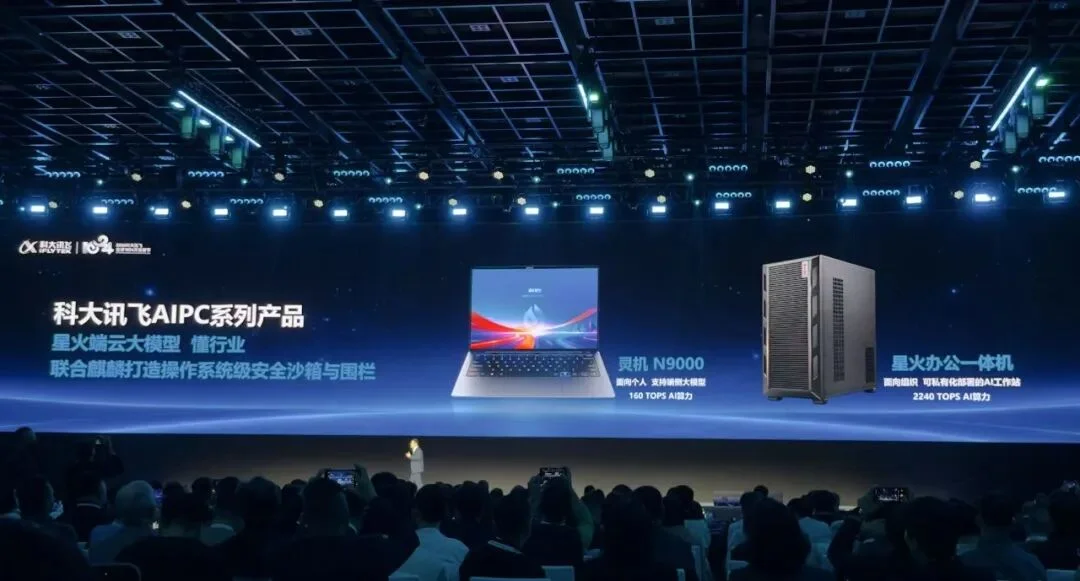
此外,科大讯飞还推出了基于星火端云大模型、国产操作系统的讯飞AI PC系列产品。其中灵机N9000 AIPC笔记本最高具备160 TOPS本地AI算力;星火办公一体机提供2240 TOPS AI算力,支持大模型私有化部署。
给老师、学生、律师
医生、患者都配上AI助手
在教育领域,讯飞发布了一款面向老师的超级AI助手讯飞星光。
讯飞星光将备课、教研、家校沟通和事务助理整合到同一工作台,支持教案、动画、情景视频创编、多角色模拟圆桌研讨、规范填报、统计分析与可视化呈现,对内打通智学网,校信等内部通道,对外打通企业微信、QQ、飞书、钉钉等多平台远控通道。
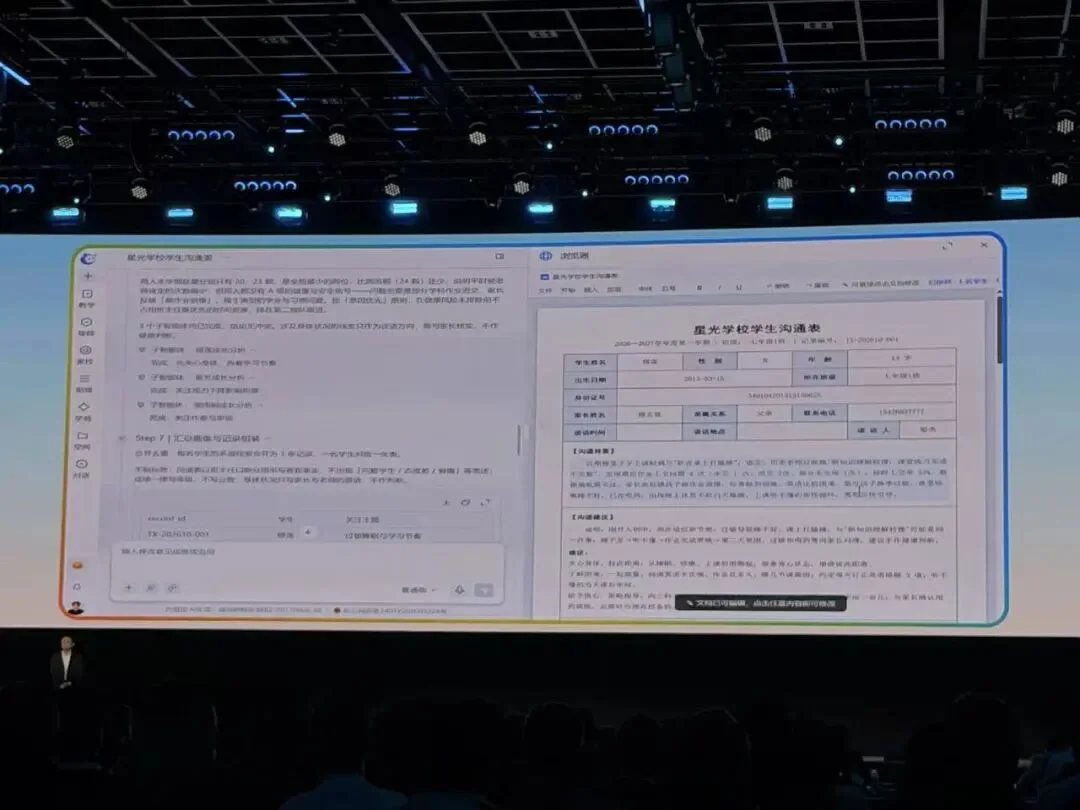
▲帮老师填写家校沟通表
在备课场景中,为了让学生理解电流方向与磁极方向的关系,老师向讯飞星光提出需求,系统生成可旋转观察的三维交互资源,还可结合摄像头手势操作,让学生模拟右手螺旋定则。
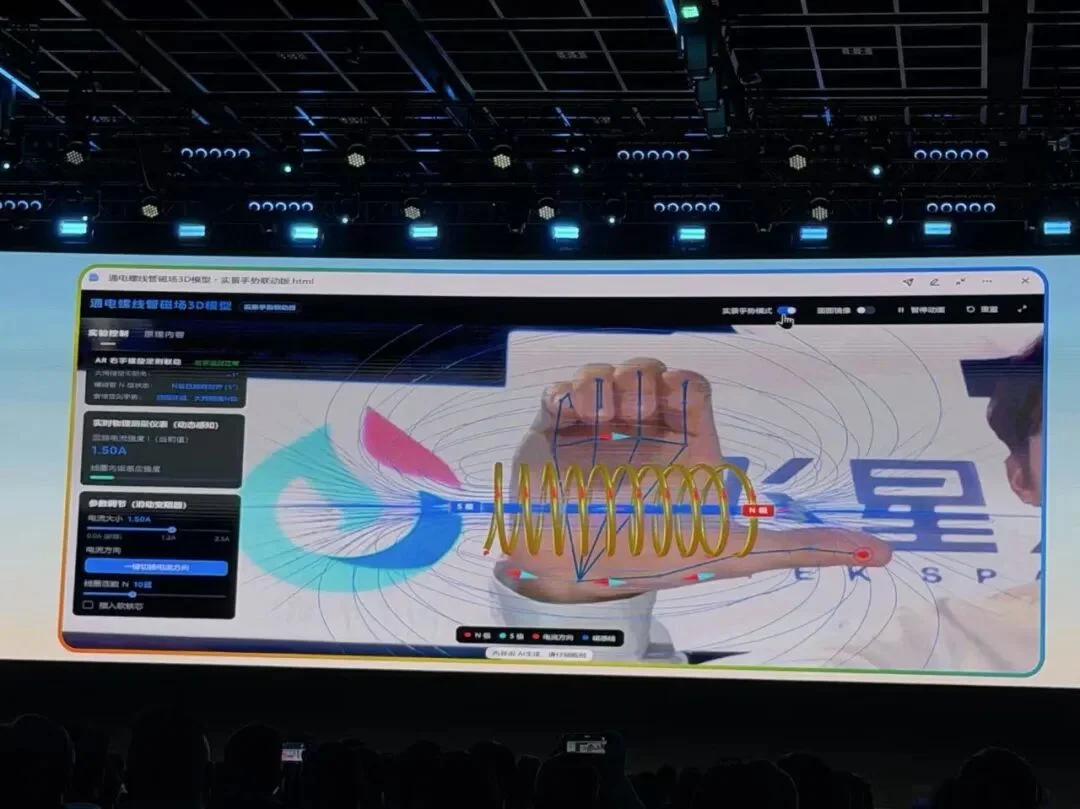
▲可旋转观察的三维交互资源
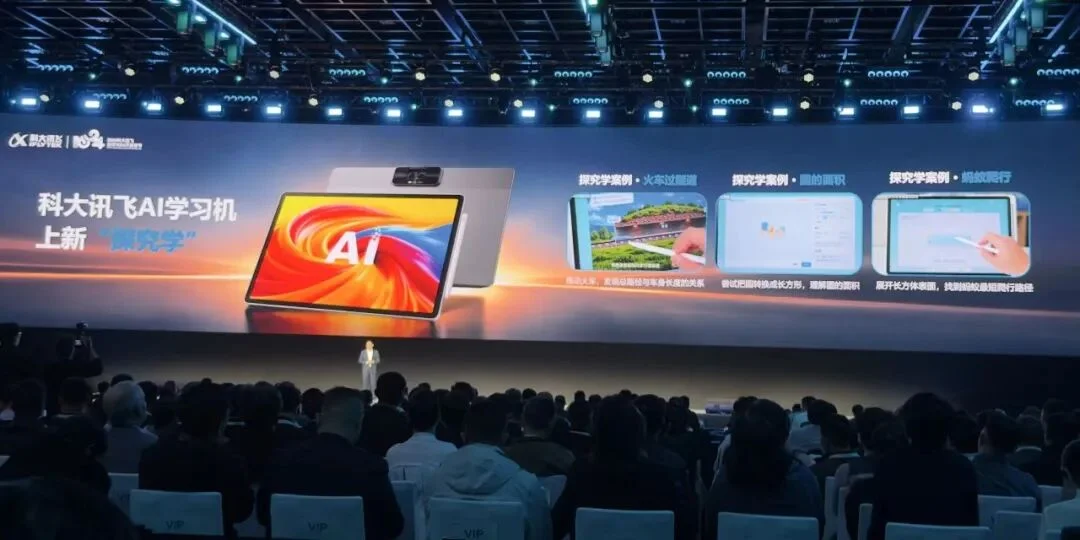
针对学生,科大讯飞AI学习机上线了“探究学”功能。例如蚂蚁爬行最短路径问题,可以通过三维立体观察,展开长方体表面比较不同路线,让孩子先思考、再动手、最后验证。
在医疗领域,讯飞影像云是全球性医学影像AI服务平台,覆盖了全国超过2.6亿人口的区域。医学影像云平台支持影像共享、智能辅诊、质控与报告生成;讯飞晓医是居民身边的AI健康助手,已累计完成AI咨询超过2.2亿次,下载量突破4400万。
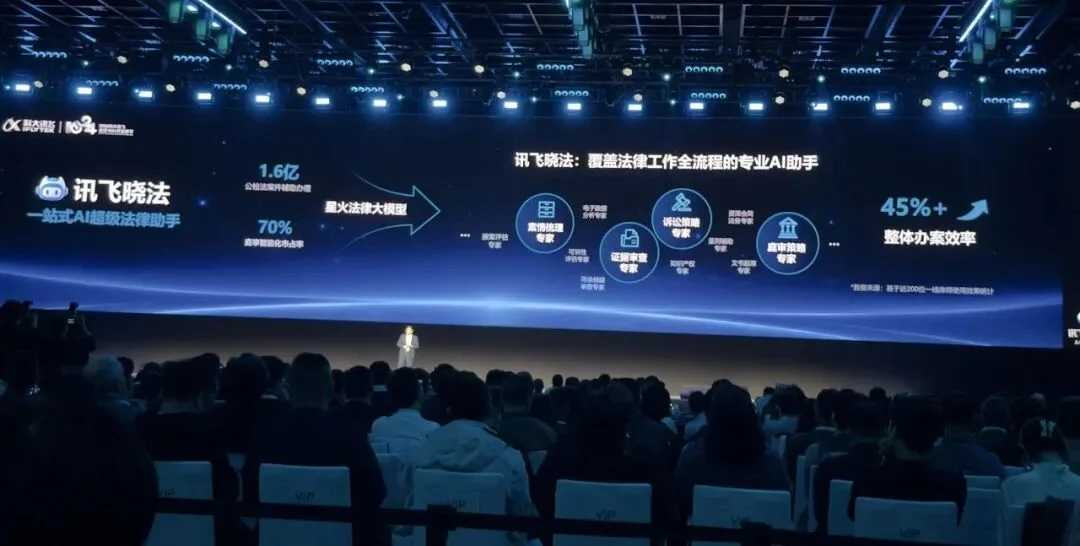
在法律领域,科大讯飞的一站式AI超级法律助手讯飞晓法,覆盖案情梳理、证据审查、诉讼策略、庭审策略和文书起草等任务。
结语:AI落地需精细化调度模型
端云协同是大势所趋
从科大讯飞本次的新模型与系列新品集中发布可以看出,其正基于讯飞星火基座模型,逐步为企业和个人,打造一套直接可交付的商业化AI方案。
其这次首发的端云一体大模型X2.6,核心是对AI任务需求做精细化拆分调度,以此平衡性能、成本、数据安全三者的矛盾,给开发者与企业提供新的落地选择。尤其对教育、医疗、法律这类对数据出境非常敏感的行业来说,这套架构可以契合其私有化、本地部署的需求。
此外,如今大模型行业的竞争,正持续向算力适配、场景落地、数据安全、软硬一体交付等方向延伸,未来只有模型能力、缺少行业闭环与硬件载体的纯底座玩家或被淘汰。
文章来自于微信公众号 “智东西”,作者 “智东西”


【开源免费】Browser-use 是一个用户AI代理直接可以控制浏览器的工具。它能够让AI 自动执行浏览器中的各种任务,如比较价格、添加购物车、回复各种社交媒体等。
项目地址:https://github.com/browser-use/browser-use
【开源免费】AutoGPT是一个允许用户创建和运行智能体的(AI Agents)项目。用户创建的智能体能够自动执行各种任务,从而让AI有步骤的去解决实际问题。
项目地址:https://github.com/Significant-Gravitas/AutoGPT
【开源免费】MetaGPT是一个“软件开发公司”的智能体项目,只需要输入一句话的老板需求,MetaGPT即可输出用户故事 / 竞品分析 / 需求 / 数据结构 / APIs / 文件等软件开发的相关内容。MetaGPT内置了各种AI角色,包括产品经理 / 架构师 / 项目经理 / 工程师,MetaGPT提供了一个精心调配的软件公司研发全过程的SOP。
项目地址:https://github.com/geekan/MetaGPT/blob/main/docs/README_CN.md
【开源免费】FASTGPT是基于LLM的知识库开源项目,提供开箱即用的数据处理、模型调用等能力。整体功能和“Dify”“RAGFlow”项目类似。很多接入微信,飞书的AI项目都基于该项目二次开发。
项目地址:https://github.com/labring/FastGPT
