
# 热门搜索 #
大模型
人工智能
openai
融资
chatGPT
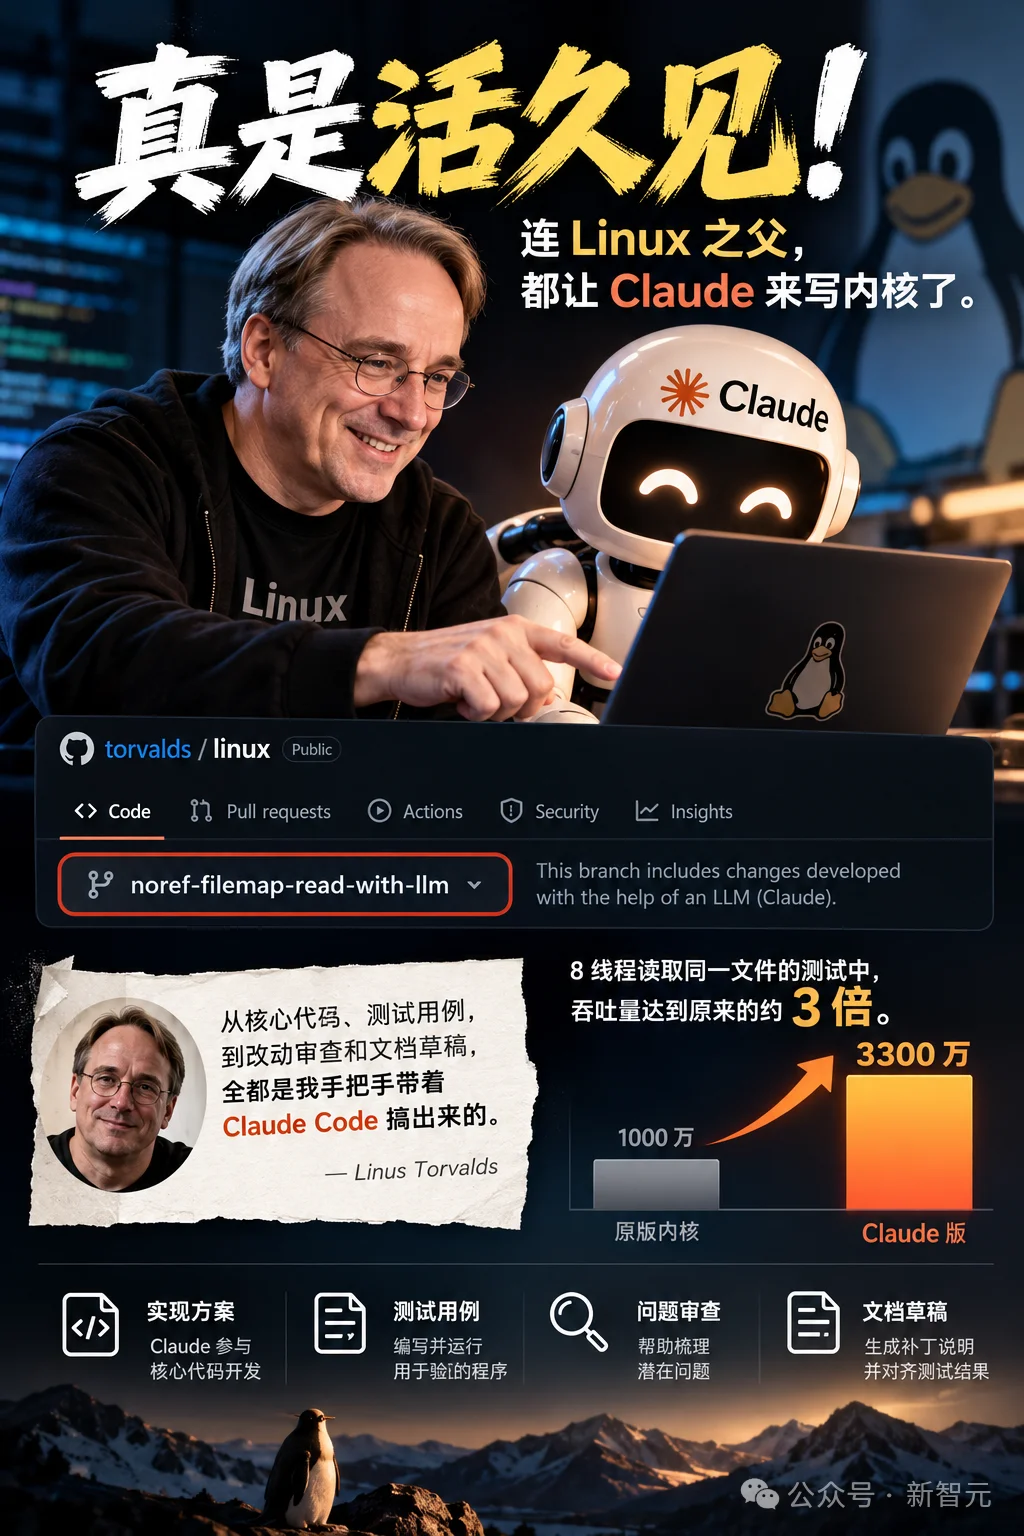
真是活久见!
连Linux之父,都让Claude来写内核了。
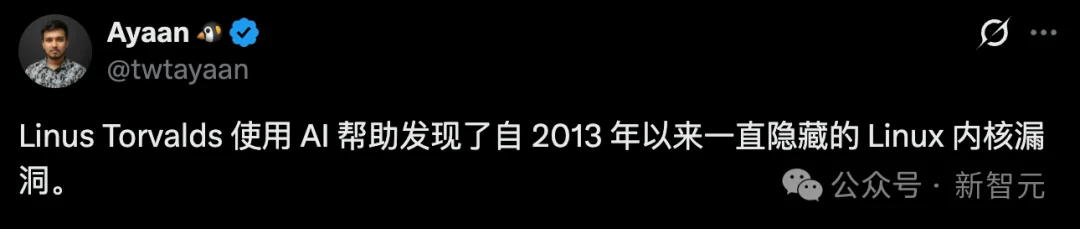
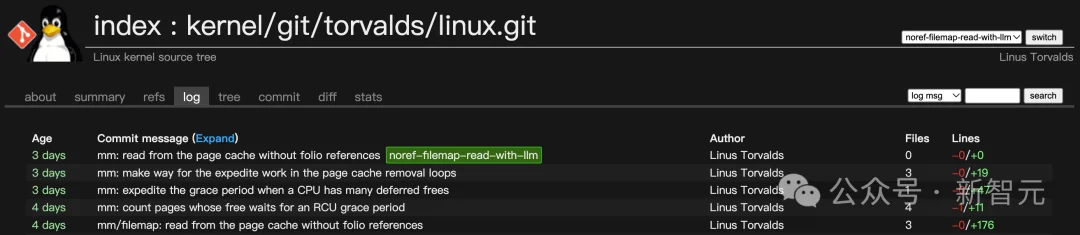
就在最近,一位开发者在刷新Linus的官方内核仓库时,赫然发现了一个极不寻常的新分支——
noref-filemap-read-with-llm
是的,这个分支的后缀「-with-llm」,明明白白地写着:这个项目有AI的参与。
谁敢信,平时喷烂代码骂得最凶的Linus,这回居然自己带头用AI写代码了!
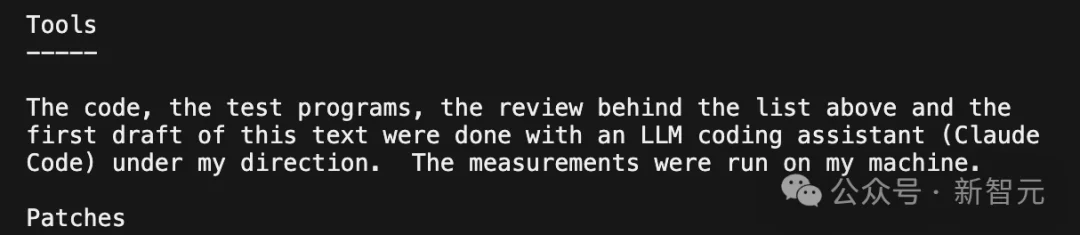
在最新的Patch说明里,他大大方方地承认:
从核心代码、测试用例,到改动审查和文档草稿,全都是自己手把手带着Claude Code搞出来的。
跑出来的结果也确实顶,在8线程读取同一文件的特定测试中,吞吐量达到原来的约3倍。
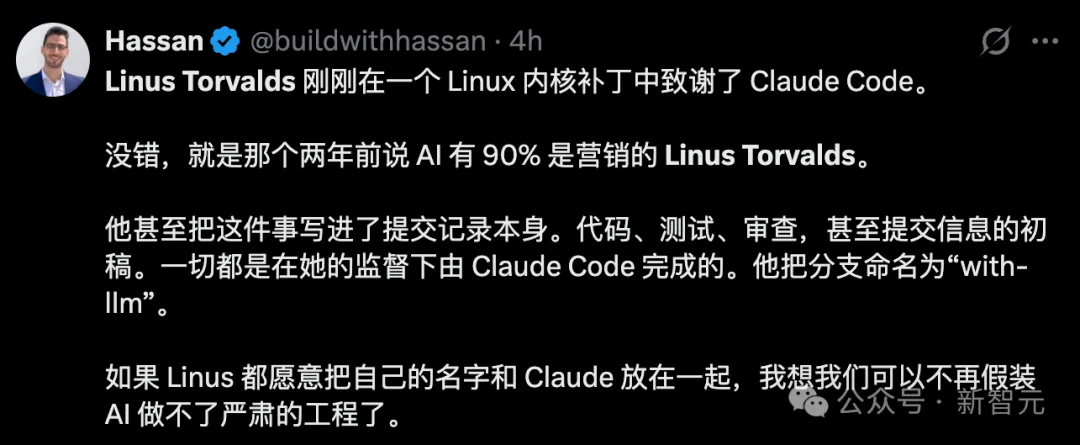
那个说「AI 90%是营销」的人,真香了。
Linus之父这次指挥Claude Code动刀的地方,正是Linux最核心的「内存管理」机制。
Linux内核用page cache缓存文件数据。
在日常多并发业务场景中,一个常见操作是:多个线程同时去小块读取同一个文件。
按现有的机制,每次读取都必须在对应的内存块(folio)上修改原子引用计数。
这就导致CPU核心之间疯狂执行lock cmpxchg和lock decl,在硬件底层引发剧烈的缓存行颠簸。
早在2024年,内核核心开发者Matthew Wilcox就指出了这个来自真实客户生产环境的顽疾。
在Linus自己的测试机上,8线程并发小读时,这个瓶颈占到了所有「Load HITMs」开销的99.92%,几乎吃满了CPU的总线带宽。
而Claude接到的工作,也跨过了「补几行代码」的阶段。
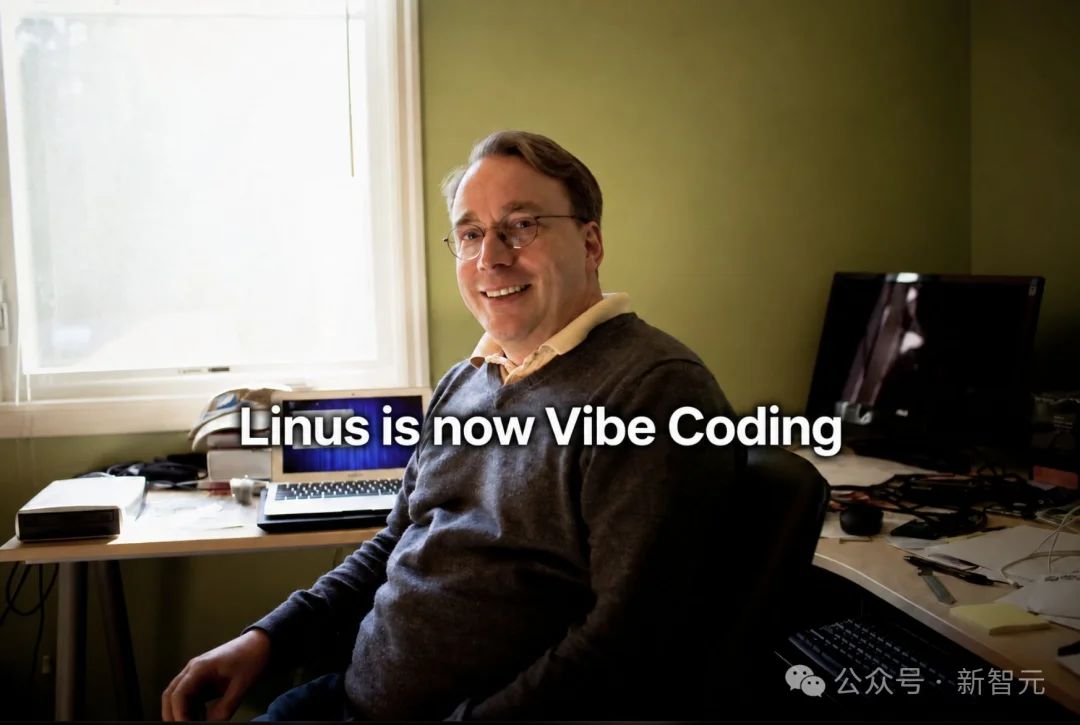
它参与实现方案,编写用于检验方案的程序,还帮助梳理潜在问题。
这些环节连在一起,才像一次完整的工程尝试。写出来的代码要能运行,运行结果要能测量,测到的提升要能解释。
补丁说明也有实际用途。其他维护者需要知道,为什么要改、哪些路径受影响、作者检查过哪些情况。
AI把初稿写出来之后,这份说明仍要和代码、测试数据对得上。
公开到这个程度,后续讨论才有抓手。Linus那句「在我的指导下」,分量就在这里。
吞吐量从1000万,暴涨至 3300 万
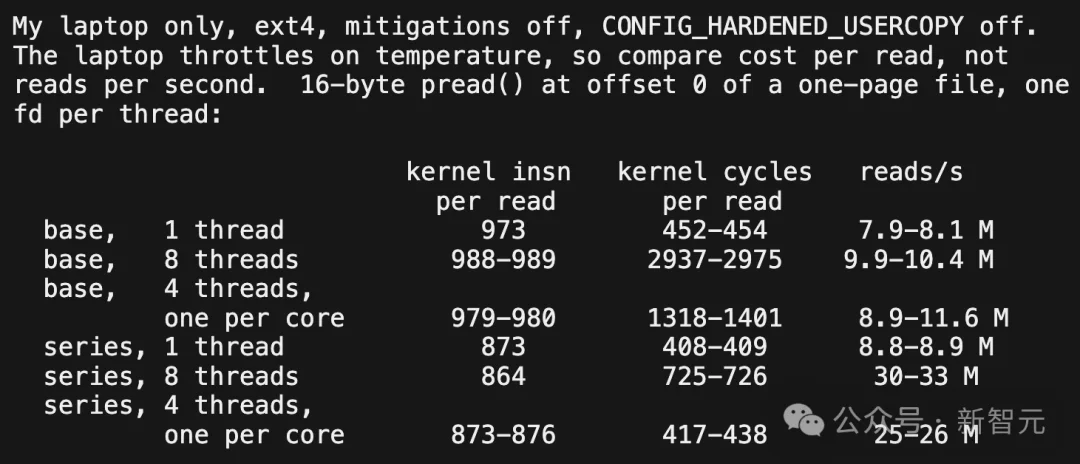
测试中,Linus使用的是一台搭载Core i7-8565U的笔记本,4核8线程,文件系统为ext4。
测试让多个线程反复读取同一个、大小为一页的文件,每次只读16字节。
补丁说明给出的数据如下:
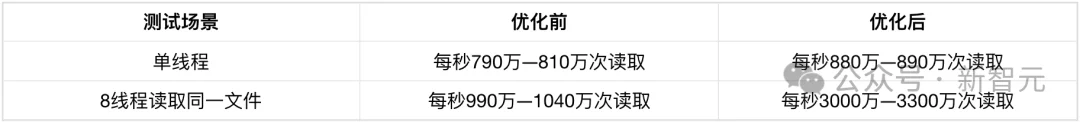
8线程吞吐量约为原来的3倍,单线程的提升约为一成。
差距为什么这么大?关键藏在「大家都读同一个文件」里。
Linux会把文件数据缓存在内存中,这就是页面缓存。后续读取可以直接从缓存取数据,省去再次访问存储设备的时间。
可缓存里的内存也会被回收。内核必须确保:线程还在读取时,这块内存没有被释放、转给其他用途。
原来的读取路径,会给承载缓存数据的内存对象增加引用计数,读完再减回去。这个对象叫folio,可以把它理解为内核管理的一组内存页。
问题是,几个线程一齐读,大家就要反复修改同一个计数。
为了保持数据一致,处理器核心之间得来回传递包含这个计数的缓存行。一次读取只有16字节,读取本身很快,维护计数的开销反倒成了瓶颈。
就像八个人都来翻一本书,每次翻页前后,都得争着修改同一张登记表。
Linus这组补丁,试着省掉读取路径上的这道手续。
它的做法是:缓存中的内存被移除后,延迟一段时间再真正归还给内存分配器,借助RCU机制,让已经开始的相关读取有机会完成。
这样,线程可以在受保护的读取区间内直接复制数据,减少对共享引用计数的争抢。
这也解释了,为什么多线程共享同一文件的测试收益尤其明显。
如果你以为Linus只是让Claude写新代码,那就低估了这件事的分量。
就在noref-filemap-read-with-llm分支出现的第二天,Linus的仓库里又冒出了一个assoc-array-fixes库。
它是一套用于按键组织、查找对象的数据结构。最初的实现,可以追溯到2013年。
就在几天前,开发者Nils Ollrogge提交了一份Bug报告,也提供了修复补丁。
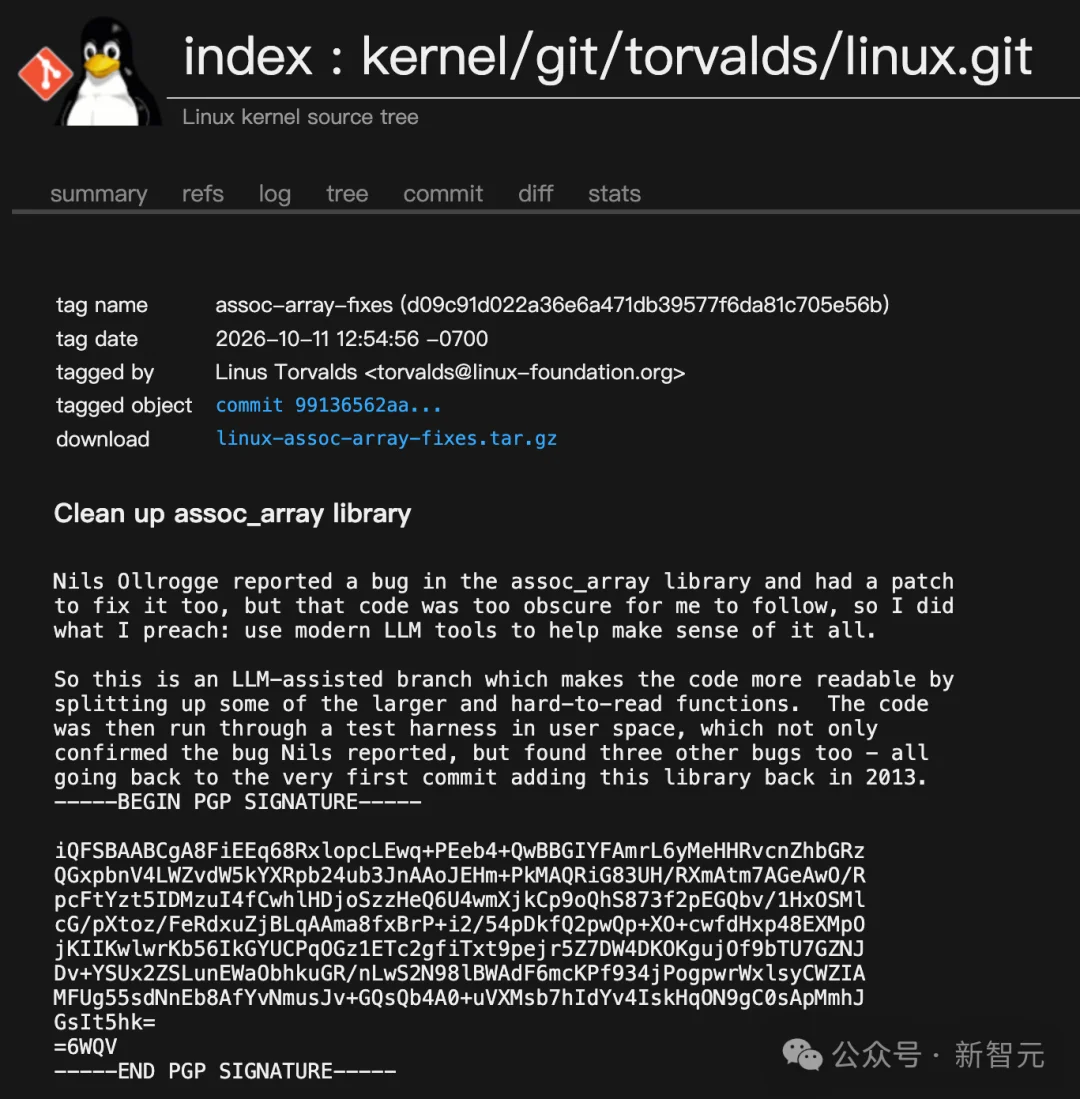
Linus看过之后,却遇到一个麻烦:这段代码过于晦涩,难以跟清逻辑。
于是,他借助大模型梳理代码,把一些庞大、难读的函数拆开,让不同操作的边界更清楚。随后,这些代码被放进用户态测试框架中运行。
测试确认了Nils报告的问题,还额外找出了3个Bug。
所有四个Bug,都可以追溯到2013年这个库第一次被合入内核的那次提交。
谁能想到,一份Bug报告,竟牵出了三处存在十余年的缺陷。
其中一个例子很具体:在某种根节点结构被拆分时,索引使用的位段会错位,导致原先存进去的对象无法再被找到。
补丁说明给出了一个只需18个键就能触发的例子。
操作完成后,其中3个对象查不到;再次插入相同的键,还会新增对象,无法正确替换原有对象。
另一个问题藏在内存分配失败的路径里。
正常运行时,它可能安安静静。一旦某次分配失败,清理逻辑却可能顺着指针走进仍在使用的旧树,触发内核错误检查。
对应测试让操作中的每一次内存分配轮流失败,逐个检查异常分支,才把它暴露出来。
这些发现,让「AI帮忙看代码」有了更具体的含义。
老代码经过拆分和解释,变得更容易追踪;测试再把那些平时很少走到的路径逼出来。
缺陷由此获得了可复现的证据。
Linus Torvalds曾说过一句很经典的话,「Talk is cheap. Show me the code.」
了解他的人都知道,这老哥极度实用主义,向来只看两件事:代价值不值?效果狠不狠?
这一次,他用行动展示了另一种可能——
当代码可以由AI来写,真正值钱的,是知道该写什么代码,以及判断写出来的代码对不对。
那个曾经说「AI 90%是营销」的人,如今在自己的主仓库里挂出了带「llm」后缀的分支。
连祖师爷都在用AI狂刷KPI了,谁还在死守着手敲代码的那点虚荣心?
参考资料:
https://www.phoronix.com/news/Linus-Torvalds-Claude-Code
文章来自于"新智元",作者 "桃子"。


